
Inteligencia artificial para detectar riesgo suicida: qué aporta a la prevención un léxico abierto
Investigadores del MIT, Harvard y el Child Mind Institute usaron GPT-4 Turbo para crear un léxico de 49 factores de riesgo, validado por clínicos, y con él un modelo ligero e interpretable que estimó el riesgo inminente en conversaciones de una línea de crisis. No diagnostica: es una señal de apoyo al consejero humano y aún exige validación clínica.
Contenido de esta página
- ¿Qué hicieron los investigadores del MIT y Harvard?
- ¿Qué tan bien funciona frente a LIWC y a los modelos de caja negra?
- ¿Qué señales pesaron más en el riesgo inminente?
- ¿Por qué importa que el modelo sea ligero e interpretable?
- ¿Qué tiene que ver la economía con un léxico abierto?
- ¿Qué dicen los datos de suicidio en Colombia?
- ¿Se puede usar esta herramienta en Colombia tal como está?
- ¿Qué debería hacer Colombia con este tipo de modelos?
Si usted o alguien cercano está pasando por un momento muy difícil, no tiene que atravesarlo solo. En Colombia puede marcar la Línea 106 desde un celular o un teléfono fijo para recibir escucha y apoyo de profesionales de salud mental; la línea nacional del Ministerio de Salud es gratuita y atiende las 24 horas, todos los días [2]. Donde existe una línea 106 local, la llamada la atiende esa línea [3] y su horario puede ser distinto [14]; la de Bogotá atiende a toda hora, también por WhatsApp en el 300 754 8933 [3]. Si no le contestan, o si hay un peligro inmediato para la vida, llame al 123, la línea única de emergencias nacional [4].
Son las once de la noche y un consejero voluntario de Crisis Text Line, la línea de apoyo por mensajes de texto que atiende gratis y a toda hora en Estados Unidos, recibe un mensaje nuevo. Su protocolo le pide ir por capas: primero, si hay pensamientos suicidas; si los hay, si existe un plan; si hay plan, si la persona tiene cómo llevarlo a cabo; y, por último, si el horizonte es de las próximas 48 horas. Cuando el riesgo parece alto, llama a un supervisor [1].
La escena es ilustrativa, construida con el protocolo que describe el estudio, no con una conversación real. Lo que sí es real es la aritmética del problema: en los conjuntos de validación y prueba del estudio, que conservan la proporción natural de la línea, apenas el 2 % de las conversaciones estaba clasificado como riesgo inminente, frente a un 80 % sin contenido suicida [1]. Encontrar esa conversación entre muchas, a tiempo, es un problema de atención escasa.
Y ahí es donde un equipo del MIT, Harvard y el Child Mind Institute puso a trabajar a la inteligencia artificial de una forma que me parece más interesante que la habitual.
¿Qué hicieron los investigadores del MIT y Harvard?
El estudio de Daniel Low, Satrajit Ghosh, Matthew Nock y colegas, publicado el 24 de septiembre de 2026 en el Journal of Psychopathology and Clinical Science, usó GPT-4 Turbo no para diagnosticar a nadie, sino para redactar un diccionario: el Suicide Risk Lexicon, con palabras y frases asociadas a 49 factores de riesgo conocidos. El autor principal lo depuró, clínicos lo validaron y con ese léxico entrenaron un modelo simple que estima el nivel de riesgo en conversaciones de texto [1].
La fuente de datos fue Crisis Text Line, que entregó 96.723 conversaciones desidentificadas entre 2017 y 2022. Los autores quitaron 2020 y 2021 para no mezclar el efecto de la pandemia y usaron solo los mensajes de quien pedía ayuda, no los del consejero. Tras equilibrar las clases del entrenamiento, la muestra de trabajo quedó en 16.360 conversaciones, agrupadas por los autores en tres niveles: sin contenido suicida, con pensamientos o conductas suicidas sin riesgo inminente, y con riesgo inminente, que incluye plan con horizonte de 48 horas o intervención de servicios de emergencia [1].
La evaluación de base no la hizo una máquina. La hicieron los propios consejeros de la línea durante la conversación, y los autores la agruparon después en esos niveles; y eso define lo que el modelo aprende a predecir: el juicio de un humano entrenado en medio de la crisis [1].
¿Cómo se construye un léxico con ayuda de un modelo de lenguaje?
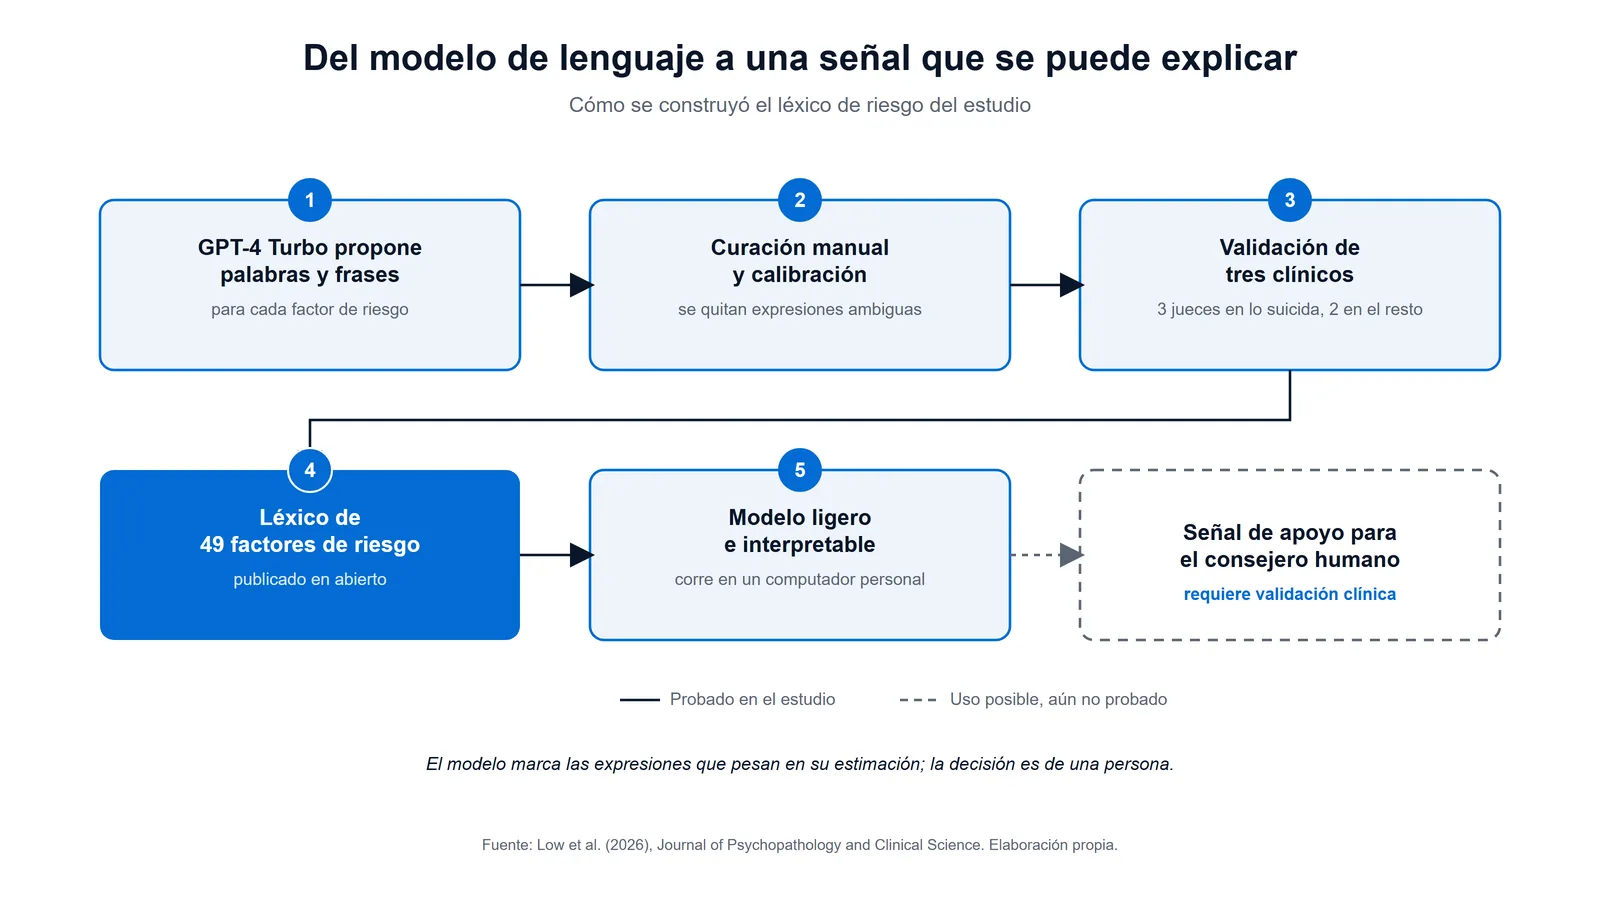
Un léxico es, en el fondo, una lista de expresiones agrupadas por tema; el programa cuenta cuántas veces aparece cada grupo en un texto. Construirlo a mano consume muchos recursos, advierten los autores, y por eso el equipo automatizó buena parte del trabajo en siete pasos que el artículo documenta [1]:
- Reunir los factores de riesgo que la literatura (metaanálisis y revisiones) asocia con ideación, intento o muerte por suicidio, con unos ejemplos semilla por factor.
- Pedirle a GPT-4 Turbo listas de palabras y frases prototípicas para cada factor.
- Añadir expresiones de otras fuentes (análisis estadístico de textos, tesauros, cuestionarios) y quitar las ambiguas.
- Contar coincidencias en los textos, normalizadas por su longitud.
- Calibrar: revisar en contexto falsos positivos y falsos negativos.
- Someter las expresiones al juicio de un psicólogo clínico con licencia y dos clínicos en formación, con 6 a 12 años de experiencia en investigación y evaluación de riesgo suicida: los tres calificaron las de los factores suicidas y dos, las del resto.
- Medir cuánto coincidieron esos jueces entre sí.
El resultado tiene una mediana de 59 expresiones por factor, con un rango de 22 a 173 [1]. El léxico y el paquete de Python que lo genera, construct-tracker, están publicados en GitHub con licencia Apache 2.0 [5].
¿Qué tan bien funciona frente a LIWC y a los modelos de caja negra?
El léxico, depurado por el autor principal y validado por clínicos, superó a LIWC-22, un diccionario de uso extendido en investigación psicológica, pero por poco: los autores escriben que lo hizo modestly, de forma modesta. Frente a los modelos de aprendizaje profundo, el resultado fue mixto: rindió parecido a algunos (performed similarly to some black-box deep learning models) y quedó por debajo de los mejores, que fueron dos redes ajustadas con los datos del propio estudio [1].
La tabla resume las cifras del conjunto de prueba, 5.353 conversaciones que ningún modelo vio al entrenar [1]; el dato de que el léxico se aplica en un computador personal viene de la nota del MIT [8]. Dos métricas: la correlación de Spearman (ρ), que mide si la predicción sube cuando sube la gravedad real (más alto es mejor), y un error promedio por nivel de riesgo (más bajo es mejor).
| Enfoque | ρ de Spearman | Error (RMSE macro) | ¿Explica por qué? | Qué exige |
|---|---|---|---|---|
| LIWC-22, solo categorías semánticas | 0,53 | 0,53 | Sí, pero con validez de contenido baja para este uso | Licencia de pago y código cerrado |
| Léxico generado solo por GPT-4 Turbo, sin curar | 0,53 | 0,57 | Sí, con validez de contenido alta | Consultas a la API solo para crear el léxico |
| Léxico curado + validado por clínicos | 0,57 | 0,50 | Sí, con validez de contenido muy alta | Un computador personal para aplicarlo |
| Vectores de lenguaje preentrenados + regresión | 0,56 | 0,51 | No; validez de contenido desconocida | Un modelo preentrenado, sin ajuste |
| DistilBERT ajustado | 0,59 | 0,43 | No; validez de contenido desconocida | Ajustar una red con datos etiquetados |
| MPNet ajustado | 0,66 | 0,46 | No; validez de contenido desconocida | Ajustar una red; el estudio usó una GPU de 25 GB |
Tres matices que no caben en la tabla. El primero: en la prueba estadística por remuestreo, toda diferencia de ρ mayor a 0,02 resultó significativa; el léxico curado le gana a LIWC con claridad estadística, aunque con un efecto pequeño, y MPNet le gana a todos los léxicos [1]. El segundo: cuando entrenaron con apenas 150 conversaciones, que es la escasez típica de la investigación clínica, los modelos basados en el léxico fueron los mejores [1]. El tercero es de honestidad de los autores: dicen que, cuando es viable, seguirían prefiriendo los grandes modelos de lenguaje para clasificar textos [1]. Y una advertencia que ellos mismos hacen: las diferencias entre modelos son modestas, deben leerse con cautela y valen para este conjunto de datos y esta tarea, no como un ranking general [1].
¿Qué señales pesaron más en el riesgo inminente?
Las expresiones de ideación suicida activa y de planificación, las menciones de medios letales, el resto del lenguaje explícitamente suicida, la autolesión directa y el consumo de sustancias fueron las variables más útiles para predecir riesgo inminente. Todas pesaron más que la ideación pasiva, el ánimo deprimido y la desesperanza, en línea con lo que habían anticipado los autores [1].
Los puestos lo dicen mejor que los adjetivos. De 50 variables, el ánimo deprimido quedó en el puesto 11, la ideación pasiva en el 15 y la desesperanza en el 44 [1]. Un detalle técnico que conviene no perder: esa clasificación viene del modelo con el léxico en su versión sin validación clínica, que es la que reporta la tabla de importancia del artículo.
¿Significa eso que la depresión no importa? No. El hallazgo dice algo más estrecho: cuando la meta es separar el riesgo inminente del resto de los casos con pensamientos suicidas, lo que más informa es si la persona habla de intención y planes, no solo de tristeza. Y predice el juicio del consejero, no conductas observadas; los propios autores advierten que el orden podría cambiar si se predijeran intentos o muertes [1].
Hubo sorpresas. La hospitalización y la agresividad pesaron menos que el ánimo deprimido, y la impulsividad no resultó importante para la predicción, contra lo que esperaba el equipo [1].
Una advertencia necesaria para leer esto bien: ningún factor explica por sí solo una muerte por suicidio. La OMS insiste en que las causas son múltiples —sociales, culturales, biológicas, psicológicas y ambientales— [6], y en Colombia el Instituto Nacional de Salud registra que cada caso de intento notificado puede tener más de un factor de riesgo o desencadenante [7].
¿Por qué importa que el modelo sea ligero e interpretable?
Un modelo ligero e interpretable corre en un computador personal, no envía datos a un servidor externo y muestra qué palabras lo llevaron a su estimación. Esas tres propiedades —interpretabilidad, determinismo y privacidad— son, según los autores, las ventajas reales de un léxico sobre un gran modelo de lenguaje, más que la accesibilidad [1][8].
Una analogía útil es la del termómetro frente al laboratorio. Un laboratorio clínico mide muchas cosas con más precisión, pero cuesta, tarda y exige que la muestra salga de la casa. El termómetro mide una sola cosa, barato, en la mesa de noche, y cualquiera entiende qué significa el número. El léxico es el termómetro: no reemplaza al laboratorio, pero se puede tener en cada consultorio.
La palabra determinismo merece una línea. Si una expresión del léxico aparece en el texto, el sistema la marca siempre; si no aparece, no. Un modelo de caja negra puede detectar más matices, y los autores esperan que los más avanzados capten la mayoría de las expresiones relevantes; pero, sin pruebas adicionales, no se puede garantizar ni verificar que no pasaron por alto una frase concreta [1].
Para un sistema de salud latinoamericano, cada una de esas propiedades tiene precio. Mandar conversaciones de personas en crisis a la API de una empresa extranjera no es un detalle técnico en Colombia: la Ley 1581 de 2012 clasifica los datos relativos a la salud como datos sensibles y prohíbe su tratamiento salvo excepciones, empezando por la autorización explícita del titular [9]. Y, en mi experiencia, pocas secretarías de salud municipales tienen a mano una GPU como la de 25 GB que el estudio usó para ajustar MPNet, la red con mayor correlación, ni el personal técnico para operarla. Un modelo que corre en el portátil del equipo y que un psicólogo puede auditar palabra por palabra baja la barrera de entrada de forma concreta.
Y hay un argumento de gestión. La atención de un consejero es finita, el ejemplo de manual de lo que en economía se estudia como racionalidad acotada. Una herramienta que resalta «estas son las expresiones que me preocuparon» ayuda a decidir a quién atender primero sin pedirle a nadie que confíe a ciegas en una puntuación.
¿Qué tiene que ver la economía con un léxico abierto?
El léxico de riesgo suicida y el paquete construct-tracker se publicaron gratis en GitHub, con licencia Apache 2.0 e instalación con un solo comando [5]. En términos económicos se comportan como un bien público: que un hospital de Pasto lo descargue no le quita nada a uno de Boston (no rival), y nadie queda excluido de usarlo (no excluible).
Eso importa porque los bienes públicos se producen por debajo de lo socialmente deseable cuando dependen del mercado: quien los financia no puede cobrarles a todos los que se benefician. Lo que hizo el equipo es generar una externalidad positiva deliberada. El trabajo caro —la curación y el juicio clínico— queda pagado una vez y disponible para cualquier grupo que quiera construir léxicos para otras condiciones de salud mental, uno de los usos para los que los autores liberaron el paquete [8].
La ley colombiana usa un lenguaje parecido por otra vía. El artículo 3 de la Ley 1616 de 2013 dice que la salud mental «es un bien de interés público» y la declara prioridad nacional [10]. No es el mismo concepto que el bien público de los economistas —uno es una categoría jurídica y el otro una propiedad del bien—, pero apuntan en la misma dirección: la sociedad pierde cuando la salud mental se deja solo en manos privadas.
El costo de no hacer nada tampoco es abstracto. La OMS estima que cada año se pierden en el mundo 12.000 millones de días de trabajo por depresión y ansiedad, con un costo de un billón de dólares (un millón de millones) en productividad [11]. Es solo la parte que se puede contar en plata.
Queda la pregunta de quién decide con la herramienta. Satrajit Ghosh, director de la Iniciativa de Datos Abiertos en Neurociencia del Instituto McGovern, lo dijo sin rodeos en la nota del MIT: «Este es un espacio tan complejo que tener a un humano en el circuito va a ser, creo, crítico durante mucho, mucho tiempo» (traducción propia) [8]. Los investigadores añaden que cualquier modelo predictivo debe validarse a fondo antes de su uso clínico [8].
¿Qué dicen los datos de suicidio en Colombia?
Colombia registró 2.823 muertes por suicidio en 2025, según el boletín preliminar de diciembre del Instituto Nacional de Medicina Legal: 2.209 hombres y 614 mujeres. La cifra es 5,4 % menor que las 2.984 que el mismo boletín registra para 2024; es preliminar, y un año no hace tendencia [12]. En el mundo, la OMS estima 727.000 muertes por suicidio al año, el 73 % en países de ingresos bajos y medianos [6].
Los intentos son mucho más frecuentes que las muertes. En 2025, tras depurar las notificaciones al sistema de vigilancia Sivigila, el Instituto Nacional de Salud dejó 39.139 casos de intento de suicidio para análisis, 1,0 % más que en 2024, con una incidencia nacional cercana a 74 por cada 100.000 habitantes; una misma persona puede aparecer más de una vez en el año, así que son casos y no personas [7]. El 43,4 % de esos casos tenía antecedente de trastorno psiquiátrico, y la ideación suicida persistente es, año tras año, el segundo factor de riesgo más reportado [7].
Colombia no parte de cero en información: el artículo 35 de la Ley 1616 ordena vigilancia epidemiológica de la conducta suicida [10], y el INS la hace desde 2016 [7]. Lo que no encontré, hasta donde pude rastrear, es un léxico público en español colombiano, validado por clínicos, para leer lo que las personas escriben cuando buscan ayuda.
Una nota de método: en esta entrada sigo las pautas de la OMS para informar sobre suicidio, que piden no describir métodos, no usar lenguaje alarmista y dar siempre información sobre dónde buscar ayuda [13].
¿Se puede usar esta herramienta en Colombia tal como está?
No sin trabajo previo. El léxico está en inglés, se construyó con usuarios de una línea de crisis de Estados Unidos y los autores reconocen que no saben cómo se comporta en otros idiomas, culturas o plataformas. El propio artículo señala que la disposición a contar los síntomas, el estigma, las metáforas, el humor y la jerga pueden variar entre culturas y cambiar la forma de expresar el malestar [1].
La población de origen también pesa. Según un estudio previo sobre quienes escriben a Crisis Text Line, que los autores citan para describir a sus usuarios (Pisani y colegas, 2022), entre quienes responden una encuesta demográfica opcional (cerca del 22 %), el 76 % tenía menos de 25 años, el 79 % eran mujeres y el 53 % se identificó como blanco [1]. Traducir las expresiones al español no resuelve el problema: la forma como un joven de Cúcuta cuenta su angustia no es la de una joven de Ohio, ni la de un adulto mayor de Tumaco.
Hay límites técnicos que los autores declaran uno por uno [1]:
- El léxico no entiende el contexto: «me siento un poco triste» y «no puedo dejar de sentirme triste» suman lo mismo, y quien expresa su malestar con matices o restándole importancia puede recibir una puntuación inflada, aunque su gravedad real sea menor.
- El acuerdo entre los clínicos que validaron las expresiones fue apenas regular: una correlación intraclase de 0,48 entre los tres jueces de los factores suicidas y un acuerdo absoluto de 0,54 entre los dos jueces del resto.
- La curación manual la hizo una sola persona.
- El estudio no se registró por adelantado.
- La evidencia es de validez de contenido y de predicción del juicio del consejero, no de conductas reales.
Un dato de rigor que el lector merece: el artículo declara las fuentes de financiamiento (subvenciones de los Institutos Nacionales de Salud de EE. UU., becas y donaciones a centros de Harvard y del MIT, sin papel en el diseño ni en el análisis) y conflictos de interés de algunos autores, entre ellos consultorías para empresas tecnológicas y en casos legales relacionados con muertes por suicidio, empleo y acciones de una coautora en una empresa de salud mental digital, y participaciones en otras compañías del sector [1].
Y un límite que no es técnico sino ético: esta herramienta no sirve para vigilar a familiares, estudiantes ni empleados. No diagnostica ni dice quién va a morir. Es un instrumento de investigación pensado para apoyar a profesionales dentro de un servicio de atención, con consentimiento y bajo las reglas de protección de datos.
¿Qué debería hacer Colombia con este tipo de modelos?
Aquí tomo partido, y es opinión: la noticia no es que una IA «detecte» riesgo suicida, sino que un equipo mostró cómo convertir un modelo de lenguaje costoso en un bien público barato, auditable y que corre en un portátil. Esa receta es la que América Latina debería copiar, no el léxico en inglés.
Tres apuestas concretas. Primera: un léxico en español colombiano construido con el mismo protocolo abierto, validado por clínicos de las líneas de salud mental que ya operan en el país y por universidades regionales, con variantes para los distintos territorios. Segunda: reglas de datos claras antes que pilotos entusiastas; la Ley 1581 admite el tratamiento de datos sensibles con finalidad científica, pero exige medidas para suprimir la identidad de los titulares [9]. Tercera: el humano en el circuito como regla, no como adorno, porque una señal que nadie revisa es solo otra alarma que se ignora.
Si esto le interesa desde la gestión, en la entrada sobre cómo llevar un piloto de IA generativa a resultados medibles planteo por qué medir antes de escalar, y en la página sobre transformación digital de la economía explico por qué la tecnología sin capacidades locales tiende a quedarse en demostración.
Quien gana con un léxico abierto y validado en español es el consejero de una línea pública en una ciudad intermedia, que no tendrá nunca el presupuesto de un hospital de Boston. Quien pierde, si no lo hacemos, es la persona que escribe a las once de la noche y cuyo mensaje queda en la fila equivocada. La pregunta para Colombia ya no es si la inteligencia artificial puede leer riesgo en un texto, sino quién va a pagar el trabajo de enseñarle a leer nuestro español.
Si necesita hablar con alguien ahora: Línea 106 (la nacional es gratuita; la nacional y la de Bogotá atienden 24 horas; alguna línea 106 local tiene otro horario) [2][3][14]; en Bogotá, también por WhatsApp al 300 754 8933 [3]; si no le contestan o hay un peligro inmediato, 123 [4]. Este blog no es un servicio de atención en crisis, y el botón de contacto por WhatsApp que aparece al pie de esta entrada es un canal para escribirle al autor: no sustituye esas líneas.
Preguntas frecuentes
¿La inteligencia artificial puede predecir quién va a morir por suicidio? No. El estudio predice la valoración que hizo un consejero durante una conversación de crisis, no conductas futuras. Los autores advierten que su evidencia no incluye intentos ni muertes observadas y que cualquier modelo debe pasar por una validación clínica rigurosa antes de usarse con pacientes.
¿Qué es un léxico en procesamiento de lenguaje natural? Es una lista de palabras y frases organizadas por categorías, que un programa busca y cuenta dentro de un documento. A diferencia de una red neuronal, su lógica es transparente: cualquier persona puede abrir la lista, ver qué expresiones incluye y discutir si deberían estar ahí.
¿Puedo descargar y usar el léxico de riesgo suicida? Sí. Los autores lo liberaron junto con el paquete construct-tracker en GitHub, con licencia abierta Apache 2.0, que no restringe su uso. Otra cosa es la prudencia: aplicarlo con personas reales exige un protocolo aprobado, profesionales de salud mental a cargo, protección de datos y una validación en el idioma y la población donde se aplique.
¿Sirve este modelo para textos en español? Todavía no. Fue construido y probado en inglés con usuarios de un servicio estadounidense. Para usarlo en Colombia habría que crear un léxico propio en español, con expresiones locales, y medir de nuevo su desempeño con datos colombianos y con el juicio de clínicos del país.
¿Por qué los investigadores no usaron directamente ChatGPT para clasificar las conversaciones? El artículo da razones generales, no una justificación específica de este diseño: muchos conjuntos de datos sensibles, como el de la línea de crisis, no pueden enviarse a un servicio externo, y un gran modelo no garantiza qué frases detectó ni explica de forma verificable su resultado. Usaron GPT-4 Turbo solo en la etapa de redactar el borrador del léxico y dejaron la predicción a un modelo pequeño y auditable.
Referencias
- Low, D. M.; Rankin, O.; Coppersmith, D. D. L.; Bentley, K. H.; Nock, M. K. y Ghosh, S. S. (2026). Using Large Language Models to Create Lexicons for Interpretable Text Models With High Content Validity: The Suicide Risk Lexicon. Journal of Psychopathology and Clinical Science, publicación anticipada en línea (Online First), aún sin volumen — protocolo de Crisis Text Line, datos (96.723 conversaciones, muestra de 16.360, prueba de 5.353), tabla de desempeño, importancia de variables, limitaciones, financiamiento y conflictos de interés. APA: Low et al. 2026, DOI 10.1037/abn0001152 — Consultada: 2026-09-24.
- Ministerio de Salud y Protección Social. Línea 106 — servicio de orientación en salud mental, gratuito, confidencial, 24/7, desde fijo o celular. MinSalud: Línea 106 — Consultada: 2026-09-24.
- Secretaría Distrital de Salud de Bogotá. Líneas de atención para el cuidado de la salud mental — Línea 106 de Bogotá, teléfono 106 y WhatsApp 300 754 8933, 24 horas, 7 días. Secretaría de Salud de Bogotá: líneas de atención en salud mental — Consultada: 2026-09-24.
- Departamento Administrativo de la Función Pública. Línea única de emergencias Nacional 123 — número gratuito para todos los servicios de emergencia, 24 horas, todos los días. Función Pública: línea de emergencias 123 — Consultada: 2026-09-24.
- Low, D. M. construct-tracker (repositorio de software) — paquete de Python y Suicide Risk Lexicon en CSV y JSON, licencia Apache 2.0, instalación con pip. GitHub: danielmlow/construct-tracker — Consultada: 2026-09-24.
- Organización Mundial de la Salud. Suicidio. Nota descriptiva (25 de marzo de 2025) — 727.000 muertes al año, 73 % en países de ingresos bajos y medianos (2021), causas múltiples. OMS: nota descriptiva sobre suicidio — Consultada: 2026-09-24.
- Instituto Nacional de Salud. Informe de evento. Código 356 · Intento de suicidio, 2025 (1 de julio de 2026) — 39.139 casos para análisis, incidencia de 73,77 por 100.000 en el texto del informe (73,71 en su anexo), 43,4 % con antecedente de trastorno psiquiátrico, más de un factor de riesgo o desencadenante por caso, vigilancia desde 2016. INS: informe de evento intento de suicidio 2025 — Consultada: 2026-09-24.
- Michalowski, J. / MIT News, McGovern Institute for Brain Research. Estimating suicide risk from text (24 de septiembre de 2026) — modelo ligero que corre en un computador personal, cita de Satrajit Ghosh, validación antes del uso clínico, liberación del léxico y del software. MIT News: nota sobre el léxico de riesgo suicida — Consultada: 2026-09-24.
- Congreso de Colombia. Ley Estatutaria 1581 de 2012, arts. 5 y 6 — los datos relativos a la salud son datos sensibles; su tratamiento está prohibido salvo excepciones, como la autorización explícita del titular o la finalidad científica con supresión de identidad. Función Pública: Ley 1581 de 2012 — Consultada: 2026-09-24.
- Congreso de Colombia. Ley 1616 de 2013, arts. 3 y 35 — la salud mental como bien de interés público y prioridad nacional; vigilancia epidemiológica de la conducta suicida. Función Pública: Ley 1616 de 2013 — Consultada: 2026-09-24.
- Organización Mundial de la Salud. La salud mental en el trabajo. Nota descriptiva (2 de septiembre de 2024) — 12.000 millones de días de trabajo perdidos al año por depresión y ansiedad, con un costo de US$ 1 billón en productividad. OMS: salud mental en el trabajo — Consultada: 2026-09-24.
- Instituto Nacional de Medicina Legal y Ciencias Forenses. Boletín estadístico mensual, diciembre 2025 (cifras preliminares), cuadros 1.1 y 1.4 — 2.823 muertes por suicidio en 2025 (2.209 hombres, 614 mujeres) frente a 2.984 en 2024. Medicina Legal: boletín estadístico de diciembre de 2025 — Consultada: 2026-09-24.
- Organización Mundial de la Salud y Asociación Internacional para la Prevención del Suicidio. Preventing suicide: a resource for media professionals, update 2023 — pautas para informar con responsabilidad: no describir métodos, no usar lenguaje sensacionalista, informar dónde buscar ayuda. OMS: guía para profesionales de los medios, 2023 — Consultada: 2026-09-24.
- Ministerio de Salud y Protección Social. Directorio nacional de líneas territoriales de atención en salud mental en Colombia (agosto de 2025) — las líneas 106 locales tienen horarios propios; por ejemplo, la Línea 106 Departamental de Caldas atiende de lunes a viernes de 8:00 a. m. a 5:00 p. m. MinSalud: directorio nacional de líneas de salud mental, 2025 — Consultada: 2026-09-24.
Cómo investigamos esta página
- Pregunta que responde: qué hizo el estudio del MIT y Harvard, qué tan bien funciona y qué significa para Colombia
- Fuentes: identificadas 131 → incluidas 13
- Criterios de inclusión: paper con DOI, MIT, OMS y entidades públicas colombianas; sin prensa ni detalles de métodos
- Fecha de corte de los datos: 2026-09-24