
¿Qué es la ciencia de datos?
La ciencia de datos es la disciplina que convierte datos en conocimiento para decidir mejor: une estadística, programación y conocimiento del área para plantear una pregunta, conseguir y limpiar datos, modelarlos y comunicar el resultado. Aquí verá su origen, su ciclo de vida, las disciplinas que la forman y tres usos reales en Colombia.
Última actualización: 2026-10-09
Contenido de esta página
- ¿Qué es la ciencia de datos?
- Dato, información y conocimiento: ¿con qué trabaja la ciencia de datos?
- ¿Cuál es el ciclo de vida de la ciencia de datos?
- ¿Qué disciplinas componen la ciencia de datos?
- ¿Para qué sirve la ciencia de datos? Tres ejemplos en Colombia
- Ciencia de datos por temas: qué guía leer según su pregunta
- ¿Qué no puede hacer la ciencia de datos?
Escena compuesta, con nombre ficticio: Marcela trabaja en la oficina de planeación de un municipio de la provincia de García Rovira, en Santander. Le pidieron escoger las veredas donde arrancará un programa de mejoramiento de vivienda, y el presupuesto alcanza para pocas. Busca la pobreza en las cifras del censo y se topa con un vacío. El detalle por manzana existe para la cabecera municipal, el casco urbano; para las zonas rurales no hay una medida igual de fina [1].
Su pregunta es sencilla. ¿Dónde vive la gente que más lo necesita?
Lo que le falta no es un programa de computador. Le falta un método para sacar una respuesta confiable de datos incompletos y para saber cuánto creerle. Ese método se llama ciencia de datos: usar datos, estadística y programación para pasar de una pregunta a una decisión. En Colombia ya se ha ensayado para un problema como el de Marcela. El DANE (Departamento Administrativo Nacional de Estadística, la entidad que produce las cifras oficiales del país) probó estimar la pobreza con imágenes de satélite, justo para alumbrar esos huecos rurales [1].
¿Qué es la ciencia de datos?
La ciencia de datos es la disciplina que saca conocimiento útil directamente de los datos, ya sea explorándolos en busca de patrones o poniendo a prueba una hipótesis [2]. Reúne tres saberes: las matemáticas y la estadística, la programación y la ingeniería de sistemas, y el conocimiento del tema que se estudia [2]. Su producto final es una decisión mejor informada.
Una definición formal viene del NIST (Instituto Nacional de Estándares y Tecnología, el organismo de Estados Unidos que fija estándares técnicos). Su grupo de trabajo sobre big data, es decir, datos tan grandes o tan rápidos que exigen muchas máquinas a la vez, publicó un volumen de definiciones [2]. Allí describe la ciencia de datos como una metodología para sintetizar conocimiento útil a partir de los datos, por descubrimiento o formulando y probando hipótesis [2].
El estadístico David Donoho lo dijo más corto en su ensayo 50 years of Data Science, de 2015. Para él, es «la ciencia de aprender de los datos» (traducción propia) [3].
Conviene separar la disciplina del oficio. Qué hace un científico de datos, cuánto gana en Colombia y cómo se llega a serlo son temas de la guía de rutas y carreras en datos, que está en preparación.
¿De dónde viene la ciencia de datos?
La idea es más vieja que el nombre. En 1962 el estadístico John Tukey publicó The Future of Data Analysis, un artículo que sacudió a su gremio [3]. Allí defendió que el análisis de datos era una ciencia propia, «definida por un problema ubicuo y no por un tema concreto» [3]. Ubicuo quiere decir que aparece en todas partes: en la medicina, en la economía, en el campo.
El nombre llegó después. En 2001, William Cleveland propuso un plan para ampliar la estadística y lo tituló con las palabras «Data Science» [3]. Donoho considera que ese texto quizá sea el primero que usa el término en su sentido moderno, aunque reconoce un uso anterior de Jeff Wu [3].
Ese mismo año, Leo Breiman describió dos culturas en el trabajo con datos [3]. Una construye modelos para explicar cómo se generaron los datos. La otra se concentra en predecir bien, y Breiman ubicó su epicentro en el aprendizaje automático [3].
Jim Gray le dio otra lectura en 2007: llamó a la ciencia basada en datos el cuarto paradigma de la ciencia, después del experimento, la teoría y la simulación por computador [2].
Dato, información y conocimiento: ¿con qué trabaja la ciencia de datos?
Un dato es un registro suelto: un número, una fecha, un nombre. Se vuelve información cuando alguien lo limpia y lo ordena con su contexto. Se vuelve conocimiento cuando un análisis lo resume en algo que permite actuar. El NIST describe ese recorrido como el paso de datos crudos a información organizada, y de ahí a conocimiento sintetizado [2].
Un ejemplo colombiano lo aterriza. El portal datos.gov.co es el sitio donde las entidades públicas colombianas publican sus datos en formato abierto, para que cualquiera los use [4]. Allí, una cifra cualquiera de un contrato, sola, no dice nada. Cuando aparece en una fila junto a la entidad que contrató, la fecha de firma, la modalidad y el proveedor, ya es información sobre un contrato público [5]. Y cuando miles de filas muestran qué parte de la plata de un departamento se adjudicó por contratación directa, eso ya es conocimiento que puede llevar a una pregunta incómoda.
Los datos llegan en formas distintas. Los estructurados viven en filas y columnas, como una hoja de cálculo [4]. Los no estructurados son textos, fotos, videos o audios [4]. En medio están formatos como JSON, un texto con etiquetas que usan las aplicaciones web para intercambiar datos [4]. Si quiere saber dónde y cómo se guardan todos ellos, siga con la guía de bases de datos.
¿Cuál es el ciclo de vida de la ciencia de datos?
El ciclo de vida de la ciencia de datos es la secuencia de pasos que lleva de una pregunta a una decisión. Esta guía lo ordena en seis etapas: pregunta, obtención, preparación, modelado, comunicación y decisión. No es una fila india. En la práctica uno avanza, descubre un problema y se devuelve a una etapa anterior: al modelar se descubre que los datos necesitan más preparación, y al comunicar los resultados aparece una pregunta mejor. Además, cada decisión abre preguntas nuevas, y el ciclo vuelve a empezar.
El NIST propone cinco pasos para el ciclo completo: captura, preparación, análisis, visualización y acción [2]. También aclara que todo el proceso lo guía una necesidad de la organización [2]. Por eso aquí la pregunta aparece como primera etapa explícita. Existe además, desde 2000, un modelo de proceso muy usado: CRISP-DM (un estándar de pasos para proyectos de minería de datos), que un consorcio creó para unificar la manera de trabajar [2].
- Pregunta. Se define qué decisión se quiere mejorar y qué tendría que mostrar el análisis para cambiarla. Sin pregunta, los datos se acumulan sin rumbo.
- Obtención. Se consiguen los datos: se descargan de un portal abierto, se piden a una base de datos con SQL (el lenguaje para hacerle consultas a una base de datos) o se recogen con encuestas y sensores.
- Preparación. Se revisan, se limpian y se transforman. Donoho la considera más importante que el modelado si se mide por el tiempo que le dedican quienes trabajan con datos [3].
- Modelado. Se aplica un modelo estadístico o de machine learning (aprendizaje automático: programas que aprenden de ejemplos) para describir, explicar o predecir.
- Comunicación. El resultado se convierte en gráficos, tableros o un informe que entienda quien decide, con una idea clara de cuánta incertidumbre trae.
- Decisión. Alguien actúa con lo aprendido. El NIST llama a este paso acción: usar el conocimiento obtenido para generar valor [2].
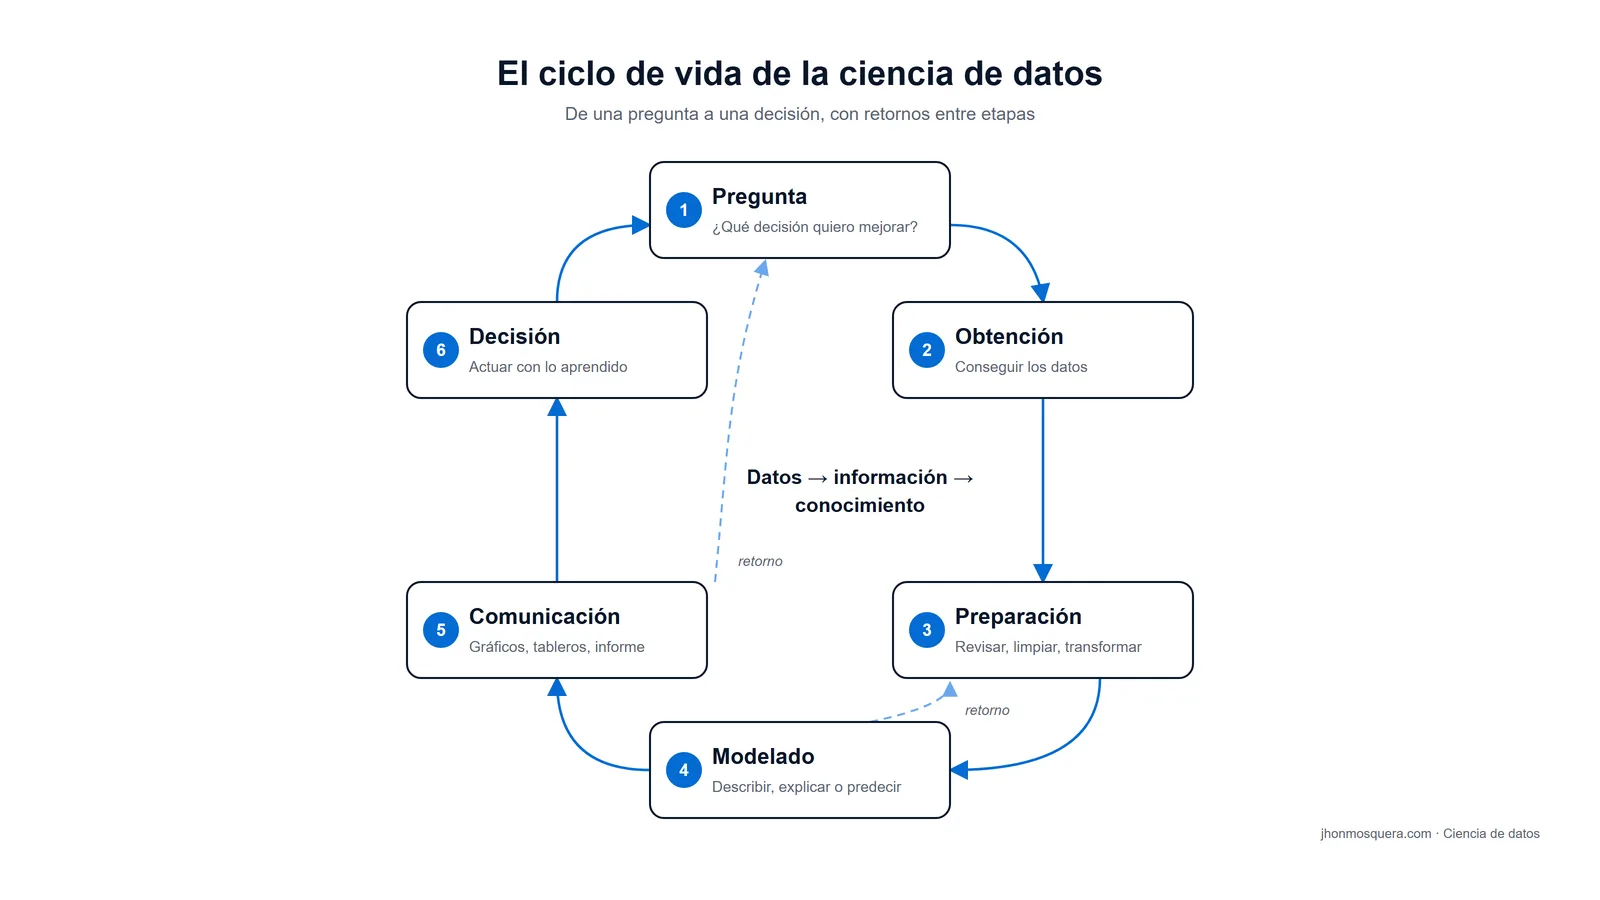
Dos advertencias sobre el ciclo. La etapa de modelado es la que más se enseña, pero no la que más tiempo consume [3]. Y el ciclo no termina en el gráfico: si nadie decide distinto después del análisis, el trabajo se quedó a mitad de camino.
¿Qué disciplinas componen la ciencia de datos?
La ciencia de datos combina disciplinas que ya existían. La estadística dice cuánto confiar en una conclusión; la computación permite guardar y procesar los datos; el aprendizaje automático construye modelos que predicen. La visualización comunica, y el conocimiento del tema da sentido a la pregunta. Ninguna basta sola: el valor aparece cuando se articulan.
Donoho organizó ese territorio en seis divisiones, que llamó en conjunto Greater Data Science (ciencia de datos en sentido amplio) [3]. La tabla las resume y señala dónde profundizar en cada una.
| División según Donoho | Qué hace | Dónde profundizar |
|---|---|---|
| Exploración y preparación | Revisa los datos para conocer sus propiedades y los limpia de errores y anomalías | Análisis de datos |
| Representación y transformación | Lleva los datos a formatos útiles: archivos de texto, hojas de cálculo, bases SQL y NoSQL, flujos en vivo | Bases de datos y SQL |
| Computación con datos | Usa lenguajes como R y Python y documenta flujos de trabajo que otros pueden repetir | Python para análisis de datos (próximamente) |
| Modelado | Combina modelos estadísticos que explican y modelos que predicen | Estadística (próximamente) y Machine learning |
| Visualización y presentación | Convierte resultados en gráficos y tableros que se entienden | Visualización de datos (próximamente) |
| Ciencia sobre la ciencia de datos | Estudia con evidencia qué métodos y flujos de trabajo funcionan mejor | Sin guía propia por ahora |
Las divisiones se necesitan entre sí. Un modelo brillante sobre datos mal preparados produce errores con apariencia de rigor. Donoho anota que, en la práctica, cada científico de datos usa herramientas y puntos de vista de las dos culturas de Breiman, la que explica y la que predice [3].
Rara vez una sola persona domina todo. El NIST anota que esas habilidades pueden repartirse entre los miembros de un equipo, siempre que cada quien entienda lo suficiente de las demás para trabajar junto [2].
Hay piezas que no son técnicas. Según el NIST, el ciclo completo incluye también políticas y regulación, gobierno de los datos, seguridad y la decisión de cuándo destruirlos [2]. Esa parte tendrá su propia guía, gobierno de datos, que está en preparación.
¿Para qué sirve la ciencia de datos? Tres ejemplos en Colombia
La ciencia de datos sirve para contestar preguntas que antes eran demasiado caras, lentas o imposibles de responder. Por ejemplo, dónde está la pobreza entre un censo y otro, cómo se gasta la plata pública o qué tanto aprovechan las empresas sus propios datos. Los tres casos que siguen son colombianos, tienen fuente oficial y muestran tanto el alcance como los límites.
Ejemplo 1: el DANE estima la pobreza con imágenes de satélite
El Índice de Pobreza Multidimensional, o IPM, mide carencias de los hogares en educación, niñez y juventud, trabajo, salud, y vivienda y servicios públicos [1]. El DANE publicó el IPM calculado con el censo por municipio y, en las cabeceras municipales, por manzana [1]. Para las zonas rurales quería una medida igual de fina y una forma de tenerla entre un censo y el siguiente [1].
El equipo probó varias rutas. En la más novedosa usó redes neuronales, programas que aprenden a reconocer patrones en imágenes, compartidas por la alianza internacional PARIS21 [1]. Con ellas extrajo 512 variables de imágenes satelitales de 2018, ubicadas en 77.979 puntos del territorio [1]. Luego resumió esas variables, las repartió entre las zonas del marco geográfico del DANE y entrenó modelos para predecir el IPM [1].
El resultado fue útil, pero parcial. El modelo elegido explicó el 52,9 % de la variabilidad del IPM usando solo lo que se ve desde el espacio [1]. Dicho de otro modo, casi la mitad de la variación del indicador quedó sin explicar. El DANE presenta este tipo de trabajo como estadística experimental, la que «se deriva de proyectos en desarrollo que cuentan con aspectos innovadores» [6].
Hay un detalle que importa para Marcela y para cualquier alcaldía. Salvo el censo, todos los insumos del ejercicio son públicos, y el DANE anota que cualquier persona puede descargarlos y obtener resultados similares [1]. El obstáculo que señala es la calidad de las imágenes, que depende de la nubosidad y de cuántos metros cubre cada píxel [1].
Ejemplo 2: datos.gov.co y los contratos del Estado
El portal datos.gov.co lo administra el MinTIC (Ministerio de Tecnologías de la Información y las Comunicaciones) [4]. Uno de sus conjuntos de datos es SECOP II – Contratos Electrónicos, que publica Colombia Compra Eficiente, la agencia nacional de contratación pública [5]. Reúne los contratos registrados en el SECOP II, la plataforma electrónica de compras públicas, desde su lanzamiento [5]. Cada fila trae la entidad, el departamento, la modalidad de contratación, el proveedor, si este es una pyme y el valor del contrato [5].
Con esa tabla, una veeduría ciudadana (un grupo de personas que vigila la gestión pública) puede recorrer el ciclo completo. Su pregunta podría ser qué parte de la contratación de su departamento se hizo de forma directa. Descarga los datos, los filtra, unifica los nombres de proveedores escritos de varias formas, calcula y grafica. La decisión final ya no es técnica. Puede ser pedir explicaciones, publicar un informe o cerrar el caso.
Ejemplo 3: cuántas empresas colombianas analizan sus datos
El DANE y el MinTIC hacen la ENTIC Empresas, la encuesta sobre el uso de tecnologías de la información y las comunicaciones en las empresas [4]. Su boletín con datos de 2020 investigó 21.630 empresas de industria, comercio y servicios [4]. Solo incluye empresas que superan ciertos umbrales de personal o de ingresos, así que no es una foto de todo el tejido empresarial [4]. El boletín se publicó el 16 de diciembre de 2022 [4].
| Sector (2020) | Empresas con procesos de analítica de datos (%) | Empresas con analítica basada en datos masivos (%) |
|---|---|---|
| Industria | 10,2 | 5,7 |
| Comercio | 9,0 | 5,1 |
| Desarrollo de sistemas informáticos y procesamiento de datos | 47,2 | 32,3 |
| Actividades administrativas y de apoyo de oficina | 43,5 | 29,9 |
Fuente: DANE, ENTIC Empresas 2020 [4].
En la industria, una de cada diez empresas hacía analítica de datos en 2020 [4]. Entre las industriales que no la hacían, el 53,8 % respondió que su actividad no la requiere [4]. El 52,6 % dijo que no contaba con presupuesto y el 48,2 %, que no tenía personal capacitado para hacerla [4]. Y entre las que sí la hacían, apenas el 13,1 % usó conjuntos de datos abiertos del sector público [4].
Las respuestas apuntan a varios frenos a la vez, entre ellos la percepción de que no hace falta, la falta de presupuesto y la falta de gente que sepa hacerlo. El último es el que más me interesa, porque depende de formar gente, y eso está al alcance de universidades y gremios regionales.
Ciencia de datos por temas: qué guía leer según su pregunta
La ciencia de datos se aprende mejor por preguntas que por herramientas. Este sitio la organiza en trece temas: el análisis de datos, que es la puerta de entrada, y doce guías especializadas. La tabla le dice cuál leer según lo que necesite resolver. Cuatro ya están publicadas; las demás aparecen como próximas.
| Si su pregunta es… | Guía | Estado |
|---|---|---|
| ¿Qué es analizar datos y cómo se hace paso a paso? | Análisis de datos | Publicada |
| ¿Dónde y cómo se guardan los datos? | Bases de datos | Publicada |
| ¿Cómo le pido datos a una base de datos? | SQL | Publicada |
| ¿Cómo limpio y analizo datos programando? | Python para análisis de datos | Próximamente |
| ¿Cómo analizo datos con la hoja de cálculo que ya tengo? | Excel para análisis de datos | Próximamente |
| ¿Cuánto puedo confiar en una conclusión? | Estadística para ciencia de datos | Próximamente |
| ¿Cómo muestro los datos para que alguien decida? | Visualización de datos | Próximamente |
| ¿Cómo llevo los datos de un sistema a otro sin hacerlo a mano? | Ingeniería de datos | Próximamente |
| ¿Qué hago cuando los datos no caben en un solo computador? | Big data | Próximamente |
| ¿Cómo le enseño a un programa a predecir? | Machine learning | Publicada |
| ¿Cómo hago que mi código sea eficiente cuando los datos crecen? | Estructuras de datos y algoritmos | Próximamente |
| ¿A qué rol quiero llegar y por dónde empiezo? | Rutas y carreras en datos | Próximamente |
| ¿Quién responde por la calidad, la privacidad y la ética de los datos? | Gobierno de datos | Próximamente |
Si es su primer contacto con el tema, le recomiendo este orden: análisis de datos, luego bases de datos y después SQL. Esas tres guías sostienen casi cualquier trabajo con datos que vaya a hacer después.
¿Qué no puede hacer la ciencia de datos?
La ciencia de datos no convierte datos malos en respuestas buenas, ni vuelve representativos los datos de quienes no aparecen. El NIST lo ilustra con las redes sociales: analizarlas no describe a toda la población, porque no todo el mundo las usa [2]. Y recuerda una regla vieja: no se pueden esperar resultados exactos a partir de datos inexactos [2].
Otro límite es la privacidad. Al cruzar varias bases de datos que por separado parecían inofensivas, a veces se puede identificar a una persona. El NIST llama a esto efecto mosaico [2].
Vuelvo a Marcela. Opino que la ciencia de datos se juega menos en los laboratorios de las grandes empresas que en oficinas como la suya. Las herramientas de entrada son gratuitas: Python y R no cuestan nada, y descargar de datos.gov.co tampoco. Lo escaso es la gente con método, y en la encuesta del DANE casi la mitad de las empresas industriales que no hacían analítica lo señaló como una razón [4].
Si esa capacidad no llega a los municipios pequeños, las decisiones se seguirán tomando con lupa en las ciudades y a ojo en las veredas. La pregunta para Marcela, y para usted, no es qué herramienta comprar. Es qué pregunta le va a hacer a sus datos esta semana, y cómo va a saber si la respuesta merece confianza.
Preguntas frecuentes
¿En qué se diferencia la ciencia de datos del análisis de datos? El análisis de datos es un paso dentro del ciclo: el que examina los datos ya preparados para encontrar patrones y responder preguntas. La ciencia de datos abarca el recorrido entero, desde plantear la pregunta y conseguir los datos hasta llevar el resultado a una decisión, y por eso contiene al análisis como una de sus etapas [2]. Los tipos de análisis y su proceso, explicados en detalle, están en la guía de análisis de datos.
¿Ciencia de datos y big data son lo mismo? No. Big data nombra conjuntos de datos tan grandes, rápidos o variados que exigen repartir el almacenamiento y el cálculo entre muchas máquinas [2]. La ciencia de datos es el método para aprender de los datos, sean grandes o pequeños. Donoho rechaza que el tamaño de los datos sirva para separar la ciencia de datos de la estadística: los censos, de una escala parecida, existen hace más de dos siglos [3]. La comparación completa entre big data, ciencia de datos y analítica estará en la guía de big data, en preparación.
¿El machine learning es lo mismo que la ciencia de datos? No: es una de sus piezas. El machine learning construye modelos que aprenden de ejemplos para predecir, y Breiman lo ubicó en el centro de la cultura que prioriza la predicción [3]. La ciencia de datos lo usa en la etapa de modelado, al lado de los modelos estadísticos que buscan entender cómo se generaron los datos [3]. Tipos de aprendizaje, algoritmos y evaluación de modelos se desarrollan en la guía de machine learning.
¿Qué diferencia hay entre estadística y ciencia de datos? La estadística aporta el razonamiento para decidir cuánto confiar en una conclusión: muestreo, inferencia y pruebas de hipótesis. La ciencia de datos la incorpora y le suma programación, manejo de bases de datos y comunicación. En 2015, Donoho describía la ciencia de datos que se promovía entonces como un conjunto que abarca la estadística y el aprendizaje automático, más tecnología para escalar a grandes volúmenes [3]. La estadística como disciplina tendrá su propia guía, estadística para ciencia de datos, en preparación.
¿En qué se diferencia la inteligencia de negocios de la ciencia de datos? La inteligencia de negocios, conocida como BI por su nombre en inglés, ordena los datos de una organización en reportes y tableros para seguir lo que ya pasó. Trabaja sobre todo la pregunta «¿qué sucedió?», que el DANE asocia con la analítica descriptiva [4]. La ciencia de datos también mira hacia adelante, con modelos que predicen o recomiendan. Herramientas como Power BI y el diseño de tableros se tratarán en la guía de visualización de datos, en preparación.
¿Cuál es la diferencia entre ingeniería de datos y ciencia de datos? La ingeniería de datos construye y mantiene las tuberías: los sistemas que capturan, transforman y entregan los datos listos para analizar. El NIST describe a los ingenieros de datos como especialistas que transforman los datos para prepararlos para la analítica [2]. La ciencia de datos usa esos datos para responder preguntas y orientar decisiones. Son oficios vecinos que se necesitan. La comparación desarrollada estará en la guía de ingeniería de datos, en preparación.
Referencias
- DANE. Predicción del IPM con imágenes satelitales (presentación técnica de estadística experimental, sin fecha impresa) — IPM censal publicado por municipio y por manzana en cabeceras; interés en medir zonas rurales y periodos intercensales; dimensiones del IPM; redes neuronales convolucionales compartidas por PARIS21; 512 covariables en 77.979 centroides de imágenes de 2018; modelo GBTR con simulación de Montecarlo que explica el 52,9 % de la variabilidad; insumos públicos salvo el censo y limitación por calidad de imágenes. DANE: presentación Predicción del IPM con imágenes satelitales — Consultada: 2026-10-09.
- NIST Big Data Public Working Group. NIST Big Data Interoperability Framework: Volume 1, Definitions (Special Publication 1500-1r2, versión 3, octubre de 2019) — definición de ciencia de datos; subdisciplinas (conocimiento del dominio, estadística y aprendizaje automático, ingeniería de software y sistemas); ciclo de vida en cinco pasos guiado por la necesidad de la organización; paso de datos crudos a información y a conocimiento; cuarto paradigma (Jim Gray, 2007); CRISP-DM (2000); habilidades repartidas en equipos; ingenieros de datos; gobierno y destrucción de datos; sesgo de redes sociales; efecto mosaico; definición de big data. NIST: SP 1500-1r2, Volume 1 Definitions — Consultada: 2026-10-09.
- Donoho, David. 50 years of Data Science (manuscrito, versión 1.00, 18 de septiembre de 2015, basado en su presentación en el centenario de John Tukey en Princeton; publicado después en el Journal of Computational and Graphical Statistics, 2017) — ciencia de datos como «the science of learning from data»; Tukey (1962) y la cita «one defined by a ubiquitous problem rather than by a concrete subject»; Cleveland (2001) y el uso del término; Breiman (2001) y las dos culturas; las seis divisiones de la Greater Data Science; crítica al tamaño de los datos como criterio; peso de la preparación de datos. Universidad de California en Berkeley: manuscrito de Donoho, 50 years of Data Science — Consultada: 2026-10-09.
- DANE y MinTIC. Boletín técnico Encuesta de Tecnologías de la Información y las Comunicaciones en Empresas (ENTIC Empresas) 2020 (publicado el 16 de diciembre de 2022) — 21.630 empresas investigadas; parámetros de inclusión por personal o ingresos; porcentaje de empresas con procesos de analítica de datos y con analítica basada en datos masivos por subsector (tabla 12); razones para no desarrollar analítica (tabla 18); uso de datos abiertos del sector público (gráfico 36); glosario: datos estructurados, no estructurados y semiestructurados, analítica descriptiva y portal datos.gov.co del MinTIC. DANE: boletín técnico ENTIC Empresas 2020 — Consultada: 2026-10-09.
- Agencia Nacional de Contratación Pública – Colombia Compra Eficiente. SECOP II – Contratos Electrónicos (conjunto de datos publicado en datos.gov.co con licencia Creative Commons Atribución-CompartirIgual 4.0) — información de los contratos registrados en SECOP II desde su lanzamiento; campos como nombre de la entidad, departamento, modalidad de contratación, proveedor adjudicado, si es pyme, fecha de firma y valor del contrato. datos.gov.co: SECOP II – Contratos Electrónicos — Consultada: 2026-10-09.
- DANE. Estadísticas experimentales — definición de estadística experimental y ficha del proyecto «Estimaciones del IPM con imágenes satelitales» (información actualizada el 24 de febrero de 2021, según la misma página). DANE: estadísticas experimentales — Consultada: 2026-10-09.
Cómo investigamos esta página
- Pregunta que responde: Qué es la ciencia de datos, de dónde viene, cómo es su ciclo de vida, qué disciplinas la forman y para qué sirve en Colombia.
- Fuentes: identificadas 13 → incluidas 6 (NIST, Donoho, tres documentos del DANE y un conjunto de Colombia Compra Eficiente en datos.gov.co).
- Criterios de inclusión: solo fuentes oficiales, estándares técnicos o textos del propio autor, leídos completos; se excluyeron prensa, fuentes bloqueadas y referencias de segunda mano.
- Fecha de corte de los datos: 2026-10-09