
Estructuras de datos y algoritmos: qué son y cómo estudiarlos
Las estructuras de datos son las formas de organizar la información en un programa; los algoritmos, los pasos que la procesan. Se estudian juntos porque la estructura decide cuánto tiempo y memoria cuesta cada paso. Aquí verá cómo se relacionan, por qué importan aunque use código ya hecho (bibliotecas), una tabla de costos y un temario en ocho bloques con recursos gratuitos.
Última actualización: 2026-10-11
Contenido de esta página
- ¿Qué son las estructuras de datos y los algoritmos?
- ¿Por qué estudiar estructuras de datos y algoritmos si ya existen librerías?
- Complejidad de las estructuras de datos: tabla de operaciones y costos
- Temario de estructuras de datos y algoritmos: el orden de estudio en 8 bloques
- ¿Dónde estudiar estructuras de datos y algoritmos gratis? Cursos y recursos abiertos
- Mapa de las guías de estructuras de datos y algoritmos
- Lo que el error de 2006 le enseña a quien empieza
El 2 de junio de 2006, Joshua Bloch, ingeniero de software de Google, publicó en el blog de investigación de la empresa una confesión técnica [1]. La búsqueda binaria que él mismo había escrito para la biblioteca estándar del lenguaje Java, el conjunto de funciones que trae de fábrica, tenía un error [1]. La búsqueda binaria encuentra un valor en una lista ordenada partiéndola por la mitad una y otra vez [2].
El error estuvo escondido unos nueve años, según la cuenta del propio Bloch [1]. Salió a la luz cuando dañó el programa de alguien y se reportó a Sun, la empresa que entonces publicaba Java [1]. Solo aparecía con arreglos, es decir, listas de posiciones numeradas, de 1.073.741.824 elementos o más [1]. Son unos mil millones. Con listas así, la línea que calculaba el punto medio sumaba dos posiciones y pasaba del número más grande que esa variable podía guardar [1].
Bloch contó que la misma línea estaba en la versión que Jon Bentley había demostrado correcta, y luego probado, en su libro Programming Pearls, de los años ochenta [1]. Ahí pasó inadvertida dos décadas [1]. La lección que sacó Bloch fue de humildad: «es difícil escribir correctamente incluso el fragmento de código más pequeño» [1].
La historia junta las dos piezas de esta guía. La lista ordenada es una estructura de datos. La búsqueda binaria es un algoritmo. Y el error vivía en la biblioteca, el código que se usa justamente para no tener que escribirlo uno mismo.
¿Qué son las estructuras de datos y los algoritmos?
Una estructura de datos es una forma de organizar la información, casi siempre en la memoria del computador, para que los algoritmos trabajen con más eficiencia [3]. Un algoritmo es un conjunto de pasos que se pueden calcular para llegar a un resultado [3]. Dicho en corto: la estructura decide dónde y cómo se guardan los datos, y el algoritmo decide qué se hace con ellos.
El diccionario del NIST, el instituto de estándares de Estados Unidos, da varios ejemplos de estructura [3]. Una pila deja sacar solo el último elemento que entró; una cola, solo el primero que llegó [2]. Una lista enlazada guarda cada elemento con un enlace al siguiente [4]. Un árbol cuelga los datos de una raíz, como un organigrama, y un montículo es un árbol que deja siempre arriba el valor menor o el mayor [2]. Casi todas tendrán su guía en este mapa. La definición completa de estructura de datos y sus tipos será tema de la guía de estructuras de datos. Qué es un algoritmo y qué lo caracteriza tendrá también su guía. Las dos están en preparación.
¿Qué relación hay entre una estructura de datos y un algoritmo?
Una estructura de datos y un algoritmo dependen uno del otro. La estructura guarda la información y trae sus propios algoritmos para mantenerse en orden. El algoritmo, a su vez, rinde más o menos según la estructura sobre la que trabaja. El diccionario del NIST lo anota así: «la mayoría de las estructuras de datos tienen algoritmos asociados para hacer operaciones como buscar, insertar o balancear, que mantienen las propiedades de la estructura» [3].
El curso de algoritmos del MIT, el Instituto Tecnológico de Massachusetts, ordena esa relación con dos palabras. La interfaz es la lista de operaciones que se ofrecen, como agregar, buscar o borrar: según sus apuntes, es el problema [4]. La estructura de datos es la manera concreta de hacer esas operaciones: es la solución [4]. Y distintas estructuras pueden ofrecer la misma interfaz con desempeños diferentes [5].
Piense en la bodega de una ferretería. Las cajas apiladas contra la pared y los estantes rotulados por referencia guardan los mismos tornillos. Encontrar uno cuesta minutos en el primer caso y segundos en el segundo. El estante es la estructura; la manera de buscar, el algoritmo.
Los apuntes del MIT traen un ejemplo de su primera clase. El problema es saber si dos estudiantes cumplen años el mismo día. El algoritmo compara a cada uno con todos los anteriores, y su costo crece con el cuadrado del número de estudiantes [5]. La salida que anotan los profesores es cambiar de estructura: guardar el registro en otra estructura de datos [5].
¿Por qué estudiar estructuras de datos y algoritmos si ya existen librerías?
Una librería, o biblioteca, es código ya escrito que se instala y se usa. Vale la pena estudiar estructuras y algoritmos porque la librería resuelve cómo se hace una operación, pero no cuál estructura usar. Esa elección sigue en manos de quien programa, y decide si un cruce de datos tarda milésimas o segundos. Además, las librerías tienen límites que solo aparecen cuando los datos crecen, como mostró el error que contó Bloch [1]. Saber cómo funcionan por dentro es saber leer el costo de lo que uno le pide al computador.
La misma pregunta con dos estructuras: un ejemplo en Python
Un ejemplo ilustrativo, con datos simulados. Suponga que una cooperativa de Bucaramanga necesita saber cuáles de los 5.000 pagos del día corresponden a alguno de sus 100.000 asociados. En Python, un lenguaje de programación de código abierto [14], la pregunta se puede hacer de dos maneras: buscando en una lista o buscando en un conjunto. Este código hace las dos y mide el tiempo de cada una:
# Cruzar 5.000 códigos contra un registro de 100.000: misma pregunta, dos estructuras
import random
import time

random.seed(2026)  # semilla fija: los datos salen iguales en cada corrida
registro = random.sample(range(10**9), 100_000)  # 100.000 códigos distintos
consultas = random.sample(registro, 2_500) + random.sample(range(10**9), 2_500)

# 1) Buscar en una lista: Python revisa los elementos uno por uno
inicio = time.perf_counter()
hallados_lista = sum(1 for c in consultas if c in registro)
t_lista = time.perf_counter() - inicio

# 2) Pasar el registro a un conjunto (set), que por dentro es una tabla hash,
#    y buscar ahí. El tiempo incluye construir el conjunto.
inicio = time.perf_counter()
conjunto = set(registro)
hallados_set = sum(1 for c in consultas if c in conjunto)
t_set = time.perf_counter() - inicio

print("Códigos hallados:", hallados_lista, "| mismo resultado:", hallados_lista == hallados_set)
print(f"Lista: {t_lista:.2f} s | Conjunto: {t_set:.3f} s")
Lo corrí tres veces en mi computador con Python 3.13.13. Las dos vías hallaron los mismos 2.500 códigos. La lista tardó entre 3,4 y 3,6 segundos. El conjunto, contando el tiempo de construirlo, tardó unas cinco milésimas de segundo.
La documentación oficial de Python explica la diferencia. Preguntar si un valor está en una lista cuesta O(n): el tiempo crece en proporción al número de elementos, que se llama n [6]. En un conjunto, la misma pregunta cuesta O(1): un tiempo que no crece con el tamaño [6]. Ese O(1) es un promedio. El conjunto funciona por dentro como una tabla hash: cada valor, que hace de clave de búsqueda, se ubica en una posición calculada con una fórmula, la función hash [2][6]. En el peor caso, cuando todas las claves caen en la misma posición de la tabla hash, el conjunto también se vuelve O(n) [6].
Ninguna librería escogió por usted entre la lista y el conjunto. Esa decisión es el oficio.
Cuando los datos crecen, la diferencia se vuelve enorme
Los apuntes del MIT ponen números a esa diferencia. Suponga mil datos y una máquina idealizada que hace una operación por nanosegundo [5]. Un algoritmo lineal, cuyo tiempo crece al mismo ritmo que los datos, termina en un microsegundo [5]. Uno cuadrático, cuyo tiempo crece con el cuadrado de los datos, necesita un milisegundo [5]. Y uno exponencial tardaría un número de milenios que se escribe con un 1 seguido de 281 ceros [5].
El error de Bloch muestra la otra cara. Un código que bastaba para los tamaños de los años ochenta falló cuando las listas llegaron a mil millones de elementos [1]. Quien entiende cómo trabaja una búsqueda binaria puede leer un reporte así y saber si su programa corre el mismo riesgo.
Tiempo y memoria: la complejidad vista como un costo
Como economista, leo la complejidad como una cuenta de costos. El NIST la define como la cantidad mínima de recursos, por ejemplo memoria, tiempo o mensajes, que se necesita para resolver un problema o ejecutar un algoritmo [7]. La palabra que me interesa es «recursos». El tiempo de máquina y la memoria son escasos, y escoger una estructura es decidir en qué se gastan.
La lista de Python lo ilustra. Reserva espacio de más para que agregar un elemento al final salga barato en promedio; a cambio, ocupa más memoria de la que necesitan sus datos [4]. Es un intercambio: gasta memoria para ahorrar tiempo. Para comparar esas cuentas existe la notación O grande. El NIST la describe como una medida teórica del tiempo o la memoria que necesita un algoritmo según el tamaño del problema [7]. Cómo se calcula será tema de la guía de complejidad algorítmica, en preparación.
Complejidad de las estructuras de datos: tabla de operaciones y costos
La tabla resume cuánto cuesta cada operación básica en las estructuras de esta guía. O(1) es un costo que no crece con el número de datos. O(log n) crece muy despacio: con la búsqueda binaria, duplicar los datos agrega un solo paso. O(n) crece en proporción a los datos. Los valores vienen de la documentación oficial de Python, de los apuntes del MIT y de las implementaciones del libro de Sedgewick y Wayne [6][4][8]. Otra implementación puede dar números distintos.
En la tabla aparecen términos que tendrán guía propia. Un arreglo dinámico es un arreglo que reserva espacio extra para crecer, como la lista de Python [4]. Una cola doble admite agregar y sacar elementos por sus dos puntas [9].
Un árbol balanceado es uno en el que ninguna hoja queda mucho más lejos de la raíz que las demás [2]. Y un grafo es un conjunto de puntos, llamados vértices, unidos por conexiones, llamadas aristas [2].
| Estructura (equivalente en Python) | Operación | Costo | Caso que reporta la fuente | Fuente |
|---|---|---|---|---|
Arreglo dinámico (list) | Leer o cambiar un elemento por su posición | O(1) | Sin distinción de caso | [6] |
Arreglo dinámico (list) | Agregar al final | O(1) | Amortizado: promedio sobre muchas operaciones | [6] |
Arreglo dinámico (list) | Insertar o sacar al inicio | O(n) | Peor caso: hay que mover todo el resto | [6] |
Arreglo dinámico (list) | Saber si un valor está (x in lista) | O(n) | Sin distinción de caso | [6] |
| Lista enlazada | Insertar o borrar al inicio | O(1) | Peor caso | [4] |
| Lista enlazada | Leer el elemento de la posición i | O(n) | Peor caso | [4] |
Cola doble (collections.deque) | Agregar o sacar por cualquiera de los dos extremos | O(1) | «Aproximadamente», según la documentación | [9] |
| Arreglo ordenado | Buscar con búsqueda binaria | O(log n) | Peor caso | [8] |
Tabla hash (dict, set) | Buscar, insertar o borrar | O(1) | Promedio; en el peor caso, O(n) | [6][8] |
| Árbol binario de búsqueda sin balancear | Buscar | O(log n) | Promedio; en el peor caso, O(n) | [8] |
| Árbol balanceado (rojo-negro o AVL) | Buscar, insertar o borrar | O(log n) | Peor caso | [8] |
| Montículo binario | Insertar o sacar el menor | O(log n) | Peor caso | [8] |
| Grafo de V vértices y E aristas | Recorrerlo por niveles o por ramas | O(V + E) | Peor caso | [8] |
Saco dos lecturas de la tabla. La primera es que ninguna estructura gana en todo. La lista enlazada inserta al inicio en tiempo constante pero tarda O(n) en llegar a una posición, y el arreglo hace justo lo contrario [4]. La segunda es que varias celdas dependen del caso. La tabla hash promete O(1) solo en promedio [6], y un árbol sin balancear puede degradarse hasta O(n) [8].
Temario de estructuras de datos y algoritmos: el orden de estudio en 8 bloques
Propongo estudiar estructuras de datos y algoritmos en ocho bloques, que van de lo que se necesita antes a lo que combina todo al final. Son programación, costo, estructuras lineales, búsqueda y ordenamiento, tablas hash, árboles, grafos y técnicas de diseño. La agrupación es mía. La armé mirando el curso 6.006 del MIT y el libro de Sedgewick y Wayne, que avanzan en una secuencia parecida [10][11].
El curso del MIT, en su versión de 2020, va de las estructuras de datos al ordenamiento, luego a las tablas hash, los árboles y los montículos [10]. Después pasa a los recorridos de grafos y los caminos más cortos, y termina con programación dinámica y complejidad [10]. El libro de Sedgewick y Wayne arranca con pilas, colas y análisis de algoritmos, sigue con ordenamiento y búsqueda, y luego con grafos y textos [11]. Este es el orden que sugiero:
- Programación y matemáticas de base. Escribir programas pequeños con soltura en un lenguaje y repasar matemáticas discretas: conjuntos, lógica, demostraciones, recursión y grafos. Es lo que el MIT pide antes de su curso: experiencia básica programando en Python 3 y esas matemáticas [10].
- Qué es un algoritmo y cuánto cuesta. La definición de algoritmo, la notación O grande y cómo calcular el costo de un algoritmo sencillo. El MIT presenta esa notación desde su primera clase [5].
- Estructuras lineales. Arreglos, listas enlazadas, pilas y colas: las estructuras que guardan los datos uno detrás de otro.
- Búsqueda, ordenamiento y recursividad. La búsqueda lineal y la binaria, los métodos de ordenamiento y la recursividad. La recursividad es una técnica en la que una función se llama a sí misma con una parte de la tarea [2]. El MIT la trata desde la primera clase como una idea central de la computación [5].
- Tablas hash. Cómo se busca en tiempo constante en promedio y qué pasa cuando dos claves caen en la misma posición, lo que se llama una colisión [2].
- Árboles y montículos. Árboles binarios, árboles de búsqueda, árboles balanceados y montículos, que el MIT y el libro de Princeton estudian después del ordenamiento [10][11].
- Grafos. Cómo se representan, cómo se recorren y cómo se halla el camino más corto entre dos puntos [10].
- Técnicas de diseño y práctica. Fuerza bruta, divide y vencerás, programación dinámica y algoritmos voraces, que los apuntes del MIT listan como maneras de diseñar un algoritmo propio [5]. Después vienen los ejercicios.
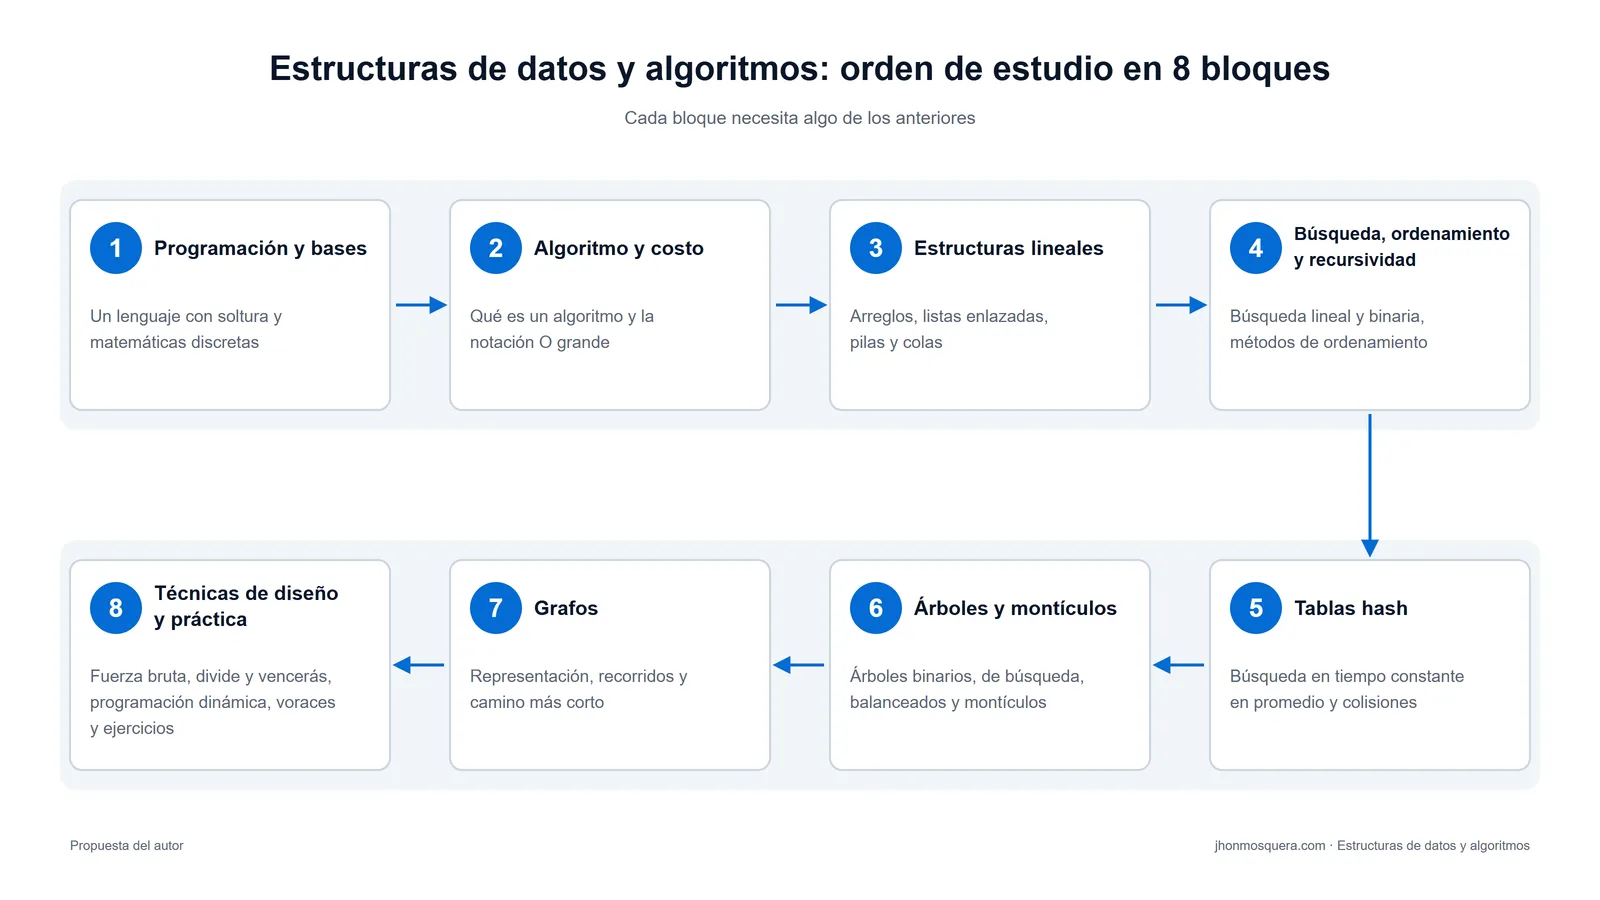
El orden sigue una regla: cada bloque necesita algo de los anteriores. Un método de ordenamiento no se puede comparar sin la notación del bloque 2. Un montículo no se entiende sin haber visto árboles. Y el recorrido de un grafo por niveles se apoya en una cola del bloque 3 [11].
¿Dónde estudiar estructuras de datos y algoritmos gratis? Cursos y recursos abiertos
Un curso completo de estructuras de datos y algoritmos se puede seguir gratis con material abierto. Recomiendo cuatro recursos porque vienen de universidades o de entidades oficiales y no cobran por el acceso. Son el curso 6.006 del MIT, el sitio del libro de Sedgewick y Wayne, el diccionario del NIST y la documentación oficial de Python. Los cuatro están en inglés, salvo una traducción parcial de la documentación de Python.
El curso 6.006 Introduction to Algorithms, de la primavera de 2020, está en MIT OpenCourseWare, el sitio de cursos abiertos del MIT. Publica apuntes de 20 clases, videos, tareas y exámenes con soluciones [10]. OpenCourseWare no pide inscripción ni crear una cuenta, y deja descargar los archivos [12]. A cambio, no da créditos ni certificados [12]. El libro de Cormen, Leiserson, Rivest y Stein, conocido como CLRS, figura en el programa como referencia útil, pero no obligatoria [10].
El libro Algorithms, 4.ª edición, es de Robert Sedgewick y Kevin Wayne, de la Universidad de Princeton. Su sitio publica una versión resumida del texto, el código en Java, ejercicios con soluciones seleccionadas y tareas de programación [11]. También tiene una hoja de resumen con el costo de los algoritmos y estructuras clásicos, la misma que alimenta buena parte de la tabla de arriba [8].
El Diccionario de Algoritmos y Estructuras de Datos del NIST reúne definiciones de algoritmos, técnicas, estructuras y problemas clásicos. Se empezó a construir en 1998, con Paul E. Black como editor [3]. Sirve para consultar una definición precisa cuando un apunte la da por sabida.
La documentación oficial de Python trae un capítulo del tutorial dedicado a las estructuras de datos [13]. La versión vigente, la 3.15, incluye además una página con el costo de cada operación de los tipos que trae el lenguaje [6]. El tutorial tiene traducción al español, pero incompleta: cuando la consulté, el 11 de octubre de 2026, el párrafo que explica por qué una lista es lenta como cola seguía en inglés [13].
Hago la cuenta como economista. En licencias, estudiar esta disciplina cuesta cero: Python tiene una licencia de código abierto que permite usarlo y distribuirlo libremente [14], y los cuatro recursos son gratuitos. El costo real está en las horas de estudio, en un computador que corra Python y en el inglés técnico que piden estos materiales. OpenCourseWare prevé incluso el caso de una institución apartada y con poca conexión a internet, que puede copiar los materiales para sus estudiantes cobrando solo lo que cuestan las copias [12].
Mapa de las guías de estructuras de datos y algoritmos
Esta tabla ordena las guías sobre estructuras de datos y algoritmos según el bloque de estudio al que pertenecen. Todas están en preparación; cuando se publiquen, cada nombre llevará su enlace.
| Bloque | Pregunta que responde | Guías (próximamente) |
|---|---|---|
| 1 · Programación y bases | ¿Qué necesito saber antes y en qué lenguaje practico? | Fundamentos de programación · Qué lenguaje elegir para practicar · Estructuras de datos y algoritmos en Python |
| 2 · Algoritmo y costo | ¿Qué es un algoritmo y cómo se mide lo que cuesta? | Qué es un algoritmo · Complejidad algorítmica · Notación Big O · Cómo calcular la complejidad de un algoritmo |
| 3 · Estructuras lineales | ¿Cómo se guardan datos uno detrás de otro? | Estructuras de datos · Arrays · Listas enlazadas · Pilas · Colas |
| 4 · Búsqueda, ordenamiento y recursividad | ¿Cómo encuentro y ordeno datos? | Algoritmos de búsqueda · Búsqueda binaria · Algoritmos de ordenamiento · Ordenamiento burbuja · Ordenamiento por inserción · Ordenamiento por selección · Merge sort · Quicksort · Recursividad |
| 5 · Tablas hash | ¿Cómo busco en tiempo constante? | Tablas hash · Conjuntos disjuntos (union-find) |
| 6 · Árboles y montículos | ¿Cómo se organizan datos en jerarquía? | Árboles · Árboles binarios · Árbol binario de búsqueda · Recorridos de árboles · Árboles AVL · Árboles B · Montículos (heap) · Heapsort · Trie · Árboles de segmentos · Estructuras de datos avanzadas |
| 7 · Grafos | ¿Cómo se modelan conexiones y rutas? | Grafos · Tipos de grafos · Recorridos en anchura y en profundidad (BFS y DFS) · Algoritmo de Dijkstra · Algoritmos de camino más corto · Árbol de expansión mínima |
| 8 · Técnicas de diseño y práctica | ¿Cómo diseño un algoritmo propio y dónde practico? | Paradigmas de algoritmos · Divide y vencerás · Programación dinámica · Algoritmos voraces · Backtracking · Fuerza bruta · Dos punteros y ventana deslizante · Patrones de algoritmos para entrevistas · Plataformas para practicar algoritmos |
Esta guía hace parte del mapa de la ciencia de datos, y cuatro temas vecinos tienen su propio lugar. La sintaxis y los tipos del lenguaje Python serán tema de la guía de Python, en preparación. Los índices y los grafos como forma de guardar información en un sistema son asunto de las bases de datos. Los algoritmos que aprenden de ejemplos están en machine learning. Y la preparación de entrevistas como paso de una carrera, con sus salarios, será tema de la guía de rutas y carreras en datos, también en preparación.
Cuando el problema deja de ser la estructura y pasa a ser que los datos no caben en una sola máquina, el tema es el big data.
Lo que el error de 2006 le enseña a quien empieza
Vuelvo a Bloch. Leo su error como un problema de escala más que de descuido. Bentley había escrito, según cita Bloch, que la primera búsqueda binaria se publicó en 1946 y que la primera correcta para todos los tamaños apareció en 1962 [1]. Dieciséis años para un algoritmo que cabe en menos de veinte líneas de código [1]. Y aun así, la versión que se creía resuelta volvió a fallar cuando los datos crecieron [1].
A mi juicio, esa es la razón más honesta para estudiar estructuras de datos y algoritmos. Sirven para pasar entrevistas, sí, pero sobre todo para saber cuánto cuesta lo que uno le pide al computador y cuándo ese costo se va a disparar. Para un analista en Colombia que trabaja con un portátil y sin presupuesto para servidores, escoger bien la estructura es una manera de ganar capacidad que no exige comprar nada.
La próxima vez que un programa suyo tarde minutos, antes de pedir un computador más grande, cuente cuántas veces recorre la misma lista.
Preguntas frecuentes
¿Qué se ve en un curso de estructuras de datos y algoritmos? El curso introductorio del MIT sirve de muestra. Su programa cubre arreglos dinámicos, montículos, árboles de búsqueda balanceados y tablas hash, y problemas clásicos como ordenar, recorrer grafos y la programación dinámica [10]. Agrega el modelado matemático de problemas y las técnicas para medir el desempeño [10].
¿Es lo mismo «algoritmos y estructuras de datos» que «estructuras de datos y algoritmos»? Sí. Las dos expresiones nombran la misma disciplina y el orden de las palabras no cambia el contenido. El libro de Sedgewick y Wayne, por ejemplo, habla de «algoritmos y estructuras de datos» en su hoja de resumen [8].
¿Se necesitan muchas matemáticas para aprender algoritmos? Hacen falta las matemáticas discretas básicas que menciona el bloque 1 del temario. El MIT no las da por supuestas: antes de calificar cualquier otra tarea, las evalúa con un ejercicio inicial, el Problem Set 0 [10]. Quien saca C o menos en ese ejercicio debe reunirse con el equipo del curso antes de seguir [10].
¿Cuánto tiempo toma aprender estructuras de datos y algoritmos? Depende de la base de cada persona, así que no hay un plazo único. Como referencia, la versión abierta del curso del MIT es la de la primavera de 2020. Se dictó en un semestre, con dos clases y dos sesiones de ejercicios de una hora por semana [10]. Ese ritmo supone que el estudiante ya programa en Python.
¿Con qué lenguaje conviene practicar? A mi juicio, sirve cualquier lenguaje que ya se domine, porque las ideas de la disciplina no cambian de uno a otro. El libro de Sedgewick y Wayne, por ejemplo, publica su código en Java [11], y el ejemplo de esta página está en Python. La comparación entre lenguajes tendrá su propia guía.
Referencias
Las citas en otro idioma son traducción propia.
- Google Research (Joshua Bloch). Extra, Extra – Read All About It: Nearly All Binary Searches and Mergesorts are Broken (2 de junio de 2006) — la búsqueda binaria que Bloch escribió para java.util.Arrays en el JDK tenía un error que se reportó a Sun cuando dañó un programa, «after lying in wait for nine years or so»; falla si la suma de las posiciones supera el máximo entero positivo (2^31 − 1), con arreglos de 2^30 elementos o más («roughly a billion elements»), tamaño «inconceivable back in the ’80s» y común en Google; la versión que Bentley demostró correcta y probó en Programming Pearls tenía el mismo error y «escaped detection for two decades»; Bentley: primera búsqueda binaria publicada en 1946, primera correcta para todo n en 1962; lección: «It is hard to write even the smallest piece of code correctly». Google Research: Nearly All Binary Searches and Mergesorts are Broken — Consultada: 2026-10-11.
- NIST, Dictionary of Algorithms and Data Structures (Paul E. Black, ed.). Entradas binary search (buscar en un arreglo ordenado dividiendo el intervalo a la mitad repetidamente), hash table (diccionario que ubica las claves en posiciones de un arreglo mediante funciones hash; colisión: dos claves en la misma posición), tree (estructura a la que se accede desde la raíz; nodos internos y hojas), heap (árbol completo en el que cada nodo tiene una clave más extrema que la de su padre, o igual), graph (conjunto de elementos, vértices o nodos, unidos por aristas), stack (solo se puede sacar el último elemento agregado: LIFO), queue (solo se accede al primer elemento agregado: FIFO), balanced tree (árbol en el que ninguna hoja está mucho más lejos de la raíz que las demás) y recursion (técnica en la que una función, para cumplir una tarea, se llama a sí misma con una parte de esa tarea). NIST DADS: binary search · NIST DADS: hash table · NIST DADS: tree · NIST DADS: heap · NIST DADS: graph · NIST DADS: stack · NIST DADS: queue · NIST DADS: balanced tree · NIST DADS: recursion — Consultada: 2026-10-11.
- NIST, Dictionary of Algorithms and Data Structures (Paul E. Black, ed.). Entradas algorithm («A computable set of steps to achieve a desired result») y data structure (organización de la información, usualmente en memoria, para mejorar la eficiencia de los algoritmos, como cola, pila, lista enlazada, montículo, diccionario y árbol; nota: «Most data structures have associated algorithms to perform operations, such as search, insert, or balance, that maintain the properties of the data structure»), y portada del diccionario (algoritmos, técnicas algorítmicas, estructuras de datos y problemas arquetípicos; desarrollo iniciado en 1998 bajo la edición de Paul E. Black; alojado por el Information Technology Laboratory del NIST). NIST DADS: algorithm · NIST DADS: data structure · NIST: Dictionary of Algorithms and Data Structures — Consultada: 2026-10-11.
- MIT OpenCourseWare. Erik Demaine, Jason Ku y Justin Solomon, 6.006 Introduction to Algorithms, Lecture 2: Data Structures (primavera de 2020) — «Interface is a specification: what operations are supported (the problem!)»; «Data structure is a representation: how operations are supported (the solution!)»; lista enlazada: cada elemento guarda un puntero al siguiente; insertar y borrar al frente en Θ(1), leer la posición i en O(n); arreglo: leer la posición i en Θ(1), insertar al frente en Θ(n); arreglo dinámico (la list de Python): reserva espacio extra para no realojar en cada operación, inserción al final en O(1) amortizado, y puede desperdiciar espacio. MIT OCW: 6.006 Lecture 2, Data Structures (PDF) — Consultada: 2026-10-11.
- MIT OpenCourseWare. Erik Demaine, Jason Ku y Justin Solomon, 6.006 Introduction to Algorithms, Lecture 1: Introduction (primavera de 2020) — «Data structures may implement the same interface with different performance»; recursión como concepto central («why recursion is such a key concept in computer science»); notación asintótica; tabla de tiempos para n = 1.000 en una máquina de un núcleo a 1 GHz con una operación por ciclo: lineal 1 µs, cuadrático 1 ms, exponencial 10^281 milenios; ejemplo de cumpleaños coincidentes con costo O(n²) y la nota «Use different data structure for record!»; maneras de diseñar un algoritmo propio: fuerza bruta, reducir y conquistar, divide y vencerás, programación dinámica, voraz/incremental. MIT OCW: 6.006 Lecture 1, Introduction (PDF) — Consultada: 2026-10-11.
- Python Software Foundation. Time complexity of operations on built-in types, documentación de Python 3.15.0 (última actualización: 11 de octubre de 2026) — costos en CPython: list (leer o cambiar por posición O(1); append O(1) amortizado; insertar o sacar en la posición k O(n − k), peor caso en el índice 0; x in l O(n)); dict y set (buscar, insertar y borrar O(1) en promedio, suponiendo pocas colisiones; O(n) en el peor caso, cuando todas las claves dan el mismo hash); otras implementaciones de Python pueden tener costos distintos. Python docs: Time complexity of operations on built-in types — Consultada: 2026-10-11.
- NIST, Dictionary of Algorithms and Data Structures (Paul E. Black, ed.). Entradas complexity («The intrinsic minimum amount of resources, for instance, memory, time, messages, etc., needed to solve a problem or execute an algorithm») y big-O notation (medida teórica de la ejecución de un algoritmo, normalmente el tiempo o la memoria necesarios, según el tamaño n del problema). NIST DADS: complexity · NIST DADS: big-O notation — Consultada: 2026-10-11.
- Robert Sedgewick y Kevin Wayne, Princeton University. Algorithms and Data Structures Cheatsheet, sitio del libro Algorithms, 4.ª edición — órdenes de crecimiento «as implemented in this textbook»: búsqueda binaria en arreglo ordenado log n (peor caso); árbol binario de búsqueda sin balancear: búsqueda n en el peor caso y log n en promedio; árbol rojo-negro y AVL: log n en búsqueda, inserción y borrado (peor caso); tablas hash: 1 en promedio bajo el supuesto de hashing uniforme y n en el peor caso; montículo binario: insertar y sacar el mínimo en log n (peor caso); recorridos DFS y BFS de un grafo: E + V (peor caso). Princeton: Algorithms and Data Structures Cheatsheet — Consultada: 2026-10-11.
- Python Software Foundation. collections — Container datatypes, sección deque objects, documentación de Python 3.15.0 — las deques admiten agregar y sacar por cualquiera de los dos lados «with approximately the same O(1) performance in either direction»; las listas incurren en costos O(n) de movimiento de memoria para pop(0) e insert(0, v). Python docs: collections.deque — Consultada: 2026-10-11.
- MIT OpenCourseWare. 6.006 Introduction to Algorithms (primavera de 2020; Erik Demaine, Jason Ku y Justin Solomon) — portada (descripción del curso; materiales: apuntes, videos, tareas y exámenes con soluciones), programa (requisitos: experiencia básica programando en Python 3 y matemáticas discretas —conjuntos, relaciones y lógica, combinatoria, demostraciones, recursión, teoría de números, teoría de grafos y probabilidad—; descripción: arreglos dinámicos, montículos, árboles binarios de búsqueda balanceados, tablas hash, ordenamiento, búsqueda en grafos y programación dinámica; dos clases y dos sesiones de ejercicios de una hora por semana; los requisitos se evalúan con un Problem Set 0 que debe entregarse antes de que se califique cualquier otra tarea, y quien obtiene C o menos debe reunirse con el equipo antes de tomar el curso; CLRS, tercera edición, como referencia útil no obligatoria) y apuntes de 20 clases, en este orden: introducción, estructuras de datos, ordenamiento, hashing, ordenamiento lineal, árboles binarios (dos clases), montículos binarios, búsqueda en anchura, búsqueda en profundidad, caminos más cortos con pesos, Bellman-Ford, Dijkstra, caminos entre todos los pares, programación dinámica (cuatro clases), complejidad y repaso. MIT OCW: 6.006 Introduction to Algorithms · MIT OCW: 6.006, programa del curso · MIT OCW: 6.006, apuntes de clase — Consultada: 2026-10-11.
- Robert Sedgewick y Kevin Wayne, Princeton University. Algorithms, 4th Edition, portada del sitio del libro — capítulos: fundamentos (pilas y colas, análisis de algoritmos, union-find), ordenamiento, búsqueda (tablas de símbolos, árboles binarios de búsqueda, árboles balanceados, tablas hash), grafos, cadenas de texto y contexto; el sitio ofrece una versión condensada del texto, el código en Java, ejercicios con soluciones seleccionadas y tareas de programación. Y sección 4.1, Undirected Graphs: la búsqueda en anchura mantiene una cola (FIFO) de vértices marcados. Princeton: Algorithms, 4th Edition · Princeton: Algorithms, 4.1 Undirected Graphs — Consultada: 2026-10-11.
- MIT OpenCourseWare. About Us y Privacy and Terms of Use — colección libre y abierta de materiales de cursos del MIT; sin inscripción ni cuenta; archivos descargables; el MIT no otorga créditos ni certificación a los usuarios de OCW; licencia Creative Commons BY-NC-SA 4.0; ejemplo de una institución en una zona apartada con acceso limitado a internet que puede copiar materiales y recuperar solo el costo de las copias. MIT OCW: About Us · MIT OCW: Privacy and Terms of Use — Consultada: 2026-10-11.
- Python Software Foundation. 5. Data Structures, tutorial de Python 3.15.0, y su traducción 5. Estructuras de datos (documentación en español, última actualización: 11 de octubre de 2026) — las listas no son eficientes como cola porque insertar o sacar al inicio obliga a correr todos los demás elementos; para una cola se recomienda collections.deque; en la versión en español consultada, ese párrafo explicativo aparece sin traducir. Python docs: Data Structures · Python docs en español: Estructuras de datos — Consultada: 2026-10-11.
- Python Software Foundation. About Python — Python se desarrolla bajo una licencia de código abierto aprobada por la OSI, que permite usarlo y distribuirlo libremente, incluso con fines comerciales. Python.org: About — Consultada: 2026-10-11.
Cómo investigamos esta página
- Pregunta que responde: Qué son las estructuras de datos y los algoritmos, por qué estudiarlos aunque existan librerías, cuánto cuesta cada operación básica y en qué orden conviene aprenderlos.
- Fuentes: identificadas 39 → incluidas 30
- Criterios de inclusión: solo el diccionario del NIST, el curso abierto 6.006 del MIT, el sitio del libro de Sedgewick y Wayne (Princeton), la documentación oficial de Python y el texto de primera mano de Joshua Bloch; nada de enciclopedias ni sitios de tutoriales.
- Fecha de corte de los datos: 2026-10-11