
Qué es el análisis de datos (o analítica de datos)
El análisis de datos, también llamado analítica de datos, es el proceso de revisar datos con técnicas estadísticas y lógicas hasta sacar una conclusión confiable para decidir. Aquí verá para qué sirve, sus seis etapas, la diferencia entre datos cualitativos y cuantitativos y un ejemplo con precios mayoristas del DANE.
Última actualización: 2026-10-10
Contenido de esta página
- ¿Qué es el análisis de datos?
- ¿Análisis de datos y analítica de datos son lo mismo?
- ¿Para qué sirve el análisis de datos?
- ¿Cuál es el proceso de análisis de datos?
- Las seis etapas del análisis de datos
- Datos cualitativos y cuantitativos: ¿qué diferencia hay?
- Un ejemplo de punta a punta: el precio de la mora en una central de Bucaramanga
- Análisis de datos vs ciencia de datos: ¿en qué se diferencian?
- ¿Qué se necesita para empezar a analizar datos?
- Análisis de datos: qué guía leer según lo que busca
- ¿Qué no resuelve el análisis de datos?
Escena compuesta, con nombre ficticio: Gladys compra y revende fruta al por mayor en una central de abastos de Bucaramanga. Cada lunes, antes de que aclare, negocia la mora y el lulo con los camiones que llegan de las veredas. Desde hace tres años anota en un cuaderno cuadriculado lo que paga por kilo, la fecha y el nombre de cada proveedor. Al margen escribe cosas como «llegó aguada» o «mucha oferta».
Un lunes de octubre, el proveedor de siempre le sube el precio de la mora. Le asegura que en toda la central está igual. Gladys no le cree, pero tampoco tiene cómo demostrarle lo contrario.
Tiene cien páginas de precios y ninguna respuesta.
El cuaderno ya guarda la respuesta, o buena parte de ella. Lo difícil es sacarla de ahí en una forma que aguante la discusión con el proveedor. Para eso existe el análisis de datos: examinar datos con un método para contestar una pregunta y saber cuánto creerle a la respuesta. Para la parte que su cuaderno no cubre, el precio de los demás, existe una fuente pública. El DANE (Departamento Administrativo Nacional de Estadística, la entidad que produce las cifras oficiales de Colombia) informa los precios mayoristas de los productos agroalimentarios que se comercializan en el país [1].
¿Qué es el análisis de datos?
Analizar datos es interrogarlos con método hasta que respondan una pregunta. El análisis de datos incluye ordenarlos, resumirlos, buscar patrones y medir si lo que aparece es real o es casualidad. El resultado no es otra tabla. Es una conclusión con su grado de confianza, lista para que alguien decida algo con ella.
Hay una definición con respaldo institucional en español. Viene del DeCS, el vocabulario controlado de la Biblioteca Virtual en Salud, es decir, una lista oficial de términos con su definición que sirve para clasificar artículos científicos [2]. Allí el análisis de datos es un «Proceso que consiste en la aplicación sistemática de técnicas estadísticas y/o lógicas para describir e ilustrar, condensar y resumir, así como evaluar datos» [2]. El DeCS toma esa definición de la ORI (Oficina de Integridad en la Investigación), una dependencia del Departamento de Salud y Servicios Humanos de Estados Unidos [2] [3].
Cada pareja de verbos de esa definición es una tarea distinta. Describir e ilustrar es contar qué hay en los datos y mostrarlo. Condensar y resumir es llevar cien páginas de cuaderno a pocas cifras que se puedan comparar. Evaluar es decidir cuánto vale la conclusión. Gladys necesita las tres.
Definición de análisis de datos: sentido estrecho y sentido amplio
La expresión «análisis de datos» se usa en dos escalas. En sentido estrecho nombra un paso: el momento de examinar datos que ya están preparados. Así la trata la guía de ciencia de datos, que lo ubica dentro de un ciclo más largo. En sentido amplio nombra la práctica completa, desde reunir los datos hasta llegar a una conclusión defendible.
Esta guía usa el sentido amplio. Es el que tiene en mente quien busca cómo se hace un análisis de datos, y es el que hace falta para entender sus etapas.
¿Análisis de datos y analítica de datos son lo mismo?
En el uso diario, análisis de datos y analítica de datos nombran la misma práctica, y esta guía los trata como sinónimos. La diferencia es de acento, no de fondo. «Análisis» pone el foco en la técnica que examina los datos. «Analítica» suele poner el foco en el proceso completo dentro de una organización, desde recolectar los datos hasta orientar una decisión.
Los vocabularios de las bibliotecas médicas registran ese matiz. La Biblioteca Nacional de Medicina de Estados Unidos, la NLM, mantiene el MeSH, su lista de encabezados para clasificar artículos de salud [4]. En 2025 incorporó el término Data Analytics, que el DeCS traduce como analítica de datos [4] [5]. Eso sí, no lo usa para clasificar artículos: su registro indica a quienes indexan que sigan usando el de ciencia de datos [4].
El MeSH define la analítica de datos como «la recolección, transformación y organización de datos para sacar conclusiones, hacer predicciones y orientar decisiones informadas» [4]. El análisis de datos, en cambio, figura desde 2019 en la rama de la matemática [2]. La analítica cuelga de la ciencia de los datos, que a su vez pertenece a la ciencia de la información [5].
A mi juicio, esa separación dice algo útil. El análisis es el método; la analítica es el método puesto a trabajar en una organización, con sus datos, sus sistemas y sus decisiones. Para quien pregunta qué es y cómo se hace, la respuesta es la misma.
¿Para qué sirve el análisis de datos?
El análisis de datos sirve para que una organización decida con evidencia y no con la corazonada de quien lleva más años en el puesto. Le permite saber qué pasó, entender por qué pasó, anticipar lo que puede venir y escoger entre opciones. Esas cuatro preguntas dan nombre a los cuatro tipos de análisis, descriptivo, diagnóstico, predictivo y prescriptivo, que tendrán su propia guía.
En el Estado, el análisis de datos produce las estadísticas públicas. Los Principios Fundamentales de las Estadísticas Oficiales de las Naciones Unidas abren con esta frase: «Las estadísticas oficiales constituyen un elemento indispensable en el sistema de información de una sociedad democrática» [6]. La Comisión de Estadística de la ONU los adoptó en 1994, y la Asamblea General los respaldó en 2014 [6].
El DANE pone esa idea en práctica con los precios de los alimentos. Además de sus boletines diarios, semanales y mensuales, publica cada trimestre un informe de monitoreo de precios mayoristas de alimentos [1]. El más reciente, del tercer trimestre de 2026, salió el 9 de octubre [1].
En una empresa, el análisis de datos sirve para lo que busca Gladys. Separa la impresión del hecho, y le dice si su problema es del mercado o de su proveedor.
En la investigación, sirve para que una conclusión merezca crédito. La ORI advierte que los análisis estadísticos inadecuados distorsionan los hallazgos científicos y confunden a los lectores [3]. La misma oficina considera que analizar los resultados de forma exacta y apropiada es un componente esencial de la integridad de los datos [3].
¿Cuál es el proceso de análisis de datos?
El proceso de análisis de datos es la secuencia de trabajo que lleva de una pregunta a una conclusión confiable. Esta guía lo divide en seis etapas: recolección, limpieza, exploración, visualización, análisis estadístico y machine learning (aprendizaje automático). El orden no es rígido. Lo que aparece en una etapa obliga muchas veces a volver a la anterior, y la última solo se usa cuando hace falta predecir.
Antes de la primera etapa va la pregunta. La Asociación Estadounidense de Estadística, la ASA, pide en sus pautas éticas comunicar el propósito declarado y el uso previsto de cada análisis [7]. Sin pregunta, los datos se acumulan y nadie sabe cuándo parar.
El orden de las etapas tiene una razón. El manual de métodos estadísticos que publica el NIST, el instituto de normas técnicas del Gobierno de Estados Unidos, compara dos maneras de trabajar [8]. En el análisis clásico se recogen los datos y enseguida se les impone un modelo, es decir, una fórmula que supone de antemano cómo se comportan [8]. En el análisis exploratorio, después de recoger los datos se analizan primero, para descubrir qué modelo les conviene [8].
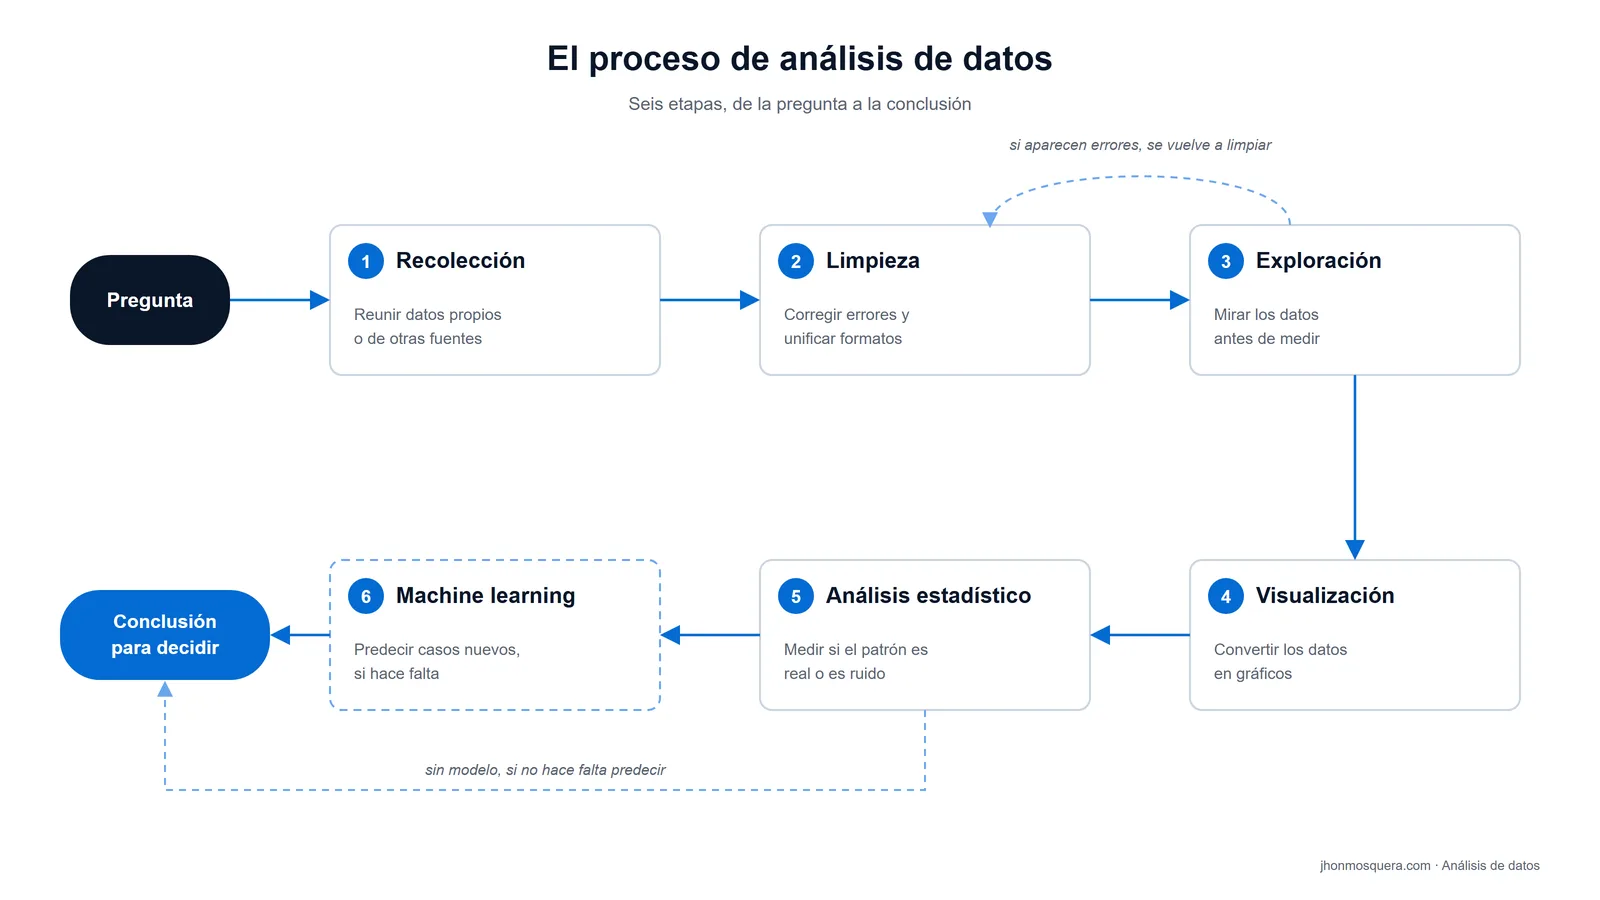
Por eso, en esta guía, la exploración va antes del análisis estadístico y del machine learning. Primero se mira; después se mide.
En mi experiencia, muchos análisis terminan antes de la sexta etapa: un buen gráfico y una comparación bien hecha resuelven buena parte de las preguntas de una organización. El machine learning, es decir, los programas que aprenden a predecir a partir de ejemplos, entra cuando hay muchos datos y hace falta anticipar casos nuevos.
Las seis etapas del análisis de datos
Las etapas del análisis de datos son seis: recolectar los datos, limpiarlos, explorarlos, visualizarlos, someterlos a un análisis estadístico y, si hace falta predecir, entrenar un modelo de machine learning. Cada etapa responde una pregunta propia y entrega un producto propio. La tabla las resume, y debajo va lo esencial de cada una.
| Etapa | Qué hace | Qué se obtiene | Dónde se profundiza |
|---|---|---|---|
| 1. Recolección | Reúne los datos que pueden responder la pregunta, propios o de otras fuentes | Un conjunto de datos con su origen documentado | Bases de datos y SQL |
| 2. Limpieza | Corrige errores, unifica formatos y decide qué hacer con los datos que faltan | Datos confiables y comparables entre sí | Limpieza de datos (próximamente) |
| 3. Exploración | Recorre los datos sin una hipótesis cerrada, en busca de formas y rarezas | Ideas por comprobar y preguntas mejores | Análisis exploratorio de datos (próximamente) |
| 4. Visualización | Convierte los datos en gráficos | Un patrón que se ve sin leer la tabla | Visualización de datos (próximamente) |
| 5. Análisis estadístico | Mide si un patrón es real o es ruido | Una conclusión con su margen de duda | Estadística para ciencia de datos (próximamente) |
| 6. Machine learning | Entrena modelos que predicen o clasifican casos nuevos | Un modelo que anticipa | Machine learning |
1. Recolección: ¿qué datos pueden responder la pregunta?
La recolección reúne los datos. Pueden ser propios, como el cuaderno de Gladys, o ajenos, como los que publica una entidad pública. En una organización suelen vivir en una base de datos y se piden con SQL, el lenguaje para consultarla. La ASA pide documentar de dónde salieron los datos, cómo se generaron y qué sesgos conocidos traen [7]. Un sesgo es un error que empuja siempre hacia el mismo lado.
2. Limpieza: ¿los datos dicen lo que creo que dicen?
La limpieza corrige errores de digitación, unifica unidades y nombres y decide qué hacer con los datos que faltan. La ASA pide contar cómo se procesaron y transformaron los datos, incluido el manejo de los faltantes [7]. Cómo se limpia en la práctica, con hoja de cálculo o con código, se verá en las guías de Excel y de Python para análisis de datos, en preparación.
3. Exploración: ¿qué hay en los datos que no esperaba?
La exploración recorre los datos antes de sacar conclusiones. El manual del NIST le asigna metas como encontrar la estructura de fondo de los datos y detectar valores atípicos y anomalías [9]. Un valor atípico es un dato muy distinto del resto: a veces es un error, a veces es la noticia.
4. Visualización: ¿cómo se ve el patrón?
La visualización convierte números en formas que el ojo compara de un golpe. No es solo el adorno del final. El mismo manual describe el análisis exploratorio como un enfoque que usa técnicas variadas, sobre todo gráficas [9]. Cómo escoger el gráfico correcto será tema de la guía de visualización de datos.
5. Análisis estadístico: ¿es real o es casualidad?
El análisis estadístico mide cuánto confiar en un patrón. La ORI, citando a los investigadores Shamoo y Resnik (2003), explica que los procedimientos de análisis permiten sacar conclusiones generales a partir de los datos [3]. También permiten distinguir la señal, el fenómeno que interesa, del ruido, las fluctuaciones propias de cualquier medición [3]. Las medidas y las pruebas concretas tendrán su desarrollo en la guía de estadística para ciencia de datos.
6. Machine learning: ¿hace falta predecir?
El machine learning entra cuando la pregunta ya no es qué pasó, sino qué va a pasar con casos nuevos. Además, debe haber suficientes ejemplos para que un programa aprenda la regla. Corresponde a lo que la definición de analítica del MeSH llama hacer predicciones [4]. Cómo aprende un modelo y cuándo conviene usarlo se explica en la guía de machine learning.
Datos cualitativos y cuantitativos: ¿qué diferencia hay?
Los datos cuantitativos son cantidades que se pueden sumar, promediar o restar: un precio, un peso, una edad. Los datos cualitativos describen cualidades o categorías: el municipio de origen, la calidad de un lote, una queja escrita. Los dos se analizan, pero con herramientas distintas, y casi cualquier problema real trae de ambos.
La ORI lo resume así: el análisis estadístico suele hacerse sobre datos cuantitativos, pero existen numerosos procedimientos diseñados específicamente para el material cualitativo [3]. En el cuaderno de Gladys, el precio por kilo es cuantitativo. «Llegó aguada» es cualitativo, y puede explicar por qué un lote costó menos.
Un número no vuelve cuantitativo un dato. El estrato socioeconómico es el mejor ejemplo colombiano. El DANE lo define como una clasificación en estratos de los inmuebles residenciales que deben recibir servicios públicos, y reconoce seis: de bajo-bajo (1) a alto (6) [10]. El 4 no es el doble del 2. Un estrato promedio de 3,4 no describe ninguna vivienda.
| Tipo de dato | Ejemplo en la central de abastos | Qué se puede hacer con él |
|---|---|---|
| Cuantitativo | Precio pagado por kilo | Promediar, restar, calcular variaciones |
| Cualitativo con orden | Calidad del lote: primera o segunda | Contar y ordenar; no promediar |
| Cualitativo sin orden | Proveedor, vereda de origen, nota al margen | Contar, agrupar y leer con atención |
Un ejemplo de punta a punta: el precio de la mora en una central de Bucaramanga
Un análisis de datos completo puede caber en un cuaderno de compras. El caso de Gladys recorre las seis etapas con una fuente pública real, el sistema de precios mayoristas del DANE, y muestra también cuándo una etapa sobra. Los precios de Gladys y los cálculos son números de ejemplo; los datos sobre la fuente pública son reales.
- La pregunta. ¿El alza que le cobra su proveedor sigue el movimiento del mercado de su central, o es solo de él? La pregunta define qué comparar: cómo cambia su precio de compra frente a cómo cambia el precio mayorista de la central, semana a semana.
- Recolección. Su cuaderno aporta lo propio. Lo ajeno viene del SIPSA, el Sistema de Información de Precios y Abastecimiento del Sector Agropecuario, que el DANE opera desde febrero de 2012 [11]. Su operación depende de un amplio equipo de personal en campo que recoge las cotizaciones [11]. Para las semanas recientes, cada boletín semanal trae un anexo en Excel con precios por producto y por mercado, entre ellos Centroabastos, en Bucaramanga [12]. Las bases mensuales de 2013 a 2024 en datos.gov.co, el portal de datos abiertos del Estado, sirven para mirar años completos hacia atrás [11]. El primer chequeo es elemental: que su producto aparezca con el mismo nombre; en el anexo figura como mora de Castilla [12].
- Limpieza. Gladys anotó unas compras por canastilla y otras por kilo; hay que llevarlas a la misma unidad. Los precios del SIPSA incluyen el IVA, el impuesto al valor agregado [11]. Si sus recibos no lo incluyen, la comparación arranca torcida. También hay fechas sin año y productos anotados con nombres distintos. Y hay que fijarse en qué precio es cada uno: el SIPSA reporta el precio de venta mayorista promedio [11], mientras que Gladys anota lo que le paga al camión, un punto anterior de la cadena. Los dos precios no se comparan por su nivel; se compara cómo se mueven.
- Exploración. Al recorrer la serie aparece un kilo de mora a 42.000 pesos entre semanas de unos 4.000. Es un cero de más: vuelve a la limpieza. La exploración también muestra que sus precios suben en los mismos meses casi todos los años.
- Visualización. Dos líneas en un mismo gráfico, su precio de compra semanal y el precio mayorista de la central. No van a la misma altura, porque miden puntos distintos de la cadena. Lo que importa es si suben y bajan juntas. Si la suya sube cuando la de la central baja, el problema es de su proveedor.
- Análisis estadístico. La medida básica es la variación porcentual de una semana a otra, la misma aritmética con que el SIPSA reporta sus cambios [11]. La fórmula es (precio de esta semana − precio de la semana anterior) ÷ precio de la semana anterior × 100. Si Gladys pasó de pagar 4.000 a 4.400 pesos el kilo, su precio de compra subió 10 %. Si esa misma semana el de la central bajó, el alza no viene del mercado. Una semana así puede ser ruido; quince de veinte, ya es señal. Las notas cualitativas ayudan aquí: si las semanas caras coinciden con lotes de primera, quizá pagó por calidad.
- Machine learning. Gladys no lo necesita, y a mi juicio forzarlo sería un error. Su pregunta es una comparación, no un pronóstico, y unos pocos cientos de registros alcanzan para responderla.
- La decisión. Con el gráfico y la cifra en la mano, Gladys negocia, cambia de proveedor o acepta el precio porque el mercado entero subió. La decisión es de ella; el análisis le quita el pretexto al proveedor.
Un dato real del mismo sistema muestra por qué hace falta ese análisis. El DANE informó que en la semana del 3 al 9 de octubre de 2026 aumentaron las cotizaciones de las verduras, las frutas frescas y los tubérculos [12]. Pero en el anexo de ese mismo boletín, la mora de Castilla de Centroabastos aparece con una baja de menos del 10 %, como en la mayoría de los mercados [12]. El titular habla de un grupo de productos en todo el país. La pregunta de un comerciante es sobre un producto en una central, y un dato agregado no la responde.
Análisis de datos vs ciencia de datos: ¿en qué se diferencian?
Toda ciencia de datos incluye análisis de datos, pero no todo análisis de datos es ciencia de datos. El análisis termina cuando una pregunta tiene una respuesta confiable. La ciencia de datos abarca más: consigue y procesa datos con programación, a menudo en grandes volúmenes, y suele dejar funcionando modelos que siguen respondiendo solos.
La definición del DeCS deja ver esa relación en su propia redacción. Describe la ciencia de los datos como un campo interdisciplinario que emplea procesos, teorías, conceptos, herramientas y tecnologías para la revisión, el análisis y la extracción de conocimientos a partir de datos estructurados y no estructurados [5]. El análisis aparece ahí como una de sus tareas, al lado de otras.
Los vocabularios de referencia, además, los clasifican en ramas distintas. El análisis de datos cuelga de la matemática [2]. La ciencia de los datos cuelga de la ciencia de la información [5]. Uno es un método; la otra, un campo que reúne ese método con la computación.
El caso de Gladys muestra la frontera. Su análisis cabe en un cuaderno, una hoja de cálculo y una tarde de domingo. No necesita programar, ni guardar millones de filas, ni entrenar un modelo. Si una cadena de supermercados quisiera hacer lo mismo con miles de productos, todos los días y de forma automática, ya estaría en el terreno de la ciencia de datos.
Mi recomendación para quien empieza es aprender primero a analizar bien, con pocos datos y una buena pregunta. La escala viene después. Sin ese criterio, la escala solo multiplica los errores.
¿Qué se necesita para empezar a analizar datos?
Para empezar a analizar datos se necesita más criterio que software. Hace falta una pregunta clara, conocer el tema, manejar bien la aritmética básica, desconfiar de los propios resultados y saber contar lo encontrado con palabras sencillas. Las herramientas vienen después, y se aprenden mejor cuando ya se sabe qué se les quiere preguntar.
El análisis de datos no es propiedad de una profesión. Las pautas éticas de la ASA, aprobadas en 2022, aplican a quien practique la estadística, «sin importar el cargo, la profesión, el nivel o el área del título» [7]. Y entienden como práctica estadística diseñar la recolección, resumir, procesar, analizar, interpretar o presentar datos [7].
Ese es el perfil, en cinco requisitos:
- Una pregunta que importe. Si la respuesta no cambiaría ninguna decisión, el análisis sobra.
- Conocimiento del tema. Gladys sabe que un lote de primera cuesta más; un analista de fuera tendría que averiguarlo.
- Aritmética usada con cuidado. Porcentajes, promedios y proporciones, bien calculados y bien comparados.
- Escepticismo con los propios hallazgos. La ASA pide entender y reducir las limitaciones, defectos o sesgos, conocidos o sospechados, de los datos y de los métodos, y comunicar cómo afectan las conclusiones [7].
- Capacidad de explicar. Una conclusión que nadie entiende no llega a la decisión.
Las herramientas concretas tendrán sus guías: Excel y Python para análisis de datos. Qué hace un analista de datos como oficio, y cómo se llega a serlo, será tema de la guía de rutas y carreras en datos.
Análisis de datos: qué guía leer según lo que busca
Esta guía da la vista de conjunto del análisis de datos. Cada etapa y cada herramienta tendrá su guía propia, y la tabla las ordena según la pregunta que usted traiga. Las publicadas llevan enlace; las demás aparecen como próximas.
| Si lo que busca es… | Guía | Estado |
|---|---|---|
| La disciplina completa, de la pregunta a la decisión | Ciencia de datos | Publicada |
| Los cuatro tipos de análisis, con ejemplos | Tipos de análisis de datos | Próximamente |
| Cómo limpiar datos, sin importar la herramienta | Limpieza de datos | Próximamente |
| Cómo explorar un conjunto de datos antes de sacar conclusiones | Análisis exploratorio de datos | Próximamente |
| Dónde se guardan los datos | Bases de datos | Publicada |
| Cómo pedirle datos a una base de datos | SQL | Publicada |
| Medidas, pruebas y margen de error | Estadística para ciencia de datos | Próximamente |
| Gráficos y tableros | Visualización de datos | Próximamente |
| Analizar datos en una hoja de cálculo | Excel para análisis de datos | Próximamente |
| Analizar datos programando | Python para análisis de datos | Próximamente |
| Modelos que predicen | Machine learning | Publicada |
| Qué hace un analista de datos y cómo se llega a serlo | Analista de datos | Próximamente |
| Definiciones cortas de los términos | Glosario de ciencia de datos | Próximamente |
Si empieza de cero, le sugiero este orden: tipos de análisis, limpieza y análisis exploratorio. Antes de aprender una herramienta conviene saber qué se le va a pedir.
¿Qué no resuelve el análisis de datos?
El análisis de datos no responde preguntas sobre datos que nadie recogió, ni corrige con técnica lo que se midió mal. Tampoco convierte en causa lo que solo es coincidencia. Su alcance depende de la calidad de los datos y de la honestidad con que se declaran sus límites.
Los datos ajenos traen una advertencia propia: se recogieron con otro fin. El SIPSA calcula precios mayoristas promedio; no registra el lote que compró Gladys ni el trato con su proveedor. Esa parte solo la tiene su cuaderno, con sus notas al margen.
Vuelvo a Gladys. Opino que el punto débil de la cadena no está en los datos, porque la serie del DANE es pública y gratuita. Está en el método. Un comprador grande tiene quien cruce esas cifras cada semana. Una comerciante de la central negocia con la memoria y con la palabra del proveedor.
Mientras esa diferencia exista, el dato público sirve sobre todo a quien ya sabía usarlo.
El próximo lunes, Gladys puede llegar al puesto con un gráfico doblado dentro del cuaderno. No le garantiza un mejor precio. Le cambia la conversación: ya no discute contra la palabra del proveedor, sino contra una cifra que cualquiera puede revisar.
Preguntas frecuentes
¿El análisis exploratorio de datos es lo mismo que el análisis de datos? No: el análisis exploratorio es una forma de hacer análisis de datos, la que mira los datos antes de suponer cómo se comportan. El manual de métodos estadísticos del NIST lo llama «un enfoque o filosofía para el análisis de datos» [9]. Sus técnicas, pasos y ejemplos tendrán una guía propia, análisis exploratorio de datos, en preparación.
¿Qué es el análisis de datos secundarios? Es trabajar con datos que recogió otra persona o entidad, casi siempre con un propósito distinto del suyo. El MeSH lo define como el «análisis o reanálisis de datos existentes recogidos por otra persona, por lo general con un propósito diferente» [13]. Usar las series de precios del DANE para revisar las compras de un negocio es un ejemplo. Su ventaja es el costo; su riesgo, que los datos no midan exactamente lo que usted necesita.
¿Los datos cualitativos se pueden analizar con estadística? Sí, en parte. La ORI reconoce que el análisis en la investigación cualitativa puede incluir procedimientos estadísticos [3]. También anota que, muchas veces, ese análisis se vuelve un proceso que se repite: los datos se recogen y se analizan casi al mismo tiempo [3]. Contar cuántas veces aparece una queja es estadística; entender qué quiere decir exige leerla.
¿Se pueden reutilizar los datos del DANE en un análisis propio? Depende de la licencia de cada conjunto de datos, que el portal declara. La base de precios mayoristas del SIPSA publicada en datos.gov.co usa la licencia Creative Commons Atribución-CompartirIgual 4.0 [11]. Esa licencia permite usar y adaptar los datos citando la fuente, y obliga a compartir lo derivado con la misma licencia. Antes de publicar un análisis, revise la licencia del conjunto que usó.
Referencias
Las citas en otro idioma son traducción propia.
- Departamento Administrativo Nacional de Estadística (DANE). Sistema de información de precios y abastecimiento del sector agropecuario (SIPSA) — el SIPSA informa los precios mayoristas de los productos agroalimentarios que se comercializan en el país, los insumos y factores de la producción agrícola y el abastecimiento de alimentos en las ciudades; boletines diarios, semanales y mensuales de precios mayoristas; sección de informes trimestrales del comportamiento del precio de alimentos (Ley 2046 de 2020), con el informe «Monitoreo precios mayoristas de alimentos. III trimestre 2026» fechado el 9 de octubre de 2026. DANE: Sistema de información de precios SIPSA — Consultada: 2026-10-10.
- Biblioteca Virtual en Salud (BVS) y BIREME. DeCS – Descriptores en Ciencias de la Salud, descriptor «Análisis de Datos» (ID 57808; MeSH D000078332; fecha de establecimiento 01/01/2019) — nota de alcance: «Proceso que consiste en la aplicación sistemática de técnicas estadísticas y/o lógicas para describir e ilustrar, condensar y resumir, así como evaluar datos», con referencia a ori.hhs.gov/education; código jerárquico H01.548.338, bajo Matemática (H01.548); descriptor específico: Análisis de Datos Secundarios. DeCS: descriptor Análisis de Datos — Consultada: 2026-10-10.
- Office of Research Integrity (ORI), U.S. Department of Health and Human Services. Responsible Conduct in Data Management, sección «Data Analysis» — definición: «the process of systematically applying statistical and/or logical techniques to describe and illustrate, condense and recap, and evaluate data»; los procedimientos analíticos permiten sacar inferencias inductivas y distinguir la señal (el fenómeno de interés) del ruido (las fluctuaciones estadísticas), frase que la ORI cita de Shamoo y Resnik (2003); el análisis estadístico suele hacerse sobre datos cuantitativos y hay numerosos procedimientos diseñados para el material cualitativo; en la investigación cualitativa el análisis puede incluir procedimientos estadísticos y suele ser iterativo, con datos recogidos y analizados casi a la vez; el análisis exacto y apropiado es un componente esencial de la integridad de los datos; los análisis estadísticos inadecuados distorsionan los hallazgos y confunden a los lectores. ORI: Data Analysis, Responsible Conduct in Data Management — Consultada: 2026-10-10.
- National Library of Medicine (NLM). Medical Subject Headings (MeSH), descriptor «Data Analytics» (D000098971; número de árbol L01.305.500; introducido el 2025-01-01; nota pública: «2025; see DATA SCIENCE 2019-2024»; anotación: «Indexers: Do not use. Use DATA SCIENCE instead.») — nota de alcance del concepto M000640939: «The collection, transformation, and organization of data in order to draw conclusions, make predictions, and drive informed decision making». NLM: MeSH, Data Analytics · NLM: registro del concepto Data Analytics — Consultada: 2026-10-10.
- Biblioteca Virtual en Salud (BVS) y BIREME. DeCS – Descriptores en Ciencias de la Salud, descriptor «Ciencia de los Datos» (ID 57661; MeSH D000077488; fecha de establecimiento 01/01/2019) — nota de alcance: campo interdisciplinario que emplea procesos, teorías, conceptos, herramientas y tecnologías que permiten la revisión, el análisis y la extracción de conocimientos e información valiosos a partir de datos estructurados y no estructurados (brutos); código jerárquico L01.305, bajo Ciencia de la Información (L01); descriptor específico: Analítica de Datos (L01.305.500). DeCS: descriptor Ciencia de los Datos — Consultada: 2026-10-10.
- Naciones Unidas, División de Estadística. Principios Fundamentales de las Estadísticas Oficiales — principio 1: «Las estadísticas oficiales constituyen un elemento indispensable en el sistema de información de una sociedad democrática»; adoptados por la Comisión de Estadística en 1994 y respaldados por la Asamblea General en su resolución 68/261 (2014). Naciones Unidas: Fundamental Principles of Official Statistics — Consultada: 2026-10-10.
- American Statistical Association (ASA). Ethical Guidelines for Statistical Practice (aprobadas por la junta directiva el 1 de febrero de 2022) — «statistical practitioner» incluye a todos los que se dedican a la práctica estadística, «regardless of job title, profession, level, or field of degree»; la práctica estadística incluye diseñar la recolección, resumir, procesar, analizar, interpretar o presentar datos; principio B: entender y mitigar limitaciones, defectos o sesgos de los datos o métodos y comunicar su impacto en las conclusiones; comunicar las fuentes de datos, los procesos de generación y recolección y los sesgos conocidos; comunicar los procedimientos de procesamiento y transformación, incluido el manejo de datos faltantes; comunicar el propósito declarado y el uso previsto. ASA: Ethical Guidelines for Statistical Practice — Consultada: 2026-10-10.
- NIST/SEMATECH. e-Handbook of Statistical Methods, sección 1.1.2 «How Does Exploratory Data Analysis differ from Classical Data Analysis?» — secuencias: clásica «Problem => Data => Model => Analysis => Conclusions»; exploratoria «Problem => Data => Analysis => Model => Conclusions»; en el enfoque clásico la recolección va seguida de la imposición de un modelo; en el exploratorio, de un análisis inmediato para inferir qué modelo sería apropiado. NIST/SEMATECH: e-Handbook, sección 1.1.2 — Consultada: 2026-10-10.
- NIST/SEMATECH. e-Handbook of Statistical Methods, sección 1.1.1 «What is EDA?» — el análisis exploratorio de datos es «an approach/philosophy for data analysis that employs a variety of techniques (mostly graphical)»; metas: maximizar la comprensión del conjunto de datos, descubrir su estructura subyacente, extraer variables importantes, detectar valores atípicos y anomalías, probar supuestos, desarrollar modelos parsimoniosos. NIST/SEMATECH: e-Handbook, sección 1.1.1 — Consultada: 2026-10-10.
- Departamento Administrativo Nacional de Estadística (DANE). Estratificación socioeconómica — «La estratificación socioeconómica es una clasificación en estratos de los inmuebles residenciales que deben recibir servicios públicos»; seis estratos: bajo-bajo, bajo, medio-bajo, medio, medio-alto y alto. DANE: Estratificación socioeconómica — Consultada: 2026-10-10.
- DANE, publicado en el Portal de Datos Abiertos de Colombia. Sistema de Información de Precios y Abastecimiento del Sector Agropecuario, Componente de Precios Mayoristas – SIPSA – P – 2013 -2024 (identificador gkqq-k3k5; licencia Creative Commons Atribución-CompartirIgual 4.0) — operación del SIPSA a cargo del DANE «Desde febrero de 2012» (antes, del Ministerio de Agricultura y Desarrollo Rural); la operación requiere «un amplio equipo de personal en campo»; canasta distribuida en ocho grupos de alimentos; el precio reportado es el precio de venta mayorista promedio; «Estos precios incluyen el impuesto de valor agregado (IVA).»; indicadores de precio promedio mayorista diario, semanal y mensual y «la variación porcentual con respecto al período anterior»; bases mensuales descargables de 2013 a 2024. datos.gov.co: SIPSA, componente de precios mayoristas 2013-2024 — Consultada: 2026-10-10.
- Departamento Administrativo Nacional de Estadística (DANE). SIPSA, precios mayoristas: boletín semanal del 3 al 9 de octubre de 2026 (información actualizada el 9 de octubre de 2026) — durante la semana «aumentaron las cotizaciones de las verduras, las frutas frescas y los tubérculos»; anexo en Excel con precios por producto y mercado, hoja 1.2: «Mora de Castilla | Bucaramanga, Centroabastos | 5200 | 5600 | 5333 | -», donde «-» marca una caída de entre 0,01 % y 10 %; la mora de Castilla también bajó en la mayoría de los mercados del anexo. DANE: SIPSA, boletín semanal de precios mayoristas · DANE: anexo del boletín semanal del 3 al 9 de octubre de 2026 — Consultada: 2026-10-10.
- National Library of Medicine (NLM). Medical Subject Headings (MeSH), descriptor «Secondary Data Analysis» (D000094422; introducido el 2023-01-01; número de árbol H01.548.338.500, entre otros) — nota de alcance del concepto M000755945: «Analysis or reanalysis of existing data collected by someone else usually for a different purpose». NLM: MeSH, Secondary Data Analysis · NLM: registro del concepto Secondary Data Analysis — Consultada: 2026-10-10.
Cómo investigamos esta página
- Pregunta que responde: Qué es el análisis de datos, si es lo mismo que la analítica de datos, para qué sirve, cuáles son sus etapas y qué hace falta para empezar.
- Fuentes: identificadas 33 → incluidas 13 (vocabularios de bibliotecas públicas, la ONU, un manual técnico público, una asociación de estadística y el DANE).
- Criterios de inclusión: solo organismos públicos, vocabularios oficiales y códigos profesionales leídos hoy; ninguna enciclopedia, blog ni nota de prensa.
- Fecha de corte de los datos: 2026-10-10