
Ingeniería de datos: qué es y cómo se construye la plataforma que alimenta el análisis
La ingeniería de datos es la disciplina que diseña, construye y mantiene los sistemas que llevan los datos desde donde nacen hasta donde se usan: completos, a tiempo y en la forma acordada. Aquí verá qué estudia, para qué sirve, sus seis capas, cuánto cuesta cada una y cómo elegir tecnología según volumen, equipo, latencia y presupuesto.
Última actualización: 2026-10-11
Contenido de esta página
- ¿Qué es la ingeniería de datos?
- ¿Para qué sirve la ingeniería de datos?
- Las seis capas de la ingeniería de datos y la pregunta que responde cada una
- ¿Cuánto cuesta y qué tan rápida es cada capa?
- Elegir la tecnología correcta: volumen, equipo, latencia y presupuesto
- Un ejemplo colombiano: la TRM llega una vez al día, pero no en una fila por día
- Ingeniería de datos, big data, bases de datos y ciencia de datos: ¿en qué se diferencian?
- Ingeniería de datos: qué guía leer según lo que busca
- ¿Qué cuesta de verdad un dato roto?
El 23 de septiembre de 1999, a las 09:04:52 en hora universal, la NASA, la agencia espacial de Estados Unidos, recibió por última vez la señal de la Mars Climate Orbiter [1]. La nave había viajado nueve meses y medio para convertirse en el primer satélite meteorológico interplanetario [1]. Nunca entró en órbita.
El software a bordo calculaba bien [1]. El error estaba en tierra, en un archivo que un programa le entregaba a otro. Una especificación de interfaz fijaba el formato y las unidades de ese archivo [1]. Exigía reportar el impulso de los propulsores en newton-segundo, la unidad métrica [1]. El programa que escribía el archivo usaba libra-segundo, la unidad inglesa [1]. El software de navegación leyó cada número como métrico y subestimó por un factor de 4,45 el efecto de los propulsores sobre la trayectoria [1].
El problema no fue un sistema caído. Fue un dato que cruzó la frontera entre dos sistemas sin que ningún control revisara en qué unidad venía [1]. Al llegar a Marte, la nave iba unos 170 kilómetros más baja de lo previsto [1].
Lo que falló ahí tiene un oficio dedicado: la ingeniería de datos. Es el trabajo de tender el camino de los datos entre el sistema que los produce y la persona que los usa. Y de vigilar que lleguen enteros, a tiempo y con el formato pactado.
¿Qué es la ingeniería de datos?
La ingeniería de datos es el oficio de construir y cuidar los caminos por los que viajan los datos de una organización. Toma lo que producen sus sistemas, lo limpia y lo transforma, lo guarda y lo entrega listo para un análisis, un tablero o un modelo. Lo que entrega es un flujo de datos confiable; las conclusiones las saca otro.
El problema que resuelve es concreto. Las organizaciones necesitan reunir datos de muchas fuentes, en formatos distintos, y llevarlos a uno o varios almacenes de datos [2]. El destino no siempre es del mismo tipo que el origen, y casi siempre hay que dar forma, limpiar o transformar los datos antes de cargarlos [2].
Cada uno de esos caminos se llama pipeline de datos: una cadena de pasos automáticos que mueve datos de un sistema a otro y los transforma por el camino [2]. Uno de esos esquemas es el ETL, sigla en inglés de extraer, transformar y cargar. Primero se sacan los datos de sus fuentes, luego se modifican según las reglas del negocio y al final se cargan en su destino [2]. En la variante ELT, la transformación ocurre después de cargar, dentro del propio almacén de destino [2].
El NIST es el Instituto Nacional de Estándares y Tecnología de Estados Unidos. Entre los especialistas que intervienen en la ciencia de datos, describe al ingeniero de datos por su tarea: transformar los datos para dejarlos listos para el análisis [3].
Piense en el acueducto de su ciudad. Nadie abre la llave pensando en la bocatoma, la planta de tratamiento o la red de tubos. Solo nota que existen el día en que el agua llega turbia o no llega. La ingeniería de datos es el acueducto de los datos, y se juzga igual: por lo que no pasa.
¿Qué estudia la ingeniería de datos?
La ingeniería de datos estudia cómo mover, transformar, guardar y entregar datos de forma confiable y a un costo razonable. Sus temas siguen el recorrido del dato: de qué fuentes sale, cómo entra, cómo se transforma, dónde se guarda, qué infraestructura lo sostiene y cómo llega a quien lo usa. Cada uno de esos temas es una de las seis capas que verá más abajo.
¿Busca la carrera, con su pensum, sus universidades o el salario de un ingeniero de datos? Eso corresponde a la guía de rutas y carreras en datos, en preparación. Esta página trata la disciplina, no el puesto de trabajo.
¿Para qué sirve la ingeniería de datos?
La ingeniería de datos sirve para que quien decide reciba los datos en tres condiciones: sin faltantes, a la hora en que los necesita y con el formato que se acordó. Sin ella, cada análisis empieza con alguien que copia archivos a mano. Y cada reporte depende de que esa persona no se equivoque, no se enferme y no salga a vacaciones.
La Mars Climate Orbiter muestra cómo se ve la falta. Durante los primeros cuatro meses de vuelo, los archivos que producía el software de tierra traían errores de formato y el equipo de navegación no los usó [1]. En su lugar, el contratista le avisaba por correo electrónico cada vez que la nave encendía los propulsores [1]. Con esa hora, los navegantes intentaban calcular el efecto por su cuenta [1].
Los archivos con el formato correcto llegaron en abril de 1999 [1]. En menos de una semana mostraron datos anómalos: indicaban que se estaba subestimando el efecto de esos encendidos sobre la trayectoria [1]. El equipo notó la anomalía, pero la causa apareció el 29 de septiembre, seis días después de perder la nave [1].
La junta que investigó el accidente lo resumió en su informe del 10 de noviembre de 1999. Reconoció que en los proyectos espaciales ocurren errores y que suele haber procesos para atraparlos a tiempo. Esta vez, escribió, «la causa raíz no fue detectada por los procesos vigentes en el proyecto MCO» [1]. MCO es la sigla de la nave.
Para la misión siguiente, la Mars Polar Lander, recomendó algo que es ingeniería de datos pura [1]. Pidió auditar que todos los datos transferidos entre el equipo de navegación y el de operaciones de la nave cumplieran la especificación de interfaz [1].
Ese es el aporte de la disciplina en cualquier organización, no solo en la NASA. Pone el dato donde se necesita, a la hora en que se necesita, y pone controles técnicos en cada paso. Qué es un dato de calidad, cómo se mide y quién responde por él es asunto del gobierno de datos, que tendrá su guía propia.
Las seis capas de la ingeniería de datos y la pregunta que responde cada una
Un sistema de datos se puede leer en seis capas: fuentes, ingesta, pipelines, almacenamiento, plataforma y servicio. Cada capa responde una pregunta distinta sobre el recorrido del dato. La división en seis es mía, para ordenar esta guía. Las guías de arquitectura de Microsoft y de AWS (Amazon Web Services, la nube de Amazon) describen las mismas piezas con otros nombres y otros cortes [2][4][5].
- Fuentes. ¿De dónde salen los datos? De bases de datos, sensores, celulares, servicios en la nube y aplicaciones [6]. También de una API, la puerta por la que un programa le pide datos a otro.
- Ingesta. ¿Cómo entran los datos y cada cuánto? Por lotes, en paquetes que se mueven cada cierto tiempo, o en flujo continuo, evento por evento, apenas ocurre [6][7]. En inglés se les llama batch y streaming.
- Pipelines. ¿Cómo se limpian y transforman? Con operaciones como filtrar, ordenar, agregar, cruzar tablas, limpiar, quitar duplicados y validar [2].
- Almacenamiento. ¿Dónde se guardan y por cuánto tiempo? Hay dos grandes opciones [8]. El almacén de datos o data warehouse impone una estructura y transforma los datos al recibirlos. El lago de datos o data lake los guarda en su formato original y los transforma solo cuando se necesitan.
- Plataforma. ¿Qué mantiene todo funcionando? Los servidores o la nube, el monitoreo y un orquestador: el programa que agenda las tareas, ejecuta los flujos y coordina el orden entre ellas [4].
- Servicio. ¿Quién usa los datos y cómo los recibe? Un tablero, un reporte, una API o un modelo de machine learning, la rama de la inteligencia artificial que aprende de ejemplos.
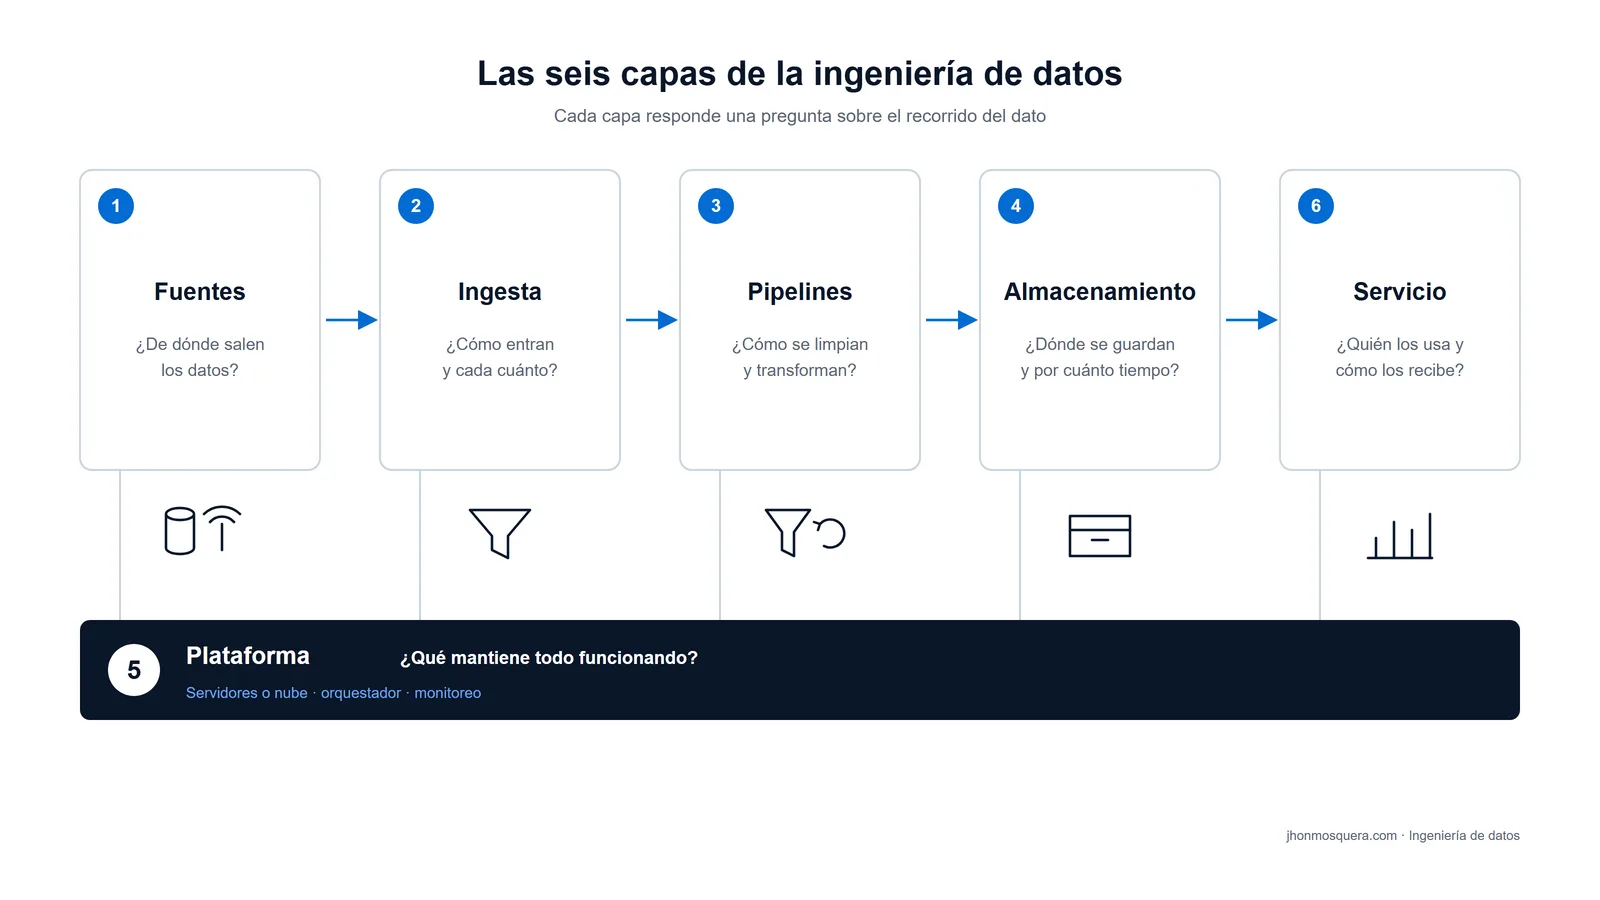
La plataforma va debajo de la fila: es el piso sobre el que corren los otros cinco. Cada capa tendrá su guía; aquí solo se presentan.
¿Cuánto cuesta y qué tan rápida es cada capa?
Cada capa de la ingeniería de datos cobra por algo distinto y entrega a una velocidad distinta. La ingesta cobra por el volumen que pasa, la transformación por los datos que procesa y el almacenamiento por el espacio y el tiempo que guarda. La tabla usa como referencia precios de lista de Google Cloud consultados el 11 de octubre de 2026. No es una recomendación de proveedor.
En la tabla, latencia es el tiempo que tarda un dato en llegar de un punto a otro. Un GiB (gibibyte) equivale casi a un gigabyte, y un TiB (tebibyte), a unos 1.100 gigabytes. Y código abierto quiere decir que el programa es público y se usa sin pagar licencia.
| Capa | Qué se paga | Precio de referencia | Rapidez documentada |
|---|---|---|---|
| Fuentes | Consultar el sistema de origen | La TRM en datos.gov.co se consulta gratis, con licencia abierta [9] | La fuente marca el ritmo: la TRM se actualiza una vez al día [9] |
| Ingesta | El volumen que entra y sale (en Pub/Sub, un servicio de mensajería de Google Cloud) | Los primeros 10 GiB de cada mes son gratis; luego, 40 dólares por TiB [10] | Latencias típicas del orden de 100 milisegundos [11] |
| Pipelines | Los datos que procesa cada consulta (en BigQuery, el almacén de datos de Google Cloud) | El primer TiB de cada mes es gratis; luego, 6,25 dólares por TiB en la región de Iowa [12] | La fija el horario del proceso: Airflow, por ejemplo, programa flujos que corren a diario [7] |
| Almacenamiento | El espacio guardado y, en las clases frías, cada lectura | Clase Standard: sin plazo mínimo ni tarifa de recuperación. Clase Archive: mínimo 365 días y 0,05 dólares por cada GiB que se lee [13][14] | Milisegundos, incluso en la clase Archive [13] |
| Plataforma | Operar el orquestador, los servidores y el monitoreo | Airflow es código abierto y puede correr como un solo proceso en un portátil [7] | No acelera nada: decide cuándo corre cada tarea [4] |
| Servicio | Las consultas repetidas de tableros y usuarios | Cada consulta bajo demanda se cobra por los datos que lee; particionar las tablas reduce esa cifra [12] | Depende de las capas anteriores |
Fuente: documentación oficial de cada servicio y proyecto, consultada el 11 de octubre de 2026 [7][9][10][11][12][13][14]. Son precios de lista en dólares; quien paga en otra moneda recibe los precios publicados para esa moneda [12].
Lo que un economista ve en esa tabla
La tabla esconde un precio relativo, la razón entre dos precios que obliga a escoger. La clase Archive cuesta menos por guardar, pero cobra cada lectura y exige pagar al menos un año [13][14]. Google la recomienda para datos que se consultan menos de una vez al año [13]. Lo barato de guardar sale caro de leer.
AWS, en su guía de buenas prácticas para analítica, describe dos decisiones de diseño con el mismo dilema. Separar el almacenamiento del cómputo permite administrar el costo de cada uno por aparte [5]. Y juntar los registros en paquetes antes de enviarlos aumenta el rendimiento, es decir, los datos que pasan por segundo, a costa de más latencia [5].
Lo que sigue ya no lo dicen esas guías; lo digo yo, como economista. La partida más cara no aparece en la factura de la nube. Es el error que entra en la ingesta y se descubre en el servicio, cuando ya alimentó decisiones. En la Mars Climate Orbiter, esa cuenta llegó entera el último día.
Elegir la tecnología correcta: volumen, equipo, latencia y presupuesto
No existe una tecnología de datos que sirva igual de bien para todos los casos. La elección correcta depende de cuatro variables: cuántos datos hay, qué tan rápido deben llegar, quién va a operar el sistema y cuánto dinero hay para pagarlo. La misma herramienta que resuelve el problema de un banco puede hundir a una pyme en costos y en mantenimiento.
AWS lo plantea como buena práctica en su Data Analytics Lens (2023): cada paso del proceso de analítica es una oportunidad para escoger la herramienta adecuada [5]. Y advierte: «escoger una tecnología inadecuada puede introducir problemas de rendimiento, especialmente al procesar datos a escala» [5].
Los criterios de la tabla salen de las guías de selección de Microsoft y de AWS y de la documentación de los proyectos Apache [4][5][6][7]. El orden y las recomendaciones son míos.
| Variable | Pregunta que debe hacerse | Si la respuesta es… | Punto de partida razonable |
|---|---|---|---|
| Latencia | ¿Cuánto puede esperar la decisión? | Horas o un día | Procesos por lotes con horario, coordinados por un orquestador como Airflow [7] |
| Latencia | ¿Cuánto puede esperar la decisión? | Segundos o menos | Una plataforma de flujo de eventos, como Kafka o un servicio gestionado de mensajería [6][11] |
| Volumen | ¿Necesita mover y transformar datos de varios gigabytes a terabytes? | Sí | Microsoft llama a eso capacidades de big data y recomienda un servicio diseñado para big data [4] |
| Equipo | ¿Hay alguien dedicado a operar servidores? | No | Un servicio gestionado en la nube, que no depende de equipos propios [4] |
| Equipo | ¿El equipo programa? | Sí, en Python | Flujos definidos como código, como en Airflow; ahí, quien prefiere hacer clic tendrá que programar algo de todos modos [7] |
| Presupuesto | ¿Hay dinero para licencias? | No | Software de código abierto, como Airflow y Kafka, y las capas gratuitas de los servicios en la nube [6][7][10][12] |
| Presupuesto | ¿El uso es irregular o constante? | Irregular | Pago por uso, por volumen procesado [12] |
| Presupuesto | ¿El uso es irregular o constante? | Constante y alto | Capacidad contratada, con un costo predecible [12] |
Así uso la tabla, en este orden:
- Empiece por la latencia. Es la variable que más cambia la arquitectura: pasar de un día a un segundo cambia casi todas las piezas.
- Mida el volumen después. Muchos problemas que parecen grandes caben en un solo servidor bien configurado.
- Cuente las personas. Una herramienta que nadie en la organización sabe operar es una deuda, aunque la licencia sea gratis.
- Cierre con el presupuesto. El precio de lista es la parte visible; el costo de operar y de equivocarse suele pesar más.
Le doy a la latencia el primer lugar porque es la única variable que el negocio fija desde afuera. El volumen se puede reducir, el equipo se puede formar y el presupuesto se puede negociar. La espera que tolera una decisión, en cambio, rara vez se discute.
Para una organización colombiana pequeña, mi recomendación es casi siempre la misma. Empiece con lotes diarios, un orquestador libre y una base de datos que ya conozca. Pase al flujo continuo solo cuando una decisión concreta pierda dinero por esperar un día.
Un ejemplo colombiano: la TRM llega una vez al día, pero no en una fila por día
La TRM, la tasa de cambio oficial del dólar en Colombia, es una buena fuente para un primer pipeline. Corresponde al promedio ponderado de las compras y ventas de dólares de contado [9]. La Superintendencia Financiera la publica en datos.gov.co, el portal de datos abiertos del Estado, con actualización diaria y licencia abierta [9].
Lo consulté el 11 de octubre de 2026. El conjunto tenía 8.365 filas y cuatro columnas: el valor, la unidad, la fecha de inicio de la vigencia y la fecha de fin [9]. La serie empieza el 2 de diciembre de 1991 [9].
Un ingeniero apurado supondría una fila por día. Se equivocaría.
La última fila vale 3.194,44 pesos y rige del sábado 10 al martes 13 de octubre de 2026 [9]. Una sola fila cubre cuatro días.
No es un caso raro. En la misma consulta, más de una de cada cinco filas abarcaba más de un día: 1.941 en total [9].
Un pipeline que cruce la TRM con ventas diarias tiene que repartir cada fila entre los días que cubre. Si no lo hace, los fines de semana quedan sin tasa y cualquier cálculo en dólares de esos días sale vacío. Es la lección de la Mars Climate Orbiter a escala de pyme: el formato del dato es un acuerdo, y hay que leerlo antes de cargar.
Montar ese pipeline no cuesta licencias. La consulta en datos.gov.co es gratuita, y la licencia permite reutilizar los datos citando la fuente y compartiendo las versiones modificadas con la misma licencia [9]. Airflow es código abierto [7]. BigQuery deja procesar sin costo el primer TiB de consultas de cada mes [12].
Software sobra. Lo escaso es alguien que lea las columnas de vigencia antes de suponer.
Ingeniería de datos, big data, bases de datos y ciencia de datos: ¿en qué se diferencian?
La ingeniería de datos construye el camino de los datos; las disciplinas vecinas trabajan sobre lo que ese camino entrega o sobre las reglas que lo gobiernan. Se cruzan todo el tiempo, pero cada una responde una pregunta distinta.
El big data aparece cuando el volumen, la velocidad o la variedad de los datos obligan a repartir el trabajo entre muchas máquinas. Esa guía explica el paradigma y el procesamiento distribuido. Muchos pipelines no lo necesitan: el de la TRM, que vio más arriba, cabe de sobra en un solo computador.
Las bases de datos son uno de los destinos y de los orígenes del recorrido. Y el SQL, el lenguaje estándar para pedirle datos a una base, es la herramienta con que se escriben muchas transformaciones.
La ciencia de datos y el análisis de datos usan lo que la ingeniería entrega para responder preguntas. La comparación desarrollada entre ingeniería y ciencia de datos tendrá su propia guía.
Las reglas sobre calidad, privacidad y quién puede ver qué dato pertenecen al gobierno de datos, con guía en preparación. Y el oficio, la formación y el salario del ingeniero de datos, a la guía de rutas y carreras en datos.
Ingeniería de datos: qué guía leer según lo que busca
Esta tabla ordena las guías de ingeniería de datos y las páginas vecinas por la pregunta que resuelven. Las que dicen «Próximamente» están en preparación.
| Si lo que busca es… | Guía | Estado |
|---|---|---|
| Las etapas del dato, de la fuente al uso | Ciclo de vida de la ingeniería de datos | Próximamente |
| Qué hace cada disciplina y dónde se cruzan | Ingeniería de datos vs ciencia de datos | Próximamente |
| De dónde salen los datos: API, registros, aplicaciones, sensores | Fuentes de datos | Próximamente |
| Cómo entran los datos: por lotes, en tiempo real o mixto | Ingesta de datos | Próximamente |
| Qué es un pipeline, cómo se arma y cómo se orquesta | Pipelines de datos | Próximamente |
| Cómo se diseña un almacén de datos para analizar | Data warehouse | Próximamente |
| Qué es un lago de datos y cuándo conviene | Data lake | Próximamente |
| Qué ofrece la nube para datos y cómo elegir proveedor | La nube para datos | Próximamente |
| Qué es Kafka, la plataforma de eventos de código abierto, y cuándo usarla | Apache Kafka | Próximamente |
| Cómo se vuelve confiable un pipeline: pruebas, despliegue, monitoreo | DevOps para datos | Próximamente |
| Qué es tratar los datos como producto de cada área | Data mesh | Próximamente |
| Qué lenguajes se usan y para qué | Lenguajes para ingeniería de datos | Próximamente |
| Qué se sacrifica cuando un sistema se reparte entre máquinas | Teorema CAP | Próximamente |
| Cuándo agrandar una máquina y cuándo añadir más | Escalado horizontal vs vertical | Próximamente |
| Cuándo el volumen obliga a repartir el trabajo | Big data | Publicada |
| Dónde se guardan los datos y qué tipos de base hay | Bases de datos | Publicada |
| Cómo pedirle datos a una base de datos | SQL | Publicada |
| El método para sacar conclusiones de los datos | Análisis de datos | Publicada |
| Modelos que aprenden de los datos | Machine learning | Publicada |
| La disciplina completa, de la pregunta a la decisión | Ciencia de datos | Publicada |
| Calidad, privacidad y reglas sobre los datos | Gobierno de datos | Próximamente |
| Qué hace un ingeniero de datos, cómo se forma y cuánto gana | Rutas y carreras en datos | Próximamente |
¿Qué cuesta de verdad un dato roto?
La junta de la Mars Climate Orbiter dio por hecho que los errores ocurren. Lo que señaló fue que los procesos del proyecto no atraparon este [1].
Opino que ahí está la definición más útil de la ingeniería de datos. Más que mover datos, es poner controles en las fronteras entre sistemas, el lugar donde nadie se siente dueño del dato.
En una alcaldía de Santander o en una pyme de Bucaramanga, esa frontera suele ser una persona que descarga un archivo cada lunes y lo pega en otro. El costo de ese puente humano no aparece en ninguna factura, y por eso casi nadie lo mide. Lo pagan las decisiones que se toman con el dato equivocado, y las pagan primero las organizaciones que no tienen con qué repetir el trabajo.
La buena noticia es que el camino de entrada es barato: datos públicos, software libre y capas gratuitas en la nube. Lo que hace falta es criterio, y el criterio se forma.
La pregunta para usted no es qué herramienta comprar. Es cuál de sus datos cruza hoy una frontera sin que nadie revise en qué unidad viene.
Preguntas frecuentes
¿Se necesita la nube para hacer ingeniería de datos? No. Kafka, por ejemplo, se instala en servidores físicos, en máquinas virtuales o en contenedores, dentro de la propia organización o en la nube [6]. Además, quien lo prefiera puede operarlo por su cuenta o contratarlo como servicio gestionado a varios proveedores [6]. La nube alquila capacidad cuando la propia no alcanza o cuando nadie puede administrarla.
¿Qué es un pipeline de datos, en palabras simples? Es una receta que el computador sigue solo: por lotes, a una hora fija, o sin parar, a medida que llegan los eventos. Cada paso toma los datos del anterior: los trae, los corrige, los combina y los deja en su sitio. En Airflow, la receta se escribe en Python y se le indica, por ejemplo, que corra todos los días [7]. Si un paso falla, se puede volver a correr solo ese paso [7].
¿Ingeniería de datos y big data son lo mismo? No: la ingeniería de datos lleva cualquier dato de un sistema a otro, sea grande o pequeño, y cuándo hace falta repartir el trabajo entre muchas máquinas lo explica la guía de big data.
¿Qué lenguajes se usan en ingeniería de datos? Depende de la capa. Para transformar datos dentro de una base se usa SQL, que tiene su guía propia. Para definir y coordinar los flujos aparece Python: Airflow los escribe por completo en ese lenguaje [7]. Para el flujo continuo, Kafka ofrece clientes en Java, Scala, Go, Python y otros lenguajes [6].
¿Cuánto cuesta empezar con ingeniería de datos? Puede costar cero en licencias. Airflow y Kafka son proyectos de código abierto de la Fundación Apache [6][7]. En la nube, BigQuery no cobra los primeros 10 GiB de almacenamiento activo de cada mes [12]. Lo que sí cuesta es el tiempo de quien aprende, y ese costo conviene contarlo desde el principio.
Referencias
Las citas en otro idioma son traducción propia.
- NASA, Mars Climate Orbiter Mishap Investigation Board. Phase I Report (10 de noviembre de 1999) — lanzamiento el 11 de diciembre de 1998; última señal hacia las 09:04:52 UTC del 23 de septiembre de 1999; objetivo de ser el primer satélite meteorológico interplanetario; viaje de nueve meses y medio; causa raíz: uso de unidades inglesas en un archivo de software de tierra, cuando la especificación de interfaz (SIS) exigía newton-segundo; el software a bordo usaba unidades métricas y era correcto; subestimación por un factor de 4,45; trayectoria unos 170 km más baja de lo previsto; en los primeros cuatro meses los archivos no se usaron por errores de formato y el equipo de navegación recibía avisos por correo del contratista; desde abril de 1999, archivos con formato correcto y anomalías visibles en menos de una semana; «the root cause was not caught by the processes in-place in the MCO project»; recomendación de auditar el cumplimiento de la SIS en todos los datos transferidos entre equipos. NASA: Mars Climate Orbiter Mishap Investigation Board, Phase I Report — Consultada: 2026-10-11.
- Microsoft. Extract, transform, and load (ETL), Azure Architecture Center (actualizada el 15 de septiembre de 2025) — las organizaciones necesitan reunir datos de múltiples fuentes y formatos y moverlos a uno o más almacenes; el destino puede ser de otro tipo y los datos suelen requerir limpieza o transformación; definición de ETL; operaciones de transformación (filtrar, ordenar, agregar, unir, limpiar, deduplicar y validar); ELT difiere solo en dónde ocurre la transformación, que se hace en el almacén de destino. Microsoft Learn: Extract, transform, and load (ETL) — Consultada: 2026-10-11.
- NIST Big Data Public Working Group. NIST Big Data Interoperability Framework: Volume 1, Definitions (Special Publication 1500-1r2, versión 3, octubre de 2019) — entre los especialistas de la ciencia de datos, los ingenieros de datos transforman los datos para prepararlos para la analítica. NIST: SP 1500-1r2, Volume 1 Definitions — Consultada: 2026-10-11.
- Microsoft. Choose a data pipeline orchestration technology in Azure, Azure Architecture Center (actualizada el 8 de noviembre de 2025) — un orquestador de pipelines automatiza los flujos: agenda trabajos, ejecuta flujos y coordina dependencias entre tareas; criterios de selección: si se necesitan capacidades de big data para mover y transformar los datos, que suelen usar de varios GB a TB, elegir un servicio diseñado para big data; servicio gestionado que no dependa de la capacidad local; fuentes locales; complejidad del flujo. Microsoft Learn: Choose a data pipeline orchestration technology — Consultada: 2026-10-11.
- Amazon Web Services. Data Analytics Lens, AWS Well-Architected Framework (publicación del 22 de diciembre de 2023) — buena práctica 8.1: considerar cada paso del proceso de analítica como una oportunidad para identificar la herramienta adecuada; «Choosing inappropriate technology can introduce performance issues, especially when processing data at scale»; buena práctica 11.1: desacoplar almacenamiento y cómputo para administrar sus costos por separado; agrupar registros antes de enviarlos aumenta el volumen procesado a costa de más latencia. AWS: Data Analytics Lens — Consultada: 2026-10-11.
- The Apache Software Foundation. Introduction, documentación de Apache Kafka 4.3 (modificada el 22 de mayo de 2026), y portada del proyecto — Kafka es una plataforma de código abierto de flujo de eventos; captura datos en tiempo real desde bases de datos, sensores, dispositivos móviles, servicios en la nube y aplicaciones; se despliega en servidores físicos, máquinas virtuales y contenedores, en instalaciones propias o en la nube, autogestionado o como servicio gestionado; clientes para Java, Scala, Go, Python y otros lenguajes. Apache Kafka: Introduction 4.3 · Apache Kafka: portada del proyecto — Consultada: 2026-10-11.
- The Apache Software Foundation. What is Airflow?, documentación de Apache Airflow 3.3.2 — plataforma de código abierto para desarrollar, agendar y monitorear flujos de trabajo orientados a lotes; puede correr desde un solo proceso en un portátil hasta un sistema distribuido; flujos definidos por completo en Python; ejemplo de un flujo programado para correr a diario; permite reejecutar solo las tareas fallidas; quien prefiere hacer clic en vez de programar quizá no encuentre en Airflow la mejor opción. Apache Airflow: What is Airflow? (3.3.2) — Consultada: 2026-10-11.
- Microsoft. What is a data lake?, Azure Architecture Center (actualizada el 21 de abril de 2026) — un lago de datos guarda grandes volúmenes en su formato original y aplica la transformación solo cuando se necesitan los datos (esquema en lectura); un almacén de datos impone la estructura y transforma al recibirlos (esquema en escritura). Microsoft Learn: What is a data lake? — Consultada: 2026-10-11.
- Superintendencia Financiera de Colombia, publicado en el Portal de Datos Abiertos de Colombia. Tasa de Cambio Representativa del Mercado – TRM (identificador 32sa-8pi3; licencia Creative Commons Atribución-CompartirIgual 4.0; frecuencia de actualización diaria) — la TRM es el promedio ponderado de las operaciones de compra y venta de contado de dólares; columnas valor, unidad, vigenciadesde y vigenciahasta; consulta a la API del portal el día de la consulta: 8.365 filas, primera vigencia el 2 de diciembre de 1991, 1.941 filas con vigencia de más de un día y última fila de 3.194,44 pesos vigente del 10 al 13 de octubre de 2026. datos.gov.co: Tasa de Cambio Representativa del Mercado – TRM — Consultada: 2026-10-11.
- Google Cloud. Pub/Sub pricing — los primeros 10 GiB de volumen de entrega de mensajes de cada mes calendario son gratis; después, 40 dólares por TiB en todas las regiones. Google Cloud: Pub/Sub pricing — Consultada: 2026-10-11.
- Google Cloud. What is Pub/Sub?, documentación de Pub/Sub (actualizada el 9 de octubre de 2026) — servicio de mensajería asíncrona con latencias típicamente del orden de 100 milisegundos, usado en analítica en flujo continuo y en pipelines de integración de datos. Google Cloud: Pub/Sub overview — Consultada: 2026-10-11.
- Google Cloud. BigQuery pricing — modelo bajo demanda que cobra por los bytes que procesa cada consulta; el primer TiB de cada mes es gratis y luego cuesta 6,25 dólares por TiB en la región de Iowa (us-central1); la partición y el agrupamiento de tablas reducen los datos procesados; modelo de capacidad para un costo predecible; los primeros 10 GiB de almacenamiento lógico activo de cada mes son gratis; quien paga en otra moneda recibe los precios publicados para esa moneda. Google Cloud: BigQuery pricing — Consultada: 2026-10-11.
- Google Cloud. Storage classes, documentación de Cloud Storage (actualizada el 9 de octubre de 2026) — en la clase Archive los datos están disponibles en milisegundos, con costos más altos de acceso, duración mínima de 365 días y recomendación de uso para datos consultados menos de una vez al año. Google Cloud: Storage classes — Consultada: 2026-10-11.
- Google Cloud. Cloud Storage pricing — duración mínima de almacenamiento: ninguna en Standard y 365 días en Archive; tarifa de recuperación: 0 dólares en Standard y 0,05 dólares por GiB en Archive. Google Cloud: Cloud Storage pricing — Consultada: 2026-10-11.
Cómo investigamos esta página
- Pregunta que responde: Qué es la ingeniería de datos, qué estudia, en qué seis capas se organiza, cuánto cuesta y qué tan rápida es cada una, y cómo elegir tecnología.
- Fuentes: identificadas 21 → incluidas 14
- Criterios de inclusión: solo informes oficiales, organismos de estándares, documentación oficial de proyectos y proveedores y datos abiertos leídos hoy; ninguna enciclopedia, blog ni curso.
- Fecha de corte de los datos: 2026-10-11