
Big data: qué es y por qué el volumen cambió la forma de procesar datos
Big data son datos tan grandes, rápidos, variados o cambiantes que un solo computador ya no los procesa con eficiencia, así que se reparten entre muchas máquinas que trabajan en paralelo. Aquí verá qué lo distingue, sus V con señales prácticas de umbral, cómo funciona, las cuatro capas de una plataforma y para qué sirve.
Última actualización: 2026-10-11
Contenido de esta página
- ¿Qué es big data?
- ¿Cómo funciona el big data?
- Las V del big data: qué mide cada una y cuándo se vuelve un problema
- ¿Por qué el costo de almacenar cambió la pregunta?
- ¿Para qué sirve el big data?
- Big data y análisis de datos: ¿en qué se diferencian?
- Las cuatro capas de una plataforma de big data
- Big data en Colombia: la política de 2018 y la puerta gratuita
- Big data: qué guía leer según lo que busca
- ¿Qué no resuelve el big data?
Herman Hollerith conocía el problema desde adentro: había trabajado en la Oficina del Censo de Estados Unidos [1]. El censo de 1880 se tabuló con hojas de conteo y una máquina de apoyo que no dio abasto, y las cifras finales no estuvieron listas hasta 1887 [1]. Siete años para sumar un país.
Hollerith inventó una máquina que leía tarjetas perforadas, una por cada persona censada. Cada agujero cerraba un circuito eléctrico y hacía avanzar el contador del rasgo correspondiente [1]. Con una flota de esas máquinas en alquiler, el censo de 1890 terminó meses antes de lo previsto y muy por debajo del presupuesto [1].
Ciento trece años después, tres ingenieros de Google contaron cómo resolvían el mismo atasco a otra escala [2]. Manejaban colecciones de muchos terabytes, es decir, de miles de gigabytes, con miles de millones de objetos como páginas web [2]. Su respuesta fue la contraria a la de Hollerith. No construyeron una máquina mejor. Juntaron más de mil computadores comunes y diseñaron el sistema dando por hecho que algunos fallarían todo el tiempo [2].
Ese giro tiene nombre: big data. Ocurre cuando los datos crecen tanto, llegan tan rápido o cambian tanto de forma que una sola máquina ya no da abasto, y el trabajo se reparte entre muchas [3]. No lo marca una cantidad mágica de gigas, sino el momento en que el volumen obliga a cambiar la manera de trabajar.
¿Qué es big data?
Big data designa conjuntos de datos tan extensos en volumen, velocidad, variedad o variabilidad que exigen una arquitectura escalable para guardarlos, manipularlos y analizarlos con eficiencia [3]. Escalable quiere decir que el sistema atiende más carga cuando se le añaden recursos [3]. Así lo define el NIST, el Instituto Nacional de Estándares y Tecnología de Estados Unidos, en su marco de referencia sobre big data [3].
La definición tiene dos mitades, y la segunda es la que suele olvidarse. Una habla de los datos. La otra habla de la arquitectura, es decir, de cómo se organizan las máquinas que los procesan. Para el NIST, el salto ocurre cuando las características de los datos obligan a paralelizar el trabajo para manejarlos a un costo razonable [3]. Paralelizar significa repartirlo en un clúster, un grupo de computadores conectados que operan como uno solo [3].
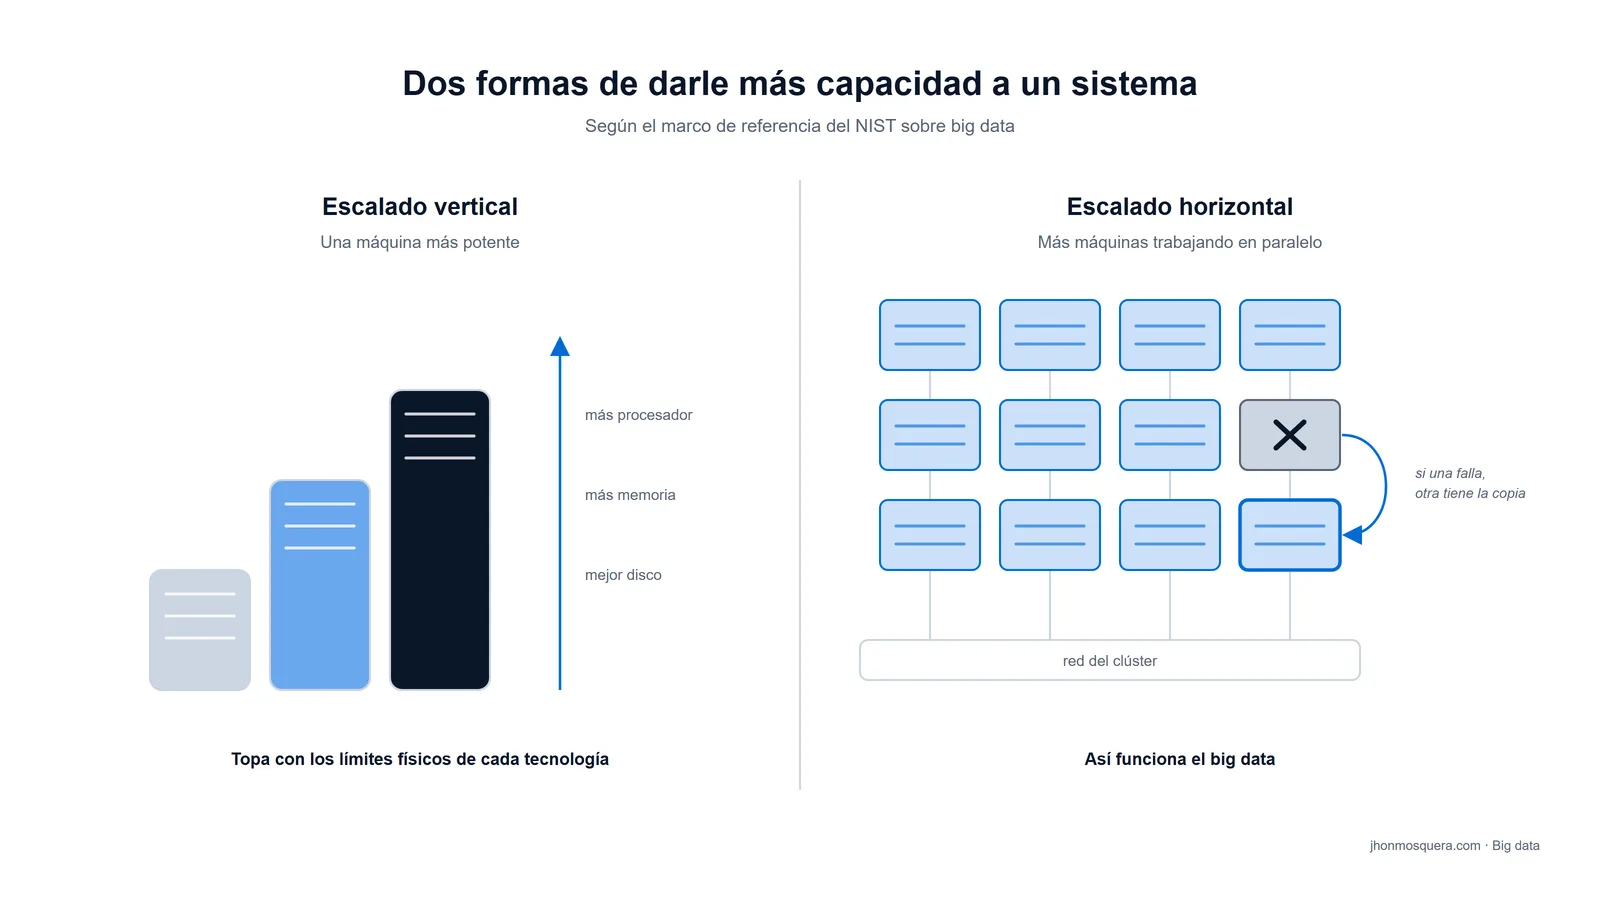
Hay dos maneras de darle más capacidad a un sistema. La primera es mejorar la máquina que ya existe, con un procesador más rápido, más memoria o un disco mejor: el NIST la llama escalado vertical [3]. Esa vía topa con los límites físicos de cada tecnología, y al acercarse a ellos ha hecho falta inventar tecnologías nuevas [3]. La segunda es añadir máquinas que trabajen en paralelo, lo que llama escalado horizontal [3].
Piense en un almuerzo para doscientos invitados. Puede comprar una olla gigante o prender veinte fogones. Big data es la decisión de prender fogones.
¿Cómo funciona el big data?
Un sistema de big data funciona con tres movimientos. Parte los datos en bloques y guarda cada bloque en varias máquinas a la vez [4]. Luego lleva el cálculo hasta donde están los bloques, en lugar de traer todos los datos a un solo computador [4]. Cada máquina procesa su parte en paralelo con las demás y, al final, un proceso reúne los resultados parciales en una sola respuesta [5].
Apache Hadoop, un proyecto de código abierto, lo hace con HDFS, su sistema de archivos distribuido: un programa que reparte cada archivo entre muchas máquinas [4]. HDFS corta los archivos en bloques que típicamente miden 128 megabytes [4]. Con la configuración habitual guarda tres copias de cada bloque, de modo que si una máquina falla los datos siguen disponibles [4]. Su documentación resume la idea en una frase de diseño: mover el cálculo es más barato que mover los datos [4].
El cálculo repartido tiene su modelo clásico en MapReduce, que Google describió en 2004 [5]. En el primer paso, llamado map, cada máquina recorre su pedazo de datos y produce resultados parciales. En el segundo, llamado reduce, se juntan los parciales que comparten una misma clave, por ejemplo una palabra, y se combinan, por ejemplo sumándolos [5].
Funciona como un escrutinio de votos. Cada mesa cuenta sus tarjetones y entrega su acta; después alguien suma las actas por candidato. Nadie cuenta los votos de todo el país en una sola mesa.
Lo que distingue a este diseño es su actitud ante el error. Ghemawat, Gobioff y Leung lo dejaron escrito en The Google File System (2003): «las fallas de los componentes son la norma y no la excepción» [2]. Con cientos o miles de máquinas baratas, alguna está dañada en cualquier momento; por eso el sistema se vigila, detecta los errores y se recupera solo [2].
Hadoop y Apache Spark, un motor de código abierto para analizar datos repartidos entre máquinas [12], tendrán cada uno su guía. También la tendrá el reparto de trabajo entre máquinas.
Las V del big data: qué mide cada una y cuándo se vuelve un problema
Las V del big data son las características de los datos que obligan a cambiar de arquitectura. El NIST reconoce cuatro como decisivas: volumen, velocidad, variedad y variabilidad [3]. Otras dos, veracidad y valor, importan para el análisis, pero no cambian por sí solas la forma de construir el sistema [3]. La primera formulación del término, de 2001, hablaba solo de tres: volumen, velocidad y variedad [6].
Volumen es el tamaño del conjunto de datos [3]. Es la V más conocida y la que primero empujó a repartir el almacenamiento y el cálculo, porque procesar conjuntos enormes en una sola máquina costaba demasiado tiempo y dinero [3].
Velocidad es el ritmo al que llegan los datos [3]. Cuando hay que decidir mientras el dato pasa, como al frenar un fraude con tarjeta, se procesa en memoria [3]. Se analiza antes de guardarlo en disco, o sin llegar a guardarlo [3]. El NIST anota que esa urgencia puede exigir varias máquinas aunque los datos sean relativamente pocos [3].
Variedad es mezclar datos de muchas fuentes, temas o tipos: tablas, textos, imágenes, videos [3]. Para el NIST, el volumen y la velocidad abaratan y aceleran el análisis, pero es la variedad la que permite resultados que antes no eran posibles [3].
Variabilidad son los cambios del conjunto: en su ritmo, en su formato o en su tamaño [3]. Piense en una tienda en línea durante una temporada de descuentos, cuando la carga se dispara unos días y luego vuelve a su nivel. La nube permite subir y bajar recursos con esos picos, en vez de pagar todo el año la capacidad del día más ocupado [3].
Veracidad es la exactitud de los datos [3]. Es el viejo principio de «basura entra, basura sale». Si el análisis busca causas, cada dato malo cuenta; si busca tendencias sobre volúmenes enormes, algunos errores sueltos se diluyen en el total [3].
Valor es la ganancia económica o social que una organización obtiene al analizar los datos [3]. El NIST reconoce que no hay una forma estándar de medirlo. Ni siquiera está resuelto cómo llevar el valor de los datos al balance de una empresa [3].
Cada V, con las listas de cinco y de siete que circulan, tendrá su desarrollo completo en una guía propia sobre las V del big data.
¿A partir de cuántos datos se habla de big data?
No hay una cifra oficial. El NIST advierte que es difícil fijar criterios universales, porque la decisión depende del rendimiento, el costo y el tiempo que exige cada aplicación [3]. Incluso señala que varios problemas típicos de big data aparecen con conjuntos de menos de un gigabyte [3]. Lo que sí existen son señales prácticas, como las de la tabla.
La política colombiana de datos lo dijo en 2018: «la generación exponencial de datos digitales significa que los datos considerados de gran volumen hace algunos años, hoy sean considerados “normales”» [6]. El umbral se mueve con la tecnología.
| V | Qué mide | Señal práctica de que cruzó el umbral | Dato de referencia |
|---|---|---|---|
| Volumen | El tamaño del conjunto | Los datos no caben en la memoria de un computador o la tarea tarda más de lo que la decisión puede esperar | Una hoja de Excel admite hasta 1.048.576 filas [7]; pandas, la librería de Python para tablas, trabaja en memoria [8]; HDFS reparte archivos en bloques de 128 MB [4] |
| Velocidad | El ritmo de llegada | Hay que responder antes de guardar el dato | Spark procesa flujos en microlotes (paquetes pequeños de datos) con latencias, o demoras de punta a punta, desde 100 milisegundos, y en modo continuo desde 1 milisegundo [9] |
| Variedad | Las fuentes y los tipos | Hay que cruzar textos, imágenes o registros que no comparten un modelo | Los datos no estructurados no tienen un modelo de datos predefinido [3] |
| Variabilidad | Los cambios de ritmo, formato o tamaño | Los picos obligan a rediseñar o a pagar capacidad ociosa | Escalar recursos hacia arriba y hacia abajo evita dimensionar para el pico [3] |
| Veracidad | La exactitud | El análisis busca causas, no solo tendencias | Con análisis causal, la calidad de cada dato importa [3] |
| Valor | La ganancia obtenida | Nadie sabe decir qué decisión cambió gracias a los datos | No existe un estándar para medirlo [3] |
Las señales de la tabla son órdenes de magnitud prácticos, no umbrales oficiales: el NIST no fija ninguno [3].
Un ejemplo colombiano muestra por qué la frontera es móvil. El Instituto Nacional de Salud (INS) publica en datos.gov.co, el portal de datos abiertos del Estado, la base de casos positivos de COVID-19, con 6.390.971 filas y 23 columnas [10]. Son más de seis veces el límite de filas de una hoja de Excel [7]. Para Excel, eso es demasiado.
Para big data, no. En una prueba propia, hecha el 11 de octubre de 2026, descargué el archivo completo: pesó 1,18 gigabytes.
Un portátil con 16 gigabytes de memoria lo recorrió fila por fila con Python entre 21 y 29 segundos, según la corrida, sin repartirlo entre máquinas. Superar a Excel no convierte unos datos en big data; necesitar un clúster, sí.
¿Por qué el costo de almacenar cambió la pregunta?
Porque guardar dejó de ser caro. En dólares constantes de 2020, el precio más bajo registrado para un terabyte en disco pasó de unos 581 millones en 1980 a unos 10,6 en 2023 [11]. Cuando conservar un dato cuesta casi nada, la pregunta de una organización deja de ser «¿qué vale la pena guardar?». Pasa a ser «¿qué vale la pena preguntarle a lo que ya guardé?».
| Año | Precio más bajo registrado de 1 terabyte en disco (dólares de 2020) |
|---|---|
| 1980 | 581.068.400 |
| 1990 | 6.473.703 |
| 2000 | 6.120 |
| 2003 (año del artículo de Google sobre su sistema de archivos) | 1.055 |
| 2010 | 53 |
| 2023 | 10,6 |
Fuente: Our World in Data, con datos de John C. McCallum y el índice de precios al consumidor de Estados Unidos [11]. Cada año muestra el precio más barato registrado hasta ese año, no el promedio del mercado [11].
Un economista mira primero el costo marginal: lo que cuesta producir una unidad más, aquí guardar un terabyte adicional. Mientras ese costo fue alto, cada organización tenía que decidir de antemano qué conservar.
Con el disco casi regalado, la cuenta se invierte. El NIST lo reconoce desde la ingeniería: los servidores baratos que sostienen un sistema de archivos distribuido pueden bajar de forma drástica el costo de almacenar a gran escala [3]. Aquí va mi interpretación de economista, que ya no es del NIST. Con el disco caro, lo sensato era resumir, tomar muestras y botar el resto. Con el disco barato, borrar exige que alguien decida qué sobra, y esa decisión cuesta más que el disco. Por eso se volvió racional guardarlo todo y preguntar después.
El costo no desapareció. Se mudó. Ya no está en el disco sino en la atención: en limpiar, documentar y decidir qué preguntar. Ahí reaparece la veracidad, que ningún disco barato resuelve.
Una advertencia de método: son precios de referencia de Estados Unidos, no lo que paga hoy una empresa en Colombia [11]. La tendencia es lo que importa aquí, no el valor exacto en pesos.
¿Para qué sirve el big data?
El big data sirve para responder preguntas que antes eran imposibles o demasiado caras. Permite detectar un fraude mientras ocurre, entrenar programas que reconocen imágenes o cruzar fuentes que nunca se habían juntado. Agrupo aquí en tres usos los ejemplos que el NIST da al describir las V del big data [3].
Decidir en el momento es el uso más antiguo. Las telecomunicaciones y las tarjetas de crédito procesan grandes volúmenes en intervalos cortos desde hace años, porque un fraude hay que frenarlo casi en tiempo real [3].
Aprender de más ejemplos es el uso que más ha crecido. El reconocimiento de objetos en imágenes mejoró de forma notable cuando se pudo pasar de analizar miles de imágenes a analizar millones [3]. Esa es la materia prima del machine learning, la rama de la inteligencia artificial que aprende a partir de ejemplos.
Cruzar fuentes distintas es el uso que más sorprende, porque responde preguntas que ninguna fuente sola podía responder [3]. Es la V de la variedad trabajando.
En el sector público, la política colombiana de 2018 trata los datos como un activo para generar valor social y económico [6]. Con un matiz que vale la pena retener: citando a la ONU y a la OCDE, advierte que las fuentes nuevas sirven para complementar las estadísticas oficiales, no para reemplazarlas [6].
Los casos reales por sector, cada uno con su fuente y también con sus fracasos, irán en la guía de ejemplos de big data.
Big data y análisis de datos: ¿en qué se diferencian?
El análisis de datos es el método para sacar conclusiones confiables de los datos. El big data es la condición de escala que obliga a cambiar las herramientas con que se aplica ese método. Se pueden analizar datos sin big data, con una hoja de cálculo. Y se puede tener big data sin analizarlo bien.
El método completo, de la pregunta a la conclusión, está en la guía de análisis de datos. Lo que cambia en ese método cuando los datos no caben en memoria será tema de la guía de big data analytics, en preparación.
La ciencia de datos es la disciplina más amplia, que aprende de los datos sean grandes o pequeños. Dónde se separa del big data se tratará en una comparación propia.
Con las bases de datos pasa algo parecido. Los sistemas de big data dieron impulso a bases que no usan tablas, como las de documentos, las de pares clave-valor o las de grafos [3]. Qué son y cuándo convienen se explica en la guía de bases de datos. Y el idioma de las tablas sigue vivo a esta escala: Spark trae Spark SQL para consultar datos estructurados con SQL (el lenguaje estándar para pedirle datos a una base) [12].
Las cuatro capas de una plataforma de big data
Una plataforma de big data se puede leer en cuatro capas: ingesta, almacenamiento, procesamiento y consumo. Es una simplificación del modelo de referencia del NIST, que describe el sistema con cinco roles principales [13]. Ese modelo reparte el trabajo de la aplicación en recolección, preparación, análisis, visualización y acceso [13]. Las cuatro capas responden, en orden, de dónde llegan los datos, dónde viven, quién los trabaja y quién los usa.
- Ingesta. Recibe los datos de quien los produce, sea un archivo, un sensor o una aplicación, y los retiene hasta que quedan guardados [13].
- Almacenamiento. Los guarda repartidos entre varias máquinas, como hace HDFS con sus bloques [4].
- Procesamiento. Prepara, transforma y analiza los datos en paralelo [13]. Ahí trabajan motores como Apache Spark, que se describe como un motor unificado de análisis de datos a gran escala [12].
- Consumo. Entrega los resultados a personas o a otros programas: un tablero, un reporte, un modelo que responde [13].
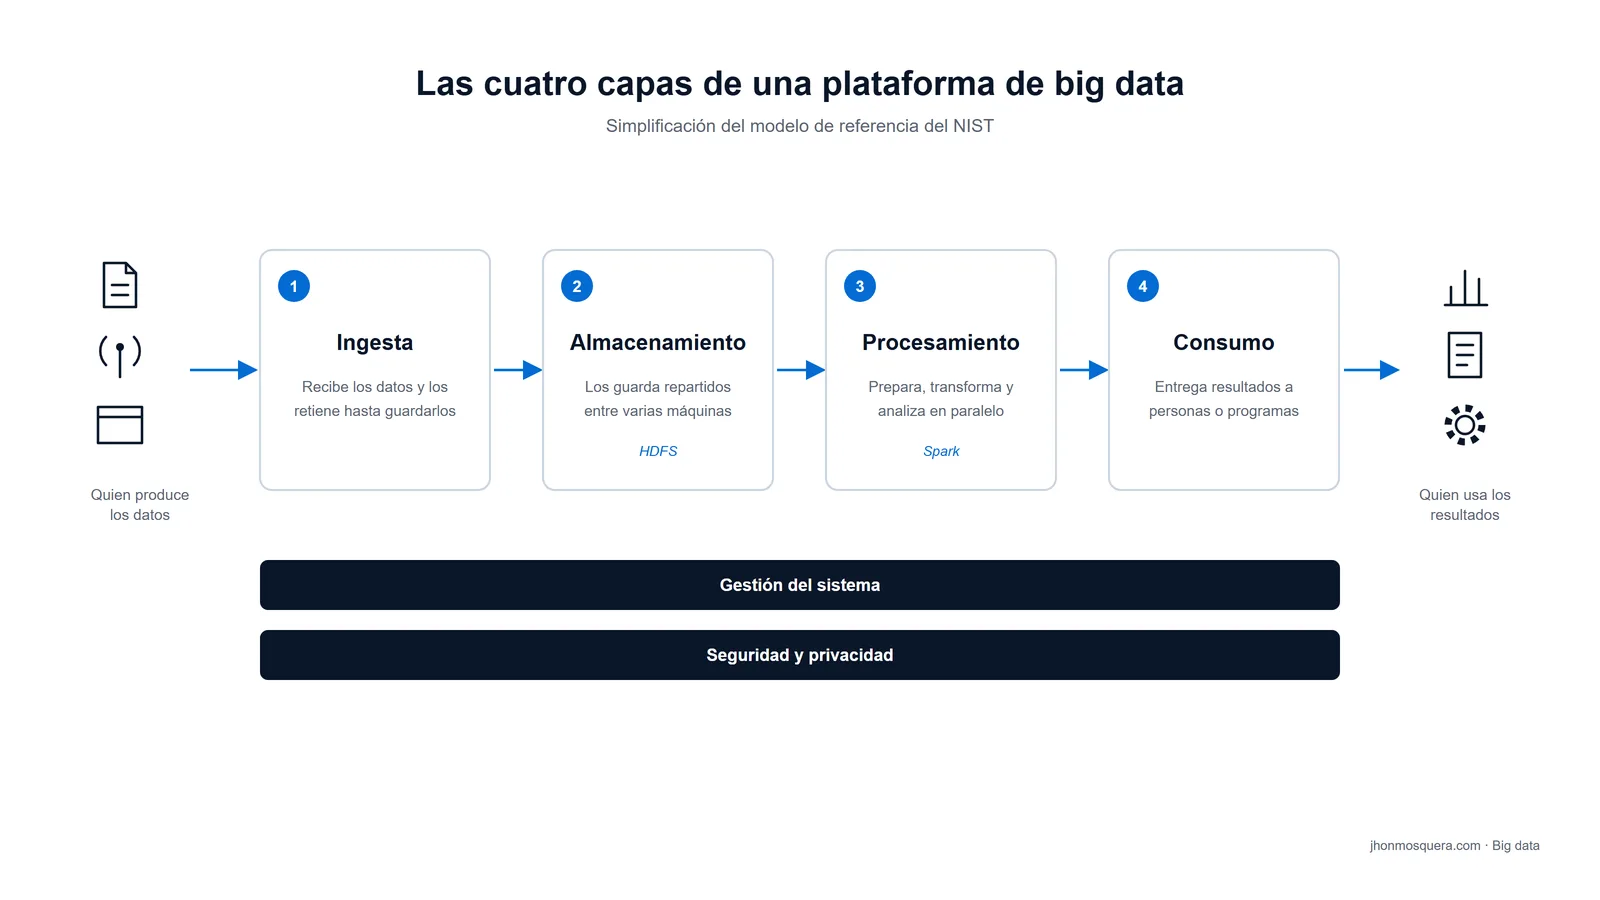
El NIST añade dos capas que atraviesan a todas las demás: la gestión del sistema y la seguridad y privacidad [13]. Cómo se combinan estas piezas, y las arquitecturas por lotes y en tiempo real, es tema de la guía de arquitectura big data, en preparación. La construcción concreta de flujos de datos, almacenes y servicios en la nube corresponde a la guía de ingeniería de datos, también en preparación.
Big data en Colombia: la política de 2018 y la puerta gratuita
Colombia tiene una política pública de big data desde el 17 de abril de 2018: la Política Nacional de Explotación de Datos [6]. Quedó aprobada como documento 3920 del CONPES (Consejo Nacional de Política Económica y Social, que aprueba las grandes políticas del Gobierno) [6]. La implementación la lideran el Departamento Nacional de Planeación (DNP) y el Ministerio de Tecnologías de la Información y las Comunicaciones (MinTIC) [6]. El plan fijó cinco años de ejecución y una inversión de 16.728 millones de pesos [6].
La política se propuso cuatro objetivos específicos [6]:
- Masificar la disponibilidad de datos digitales de las entidades públicas, accesibles, usables y de calidad.
- Dar seguridad jurídica a la explotación de datos.
- Formar el capital humano que genere valor con los datos.
- Crear una cultura de datos en el país.
Qué se cumplió de esa agenda, y cuánto usan las empresas colombianas estas tecnologías, quedará para la guía de big data en Colombia.
La puerta de entrada, en cambio, no cuesta. Apache Hadoop y Apache Spark son proyectos de código abierto de la Fundación Apache [14][12]. Spark corre en un solo computador con tener Java instalado, así que se puede aprender en un portátil antes de pagar un clúster [12]. Los datos tampoco cuestan: la base del INS del ejemplo anterior se descarga gratis, con una licencia abierta que permite reutilizarla si se cita la fuente y se publican las versiones modificadas con la misma licencia [10].
Big data: qué guía leer según lo que busca
Esta tabla ordena las guías de big data y las páginas vecinas por la pregunta que resuelven. Las que dicen «Próximamente» están en preparación.
| Si lo que busca es… | Guía | Estado |
|---|---|---|
| Cada V explicada a fondo, con sus variantes de cinco y siete | Las V del big data | Próximamente |
| Cómo se reparte el trabajo entre muchas máquinas | Procesamiento distribuido | Próximamente |
| Qué es Hadoop y si todavía sirve | Apache Hadoop | Próximamente |
| Qué es Spark, para qué sirve y cómo funciona | Apache Spark | Próximamente |
| Qué herramienta elegir para cada capa | Herramientas de big data | Próximamente |
| Cómo se diseña una plataforma por capas | Arquitectura big data | Próximamente |
| Cómo analizar cuando los datos no caben en memoria | Big data analytics | Próximamente |
| Ejemplos reales por sector | Ejemplos de big data | Próximamente |
| Qué separa al big data de la ciencia de datos | Big data vs ciencia de datos | Próximamente |
| Cuándo una base de datos tradicional deja de servir | Big data vs bases de datos | Próximamente |
| Política, adopción y casos en el país | Big data en Colombia | Próximamente |
| La disciplina completa, de la pregunta a la decisión | Ciencia de datos | Publicada |
| Dónde se guardan los datos y qué es una base NoSQL | Bases de datos | Publicada |
| Cómo pedirle datos a una base de datos | SQL | Publicada |
| Modelos que aprenden de los datos | Machine learning | Publicada |
| El método para sacar conclusiones de los datos | Análisis de datos | Publicada |
| Qué hace quien trabaja con big data y cómo se llega a serlo | Rutas y carreras en datos | Próximamente |
¿Qué no resuelve el big data?
Más datos no corrigen una mala pregunta. Tampoco corrigen datos malos: el NIST insiste en que la calidad de los datos sigue siendo de vital importancia en el análisis de big data [3]. Un clúster de mil máquinas procesa basura igual de rápido que procesa oro.
Hollerith y los ingenieros de Google resolvieron cuellos de botella distintos con la misma lógica: mirar dónde se atasca el trabajo y cambiar la forma de hacerlo. En 1880 el atasco era contar. En 2003 era guardar y procesar sin que una falla lo tumbara todo.
Opino que el atasco de 2026 ya no está en las máquinas. Para una alcaldía de Santander o una pyme de Bucaramanga, el disco es barato y Spark es gratis. Lo escaso es alguien que sepa qué preguntar y datos públicos ordenados para preguntarles. Esa es una buena noticia, porque el criterio se forma y no hay que importarlo.
La pregunta para usted, entonces, no es cuántos terabytes tiene. Es qué decisión cambiaría si pudiera mirar todos sus datos y no solo una muestra.
Preguntas frecuentes
¿Big data se refiere únicamente a grandes volúmenes de datos? No. El tamaño es solo una de las condiciones. Piense en el internet de las cosas: sensores y aparatos conectados que reportan sin parar. Un sistema que debe reaccionar a ellos en tiempo real puede necesitar varias máquinas aunque cada lectura pese muy poco [3]. Y mezclar muchos tipos de datos complica el trabajo aunque el total sea modesto [3].
¿Cómo se dice big data en español? Una traducción frecuente es datos masivos. Es la que usa el DANE (Departamento Administrativo Nacional de Estadística, la entidad de las cifras oficiales) en su encuesta de tecnología en empresas [15]. El Gobierno colombiano prefirió otra fórmula en su política de 2018, que tituló Política Nacional de Explotación de Datos y puso el término en inglés entre paréntesis [6]. En el habla técnica se mantiene el anglicismo.
¿Qué tipos de datos maneja el big data? Tres grandes tipos. Los estructurados tienen cada registro con la misma forma, como las filas de una tabla [3]. Los semiestructurados tienen un orden general pero elementos internos libres [3]. Es el caso de JSON (un formato de texto con etiquetas para intercambiar datos entre aplicaciones) y de XML, que cumple la misma función [3]. Los no estructurados, como el texto, la imagen o el video, no siguen un modelo definido de antemano [3].
¿Hadoop y Spark son lo mismo? No. Hadoop es una biblioteca de software para procesar grandes conjuntos de datos repartidos en clústeres, con su propio sistema de archivos, HDFS [14][4]. Spark es un motor de análisis que se programa en Java, Scala o Python; el soporte para R sigue, pero figura como obsoleto en la versión 4.2.0 [12]. Usa bibliotecas de Hadoop para leer HDFS [12]. Puede correr sobre YARN, el gestor de recursos de Hadoop, pero también sobre Kubernetes (un sistema que reparte programas entre servidores) o en su propio modo autónomo [12].
¿Big data e inteligencia artificial son lo mismo? No, pero se alimentan mutuamente. El NIST explica que el aprendizaje automático resurgió gracias al procesamiento distribuido de datos y a la capacidad de cálculo en paralelo de los procesadores gráficos [3]. El big data aporta la escala; la inteligencia artificial, los modelos que aprenden de ella.
Referencias
Las citas en otro idioma son traducción propia.
- U.S. Census Bureau. Tabulation and Processing, historia de la Oficina del Censo — el censo de 1880 se tabuló con el aparato de Seaton, que no alcanzó para el volumen de datos, y sus tabulaciones finales terminaron en 1887; Herman Hollerith, antiguo empleado de la Oficina del Censo, inventó una máquina de tarjetas perforadas, una por persona, que al cerrar un circuito eléctrico hacía avanzar el dial del rasgo correspondiente; la Oficina alquiló una flota de esas máquinas para el censo de 1890, que terminó meses antes de lo previsto y muy por debajo del presupuesto. U.S. Census Bureau: Tabulation and Processing — Consultada: 2026-10-11.
- Ghemawat, Sanjay; Gobioff, Howard; Leung, Shun-Tak (Google). The Google File System, SOSP 2003 — «component failures are the norm rather than the exception»; sistema construido con cientos o miles de máquinas de componentes baratos; conjuntos de datos de muchos TB con miles de millones de objetos, como documentos web; los clústeres más grandes con más de 1.000 nodos de almacenamiento y más de 300 TB de disco; monitoreo constante, detección de errores, tolerancia a fallas y recuperación automática integrados al sistema. Google Research: The Google File System — Consultada: 2026-10-11.
- NIST Big Data Public Working Group. NIST Big Data Interoperability Framework: Volume 1, Definitions (Special Publication 1500-1r2, versión 3, octubre de 2019) — definición de big data por volumen, velocidad, variedad y variabilidad que exigen una arquitectura escalable; escalabilidad, escalado vertical y horizontal; paso al paradigma cuando hace falta paralelizar en un clúster para un manejo de datos costo-eficiente; dificultad de fijar criterios universales; problemas de big data demostrables con conjuntos de menos de 1 GB; definiciones de cada V, de veracidad (5.4.1) y de valor (5.4.5); datos estructurados, semiestructurados (JSON, XML) y no estructurados; velocidad en telecomunicaciones y tarjetas de crédito; reconocimiento de objetos al pasar de miles a millones de imágenes; variedad y beneficios de negocio; escalado dinámico en la nube; servidores de bajo costo que bajan el costo de almacenamiento; bases clave-valor, de documentos y de grafos; calidad de datos; aprendizaje automático, procesamiento distribuido y GPU; internet de las cosas. NIST: SP 1500-1r2, Volume 1 Definitions — Consultada: 2026-10-11.
- The Apache Software Foundation. HDFS Architecture, documentación de Apache Hadoop 3.5.0 — HDFS es un sistema de archivos distribuido diseñado para hardware común y de bajo costo; «Hardware failure is the norm rather than the exception»; «Moving Computation is Cheaper than Moving Data»; un tamaño de bloque típico es 128 MB; caso común con factor de replicación tres. Apache Hadoop: HDFS Architecture 3.5.0 — Consultada: 2026-10-11.
- Dean, Jeffrey; Ghemawat, Sanjay (Google). MapReduce: Simplified Data Processing on Large Clusters, OSDI 2004 — modelo de programación con una función map que produce pares clave-valor intermedios y una función reduce que combina los valores de una misma clave; ejecución automática en paralelo sobre un clúster grande de máquinas comunes; ejemplo de conteo de palabras; un cálculo típico procesa muchos terabytes en miles de máquinas. Google Research: MapReduce, Simplified Data Processing on Large Clusters — Consultada: 2026-10-11.
- Consejo Nacional de Política Económica y Social (CONPES), Departamento Nacional de Planeación, Ministerio de Tecnologías de la Información y las Comunicaciones y Superintendencia de Industria y Comercio. Documento CONPES 3920: Política Nacional de Explotación de Datos (Big Data) (versión aprobada, Bogotá, 17 de abril de 2018) — la primera referencia al término identificó el reto de volumen, velocidad y variedad (Laney, 2001); cita textual de la sección 3.2 sobre los datos de gran volumen que hoy son «normales»; DNP y MinTIC liderarán la implementación durante cinco años con inversiones por 16.728 millones de pesos; objetivo general y cuatro objetivos específicos (sección 5.2); las nuevas fuentes complementan y no reemplazan la producción de estadísticas oficiales (ONU 2017, OCDE 2017). DNP: documento CONPES 3920 de 2018 — Consultada: 2026-10-11.
- Microsoft. Especificaciones y límites de Excel — número total de filas y columnas en una hoja de cálculo: 1.048.576 filas por 16.384 columnas. Microsoft: especificaciones y límites de Excel — Consultada: 2026-10-11.
- pandas development team. Scaling to large datasets, documentación de pandas 3.0.6 — pandas ofrece estructuras de datos para análisis en memoria, lo que vuelve difícil analizar conjuntos más grandes que la memoria; incluso conjuntos que ocupan una fracción considerable de la memoria se vuelven difíciles de manejar. pandas: Scaling to large datasets — Consultada: 2026-10-11.
- The Apache Software Foundation. Structured Streaming Programming Guide, documentación de Apache Spark 4.2.0 — motor de procesamiento de flujos escalable y tolerante a fallas; por defecto procesa en microlotes con latencias de extremo a extremo desde 100 milisegundos; el modo de procesamiento continuo alcanza latencias desde 1 milisegundo. Apache Spark: Structured Streaming Programming Guide — Consultada: 2026-10-11.
- Instituto Nacional de Salud (INS), publicado en el Portal de Datos Abiertos de Colombia. Casos positivos de COVID-19 en Colombia (identificador gt2j-8ykr; licencia Creative Commons Atribución-CompartirIgual 4.0; 23 columnas) — 6.390.971 filas según el conteo de la interfaz de consulta del portal el día de la consulta. datos.gov.co: Casos positivos de COVID-19 en Colombia — Consultada: 2026-10-11.
- Our World in Data. Historical price of computer memory and storage, con datos de John C. McCallum (2023) y la Oficina de Estadísticas Laborales de Estados Unidos (2026) — precio del almacenamiento en disco en dólares constantes de 2020 por terabyte; cada año muestra el precio más barato registrado hasta ese año; disco: 581.068.400 (1980), 6.473.702,5 (1990), 6.119,57 (2000), 1.054,82 (2003), 53,41 (2010) y 10,62 (2023). Our World in Data: Historical price of computer memory and storage — Consultada: 2026-10-11.
- The Apache Software Foundation. Spark Overview, documentación de Apache Spark 4.2.0, y portada del proyecto — «Apache Spark is a unified analytics engine for large-scale data processing»; interfaces en Java, Scala, Python y R; Spark SQL para datos estructurados; usa las bibliotecas cliente de Hadoop para HDFS y YARN; despliegue autónomo, sobre YARN o sobre Kubernetes; se ejecuta localmente en una sola máquina con Java instalado; proyecto de código abierto con más de 2.000 contribuyentes. Apache Spark: documentación 4.2.0 · Apache Spark: portada del proyecto — Consultada: 2026-10-11.
- NIST Big Data Public Working Group. NIST Big Data Interoperability Framework: Volume 6, Reference Architecture (Special Publication 1500-6r2, versión 3, octubre de 2019) — cinco roles principales (orquestador del sistema, proveedor de datos, proveedor de la aplicación de big data, proveedor del marco de big data y consumidor de datos) y dos transversales (gestión, y seguridad y privacidad); actividades de la aplicación: recolección, preparación, análisis, visualización y acceso; la recolección recibe y retiene los datos hasta que se persisten. NIST: SP 1500-6r2, Volume 6 Reference Architecture — Consultada: 2026-10-11.
- The Apache Software Foundation. Apache Hadoop, portada del proyecto — el proyecto desarrolla software de código abierto para computación distribuida confiable y escalable; la biblioteca permite el procesamiento distribuido de grandes conjuntos de datos en clústeres de computadores; versión 3.5.0 publicada el 2 de abril de 2026. Apache Hadoop: portada del proyecto — Consultada: 2026-10-11.
- DANE y MinTIC. Boletín técnico Encuesta de Tecnologías de la Información y las Comunicaciones en Empresas (ENTIC Empresas) 2020 — la tabla 12 y el glosario usan la expresión «proceso de analítica de datos basado en datos masivos (BIG DATA)». DANE: boletín técnico ENTIC Empresas 2020 — Consultada: 2026-10-11.
Cómo investigamos esta página
- Pregunta que responde: Qué es big data, qué lo distingue de tener muchos datos, cómo funciona y por qué el abaratamiento del almacenamiento cambió la pregunta.
- Fuentes: identificadas 22 → incluidas 15 (el NIST, los artículos originales de Google, documentación oficial de Hadoop, Spark, pandas y Excel, el CONPES 3920, el DANE, el INS y una serie de precios).
- Criterios de inclusión: solo organismos de estándares, gobiernos, artículos originales y documentación oficial leídos hoy; ninguna enciclopedia, blog ni curso.
- Fecha de corte de los datos: 2026-10-11