
Machine learning: qué es, cómo funciona y para qué sirve
El machine learning, o aprendizaje automático, es la rama de la inteligencia artificial en la que un programa aprende una tarea a partir de ejemplos en vez de seguir reglas escritas a mano. Aquí verá cómo aprende un modelo, sus tres paradigmas, el ciclo de un proyecto y dos usos reales en Colombia.
Última actualización: 2026-10-09
Contenido de esta página
- ¿Qué es el machine learning?
- ¿Qué significa machine learning en español?
- ¿Cómo aprende un modelo de machine learning?
- Los tres paradigmas del machine learning, en una tabla
- ¿Para qué sirve el machine learning?
- ¿Cuál es el ciclo de vida de un proyecto de machine learning?
- Qué guía de machine learning leer según lo que busca
- ¿Qué no puede hacer el machine learning?
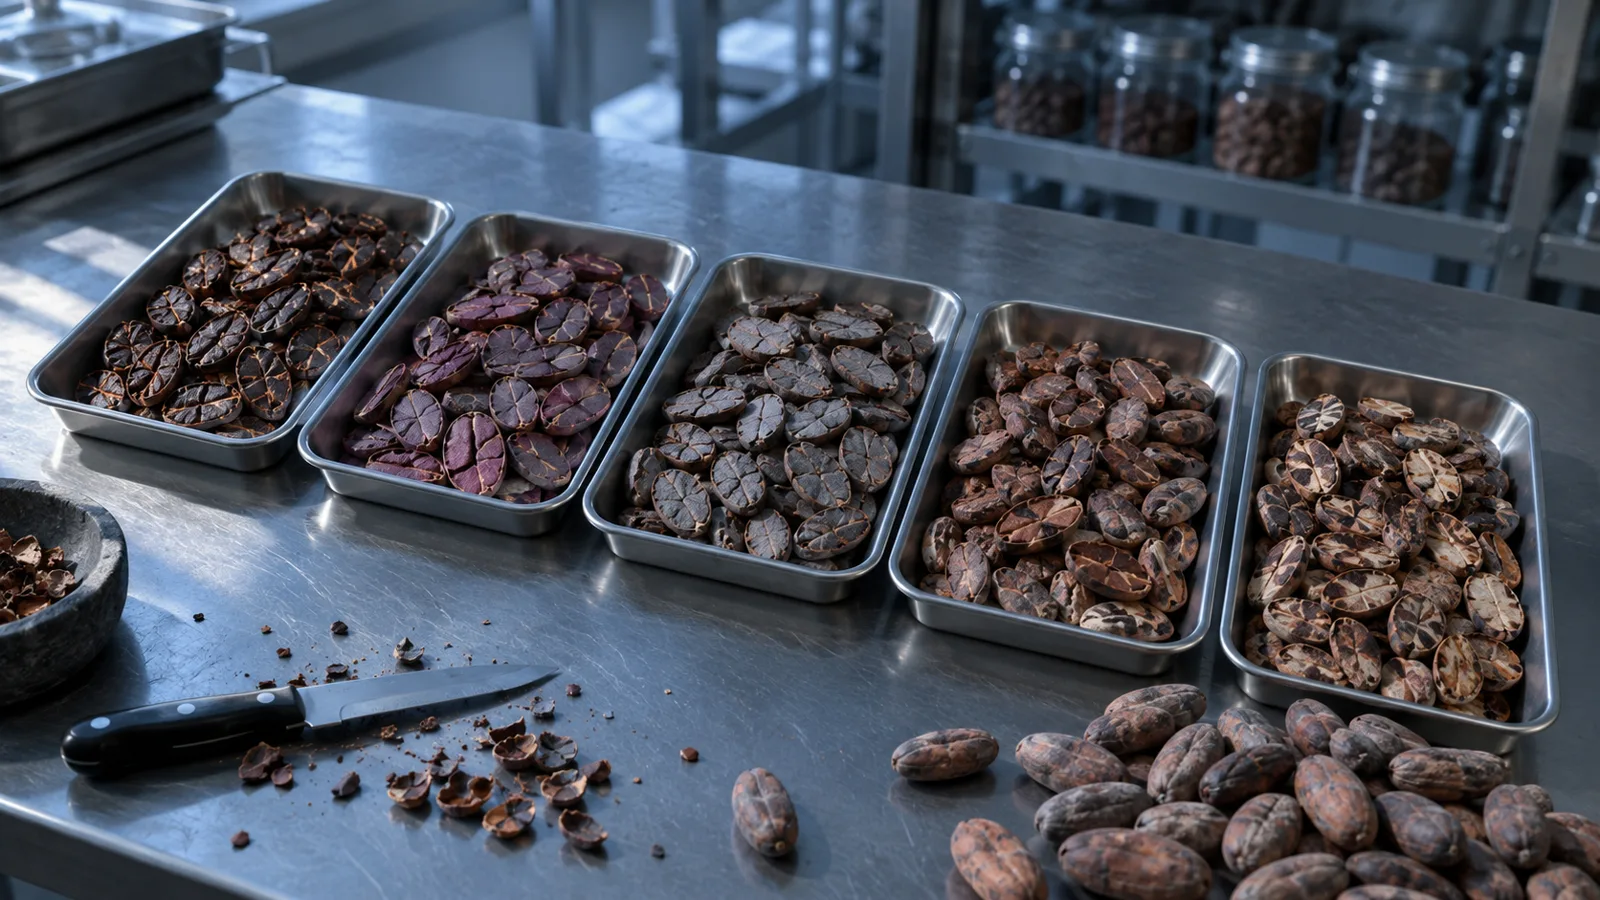
Escena compuesta, con nombre ficticio: Yolanda es la encargada de calidad de una asociación de cacaoteros del Magdalena Medio santandereano. Cada lote que llega a la bodega pasa por sus manos. Toma un puñado de granos secos, los parte por la mitad con una cuchilla y mira el corte. Esa revisión se llama prueba de corte y sirve para juzgar qué tan bien fermentó el cacao [1]. Importa porque una buena fermentación mejora la calidad final del grano y su valor comercial [1].
Yolanda casi nunca se equivoca. Lo que no logra es explicar su regla completa. Hay granos dudosos que decide «por la pinta», con el ojo que le dejaron quince años de cortes. Cuando ella sale a vacaciones, la cosecha no espera.
A la asociación no le falta conocimiento. Le falta una manera de sacarlo de los ojos de una persona cuando nadie sabe escribirlo como instrucciones.
Esa manera existe y se llama machine learning, o aprendizaje automático. En vez de escribirle al computador la regla, se le muestran miles de granos que Yolanda ya calificó. El programa encuentra por su cuenta lo que separa un buen corte de uno malo. En Santander ya se dio un primer paso. En 2021, un equipo de la Universidad Industrial de Santander clasificó 90 granos por su nivel de fermentación a partir de imágenes hiperespectrales, que registran también la luz que el ojo no ve. Luego comparó su resultado con la calificación de expertos de la Federación Nacional de Cacaoteros [2].
¿Qué es el machine learning?
El machine learning es el método con el que un computador saca una regla de los datos. Recibe muchos ejemplos de un problema ya resuelto, ajusta una fórmula hasta reproducir esas respuestas y después la aplica a casos que nunca vio. Formalmente, es una rama de la inteligencia artificial, el campo que construye programas capaces de resolver tareas complejas [3].
A esa fórmula ajustada se le llama modelo: una versión simplificada de la realidad, hecha de números, que convierte datos de entrada en una respuesta. Google, en su curso para desarrolladores, lo define como «el proceso de entrenar una pieza de software, llamada modelo, para que haga predicciones útiles o genere contenido (…) a partir de datos» [4]. Entrenar, en este oficio, quiere decir eso: ajustar el modelo con ejemplos.
El mismo curso trae un ejemplo que muestra la diferencia con la programación de siempre [4]. Para pronosticar la lluvia por el camino tradicional, habría que representar la física de la atmósfera y resolver ecuaciones de dinámica de fluidos. Por el camino del machine learning, se le entregan al modelo enormes cantidades de datos del clima. El modelo termina aprendiendo la relación matemática entre los patrones del tiempo y la cantidad de lluvia [4].
Es la diferencia que hay entre darle a alguien una receta escrita y enseñarle a cocinar probando. Yolanda aprendió de la segunda forma. Por eso no puede dictar la receta.
Dentro de la ciencia de datos, la disciplina que convierte datos en decisiones, el machine learning es la herramienta que se usa cuando hay que predecir o clasificar.
Definición de machine learning: tres maneras de decirlo
Una definición de machine learning que resista la revisión de un especialista reúne tres ingredientes: un sistema que mejora en una tarea, unos datos de los que aprende y ningún cambio manual en sus instrucciones. Así la recoge la Oficina Quebequense de la Lengua Francesa, el organismo público de Quebec que recomienda los términos técnicos en francés, en su diccionario terminológico [5].
Su definición dice que es un modo de aprendizaje en el que un sistema de inteligencia artificial se optimiza sin que se modifique su programa [5]. Así adquiere conocimientos y habilidades nuevas a partir de datos, o reorganiza los que ya tenía [5]. Lo decisivo está en la primera parte. Nadie reescribe el código; lo que cambia es el modelo.
La idea tiene más de seis décadas. En 1959, Arthur Samuel publicó en la revista de investigación de IBM, la empresa estadounidense de computadores, un estudio cuyo título ya hablaba de machine learning [6]. Usó el juego de damas como laboratorio. Mostró que un computador podía programarse para aprender a jugar mejor que la persona que había escrito el programa [6].
Ahí está la versión más corta de la definición: un programa que, con práctica, termina haciendo una tarea mejor que quien lo escribió.
¿Qué significa machine learning en español?
Machine learning significa en español aprendizaje automático, es decir, el aprendizaje que hace una máquina a partir de datos sin que una persona le dicte cada paso. Es el equivalente que el diccionario terminológico de Quebec registra para el español de España. Para México anota otras dos formas: «aprendizaje de máquina» y «aprendizaje de la computadora» [5].
Las tres formas nombran lo mismo. «Learning» es aprendizaje y «machine» es máquina, así que «aprendizaje de máquina» es la traducción literal. «Automático» tiene una ventaja: subraya que la regla no la escribe una persona.
Esta guía usa machine learning y aprendizaje automático como sinónimos.
¿Cómo aprende un modelo de machine learning?
Un modelo de machine learning aprende en un ciclo de cuatro pasos: recibe datos con la respuesta correcta, propone una función, mide cuánto se equivoca y se ajusta para equivocarse menos. La función es una regla matemática que convierte cada dato en una respuesta. El ciclo se repite muchas veces, hasta que el error deja de bajar, y se llama entrenamiento [7] [9].
Antes de los pasos, dos palabras del oficio. Las características son los valores que el modelo usa para predecir; en el cacao serían, por ejemplo, el color y la textura del corte [7]. La etiqueta es la respuesta que se quiere predecir, como «bien fermentado» o «mal fermentado» [7]. Google lo resume en una idea corta: los datos son la fuerza que mueve el aprendizaje automático [7].
Con ese vocabulario, el ciclo se ve así:
- Datos. El modelo recibe ejemplos que ya traen su etiqueta: miles de fotos de granos cortados, cada una con la calificación de Yolanda.
- Función. Arranca con una primera versión de la fórmula, todavía mala. Sus parámetros, los números internos que el entrenamiento irá moviendo, todavía dan malas respuestas.
- Error. Compara lo que predijo con la etiqueta real y lo resume en un número, la pérdida, que mide qué tan equivocadas están sus predicciones [8].
- Ajuste. Mueve los parámetros un poco en la dirección que reduce la pérdida y vuelve al paso 3 [9]. Google enseña este paso con el descenso del gradiente, una técnica matemática que repite el ajuste hasta encontrar los parámetros con la menor pérdida [9].
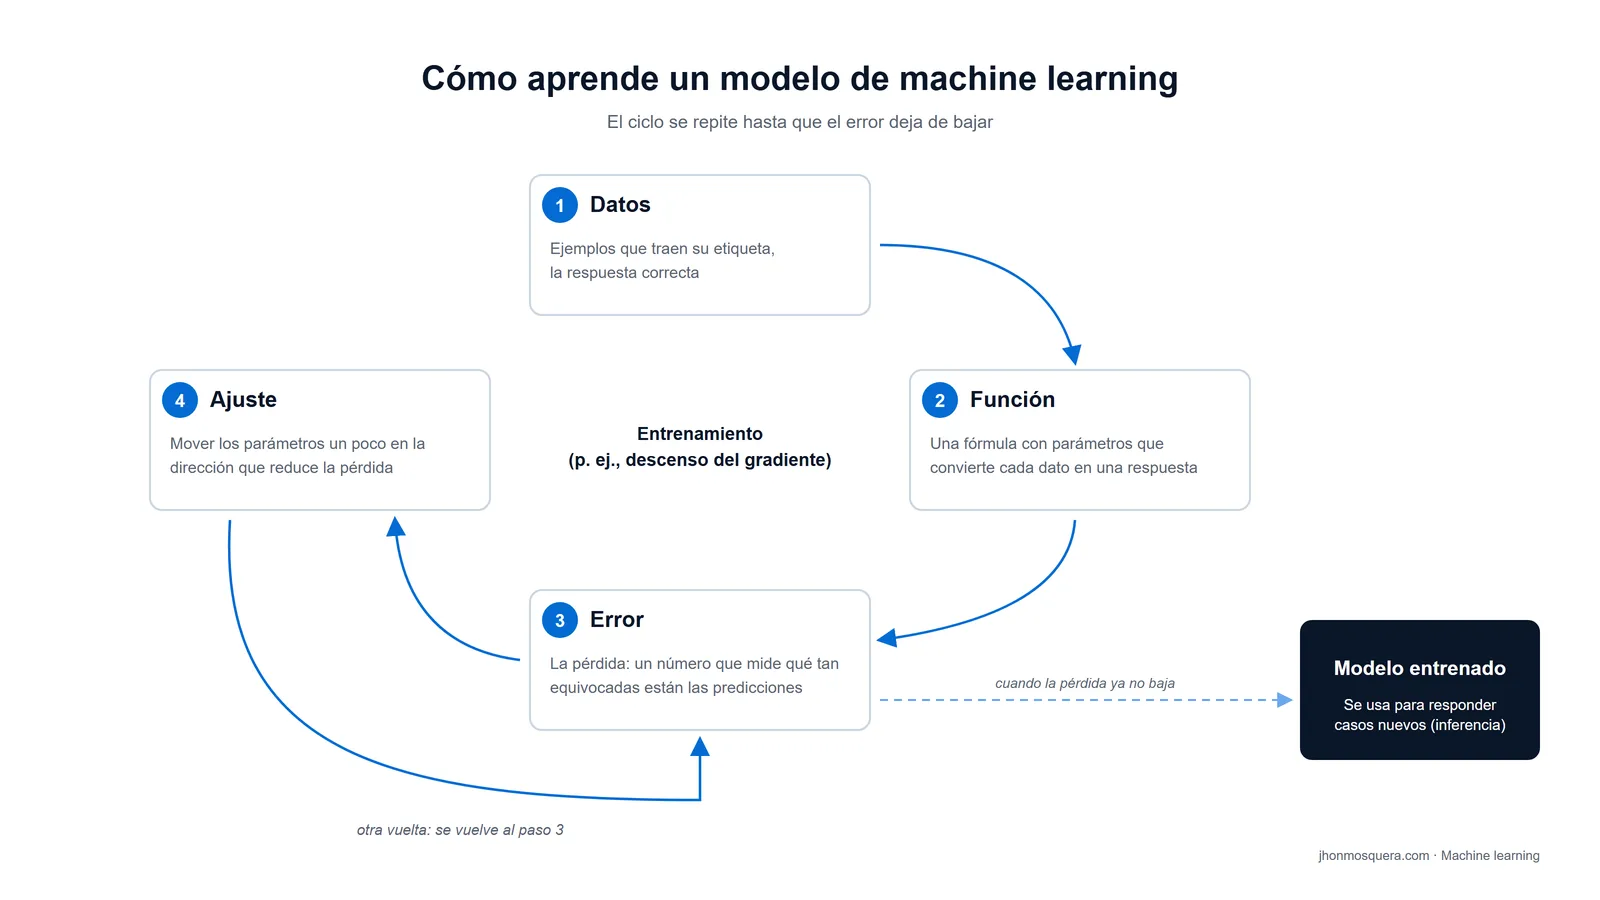
El objetivo de todo el entrenamiento es llevar la pérdida a su valor más bajo posible [8]. Afinar una guitarra de oído funciona igual. Se toca la cuerda, se compara con la nota que debería sonar, se gira la clavija un poquito y se vuelve a tocar. Cuando el modelo ya no logra bajar más la pérdida, Google dice que convergió: más vueltas no lo mejoran [9].
Lo que sale de ese proceso es el modelo entrenado. Según el mismo curso, en el aprendizaje supervisado un modelo es una colección compleja de números que define la relación matemática entre las características y la etiqueta [7]. Con esos números ya fijos, el modelo puede calificar granos que nadie ha calificado. A ese uso se le llama inferencia [7].
Sobreajuste: cuando el modelo memoriza en vez de aprender
El sobreajuste es el defecto de un modelo que se aprende de memoria los ejemplos de entrenamiento y falla con casos nuevos. Para detectarlo se guarda una parte de los datos, llamada conjunto de prueba, que el modelo no ve mientras aprende. Luego se mide allí cuánto acierta [10]. Esa medición es la que dice si de verdad aprendió.
La documentación de scikit-learn, una librería libre de Python para machine learning (un paquete de código que cualquiera puede descargar y usar), lo dice sin rodeos. En su versión 1.9.1 advierte: «Aprender los parámetros de una función de predicción y probarla con los mismos datos es un error metodológico» [10]. Un modelo que solo repitiera las etiquetas que acaba de ver sacaría una puntuación perfecta, explica, pero no serviría para predecir nada útil con datos nuevos [10].
Es el estudiante que se aprende de memoria las respuestas del simulacro del Icfes y se bloquea cuando el examen real cambia las preguntas. Si el modelo de Yolanda solo viera granos de dos fincas, podría aprender detalles de esas fincas en lugar de aprender a reconocer la fermentación.
Cómo medir el acierto con más rigor será tema de la guía de evaluación de modelos, que está en preparación.
Los tres paradigmas del machine learning, en una tabla
El machine learning se suele dividir en tres paradigmas clásicos según la señal de la que aprende el modelo. El aprendizaje supervisado aprende de ejemplos que traen la respuesta correcta. El no supervisado busca patrones en datos que no traen respuesta. El aprendizaje por refuerzo aprende de los premios y castigos que recibe por sus acciones [4].
| Paradigma | De qué aprende | Qué entrega | Ejemplo |
|---|---|---|---|
| Supervisado | Ejemplos con su etiqueta, la respuesta correcta | Una predicción de la etiqueta para casos nuevos | Decir si un correo es basura o pronosticar cuánto lloverá [4] |
| No supervisado | Datos sin etiqueta | Grupos o patrones que nadie había marcado | Agrupar registros del clima por temperatura y ver aparecer las estaciones [4] |
| Por refuerzo | Premios o castigos después de cada acción en un entorno | Una forma de actuar que acumula más premios | Robots que aprenden a moverse por una habitación; programas que juegan go, un juego de mesa [4] |
El caso de Yolanda es supervisado: cada grano llega con su calificación. Google añade una cuarta familia, la inteligencia artificial generativa, que crea contenido nuevo como textos, imágenes o música [4].
Cuándo conviene cada paradigma, con sus variantes y ejemplos, será tema de la guía de tipos de machine learning. Los algoritmos, que son las recetas de cálculo con las que se entrena un modelo, tendrán su propia guía. Las dos están en preparación.
¿Para qué sirve el machine learning?
El machine learning sirve para tres clases de trabajo con datos: clasificar, es decir, decidir a qué categoría pertenece algo; predecir un número, como un precio o un tiempo; y agrupar casos parecidos que nadie ha etiquetado. Tiene sentido cuando hay muchos ejemplos y la regla es difícil de escribir a mano, como la de Yolanda.
| Tarea | Pregunta que responde | Ejemplos que da la documentación de scikit-learn |
|---|---|---|
| Clasificación | ¿A qué categoría pertenece este caso? | Detectar correo basura, reconocer imágenes |
| Regresión | ¿Qué valor numérico tendrá? | Respuesta de un paciente a un medicamento, precios de acciones |
| Agrupamiento | ¿Qué casos se parecen entre sí? | Segmentar clientes, agrupar resultados de experimentos |
Fuente: scikit-learn, versión 1.9.1 [11].
Un caso colombiano: el Banco de la República y la inflación
En Colombia hay un uso documentado y de interés público. Investigadores del Banco de la República, el banco central de Colombia, han probado el aprendizaje automático para pronosticar la inflación, es decir, la subida general de los precios.
En 2025, Felipe Roldán-Ferrín y Julián Parra-Polanía publicaron un documento de trabajo del banco con un modelo de bosques aleatorios (random forests, en inglés: muchos árboles de decisión que combinan sus respuestas) [12]. Lo entrenaron con la historia de la inflación, indicadores de la economía y la actividad de búsqueda en Google [12]. Luego lo pusieron a prueba con los meses de 2023 y 2024, que no había usado para aprender [12].
El modelo superó de forma consistente a los modelos estadísticos con los que lo compararon [12]. También quedó a la par de la mediana, el valor del medio, de los pronósticos de los analistas financieros que el banco encuesta cada mes [12]. Su ventaja fue el tiempo: entregaba su pronóstico cerca de una semana y media antes que esa encuesta [12].
Dos años antes, otro equipo había probado, en un documento del mismo banco, redes neuronales LSTM, un tipo de modelo de aprendizaje profundo, para pronosticar la inflación con meses de anticipación [13]. Encontró que superaban a los modelos estadísticos clásicos de series de tiempo (datos ordenados en el tiempo), conocidos como ARIMA, sobre todo al pronosticar de siete a doce meses hacia adelante [13]. Sus autores, Julián Cárdenas-Cárdenas, Deicy Cristiano-Botia y Nicolás Martínez-Cortés, presentaron el trabajo como «una herramienta adicional en la batería de modelos utilizados por el Banco de la República para el pronóstico de la inflación en Colombia» [13].
Fíjese en lo que no pasó. El modelo de 2025 no reemplazó a los analistas: llegó a un acierto parecido, más temprano. Esa es la promesa realista del machine learning en una institución, y me parece más valiosa que la versión de película.
¿Y si su pregunta es de negocio, por ejemplo si un proyecto de inteligencia artificial paga lo que cuesta en una empresa? En este sitio hay un caso que recorre ese camino: IA generativa rentable: del piloto al ROI real (el ROI es el retorno de la inversión).
¿Cuál es el ciclo de vida de un proyecto de machine learning?
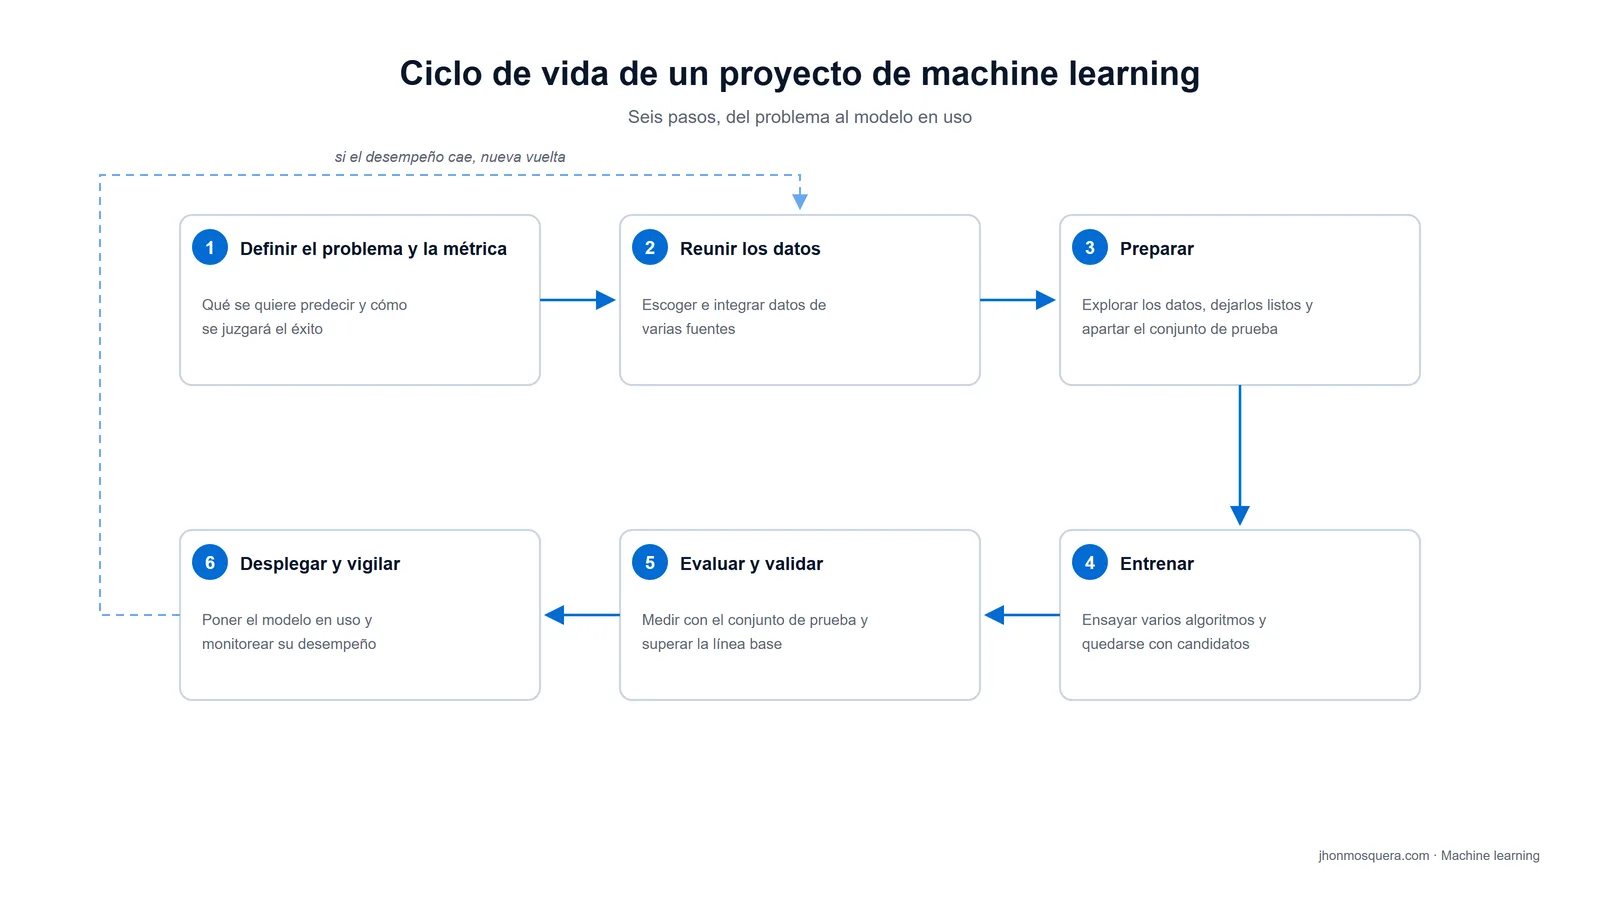
Un proyecto de machine learning recorre seis pasos: definir el problema y la medida de éxito, reunir los datos, prepararlos, entrenar el modelo, evaluarlo con datos que no vio y ponerlo a funcionar mientras se vigila su desempeño. La documentación de arquitectura de Google Cloud describe una secuencia parecida para llevar un modelo a producción, es decir, a uso real [14].
Para Google Cloud, esa secuencia empieza después de definir el caso de uso del negocio y los criterios de éxito [14]. Esta guía convierte esa condición en el primer paso, porque un modelo sin una pregunta clara no tiene contra qué medirse.
- Definir el problema y la métrica. Se decide qué se quiere predecir y con qué número se juzgará el éxito, la métrica. Para la asociación, la meta podría ser clasificar cada grano y acertar al menos tanto como una catadora entrenada.
- Reunir los datos. Se escogen e integran los datos útiles de varias fuentes [14]. En una organización suelen vivir en una base de datos y se extraen con SQL, el lenguaje para hacerle preguntas. En el cacao, además, hay que fotografiar miles de granos y etiquetarlos uno por uno.
- Preparar. Se exploran los datos para entenderlos y se dejan listos para el modelo [14]. En este paso también se aparta el conjunto de prueba.
- Entrenar. Se entrena el modelo con los datos preparados. Lo normal es ensayar varios algoritmos y quedarse con varios candidatos [14].
- Evaluar y validar. Cada candidato se mide con el conjunto de prueba. Solo pasa si supera una línea base, es decir, un desempeño mínimo de referencia [14].
- Desplegar y vigilar. El modelo aprobado se instala donde tiene que dar predicciones y su desempeño se monitorea. Si cae, se abre una nueva vuelta del ciclo [14].
La misma documentación hace dos observaciones que cambian la idea que suele tenerse de estos proyectos. En un sistema real de machine learning, el código del modelo es solo una pequeña parte del total [14]. Y un modelo puede rendir menos sin ningún error de programación, solo porque los datos cambian con el tiempo [14]. Si la asociación empieza a comprar cacao de otra región, los granos que aprendió a calificar ya no son los mismos.
A mi juicio, el paso más caro en un caso como el de Yolanda es el segundo: etiquetar miles de granos con criterio. Mantener modelos en producción, por su parte, es un oficio con nombre propio, el MLOps (las prácticas para desplegar, vigilar y actualizar modelos), y tendrá su guía.
Qué guía de machine learning leer según lo que busca
Esta guía da la vista de conjunto. Cada pieza del tema tendrá su guía propia, y la tabla las ordena según la pregunta que usted traiga. Las que ya están publicadas llevan enlace; las demás aparecen como próximas.
| Si lo que busca es… | Guía | Estado |
|---|---|---|
| Qué es la inteligencia artificial y qué abarca | Inteligencia artificial | Próximamente |
| En qué se diferencian la IA, el machine learning y el deep learning | IA vs. machine learning vs. deep learning | Próximamente |
| Los paradigmas de aprendizaje, uno por uno | Tipos de machine learning | Próximamente |
| Qué algoritmo elegir para un problema | Algoritmos de machine learning | Próximamente |
| Cómo saber si un modelo funciona | Evaluación de modelos | Próximamente |
| Cómo transformar los datos para que el modelo aprenda mejor | Ingeniería de características | Próximamente |
| Redes neuronales de muchas capas | Deep learning | Próximamente |
| Modelos que trabajan con texto | Procesamiento de lenguaje natural | Próximamente |
| Modelos que trabajan con imágenes | Visión por computador | Próximamente |
| Cómo poner un modelo en uso y vigilarlo | MLOps | Próximamente |
| Modelos que crean textos o imágenes | IA generativa | Próximamente |
| Una librería libre para empezar a entrenar modelos | Scikit-learn | Próximamente |
| Ejemplos de uso por sector | Casos de uso de machine learning | Próximamente |
| Regresión lineal, inferencia estadística y probabilidad | Estadística para ciencia de datos | Próximamente |
| Cómo programar modelos paso a paso | Python para análisis de datos | Próximamente |
| Qué hace un ingeniero de machine learning y cuánto gana | Rutas y carreras en datos | Próximamente |
| Ética, sesgo y regulación de la inteligencia artificial | Gobierno de datos | Próximamente |
| Datos que no caben en un solo computador | Big data | Próximamente |
| Dónde se guardan los datos que entrenan un modelo | Bases de datos | Publicada |
| Cómo sacar esos datos con consultas | SQL | Publicada |
| Dónde encaja el machine learning en el trabajo con datos | Ciencia de datos | Publicada |
Si empieza de cero, le sugiero este orden: la diferencia entre IA, machine learning y deep learning, luego los tipos de aprendizaje y después la evaluación de modelos. Antes de memorizar algoritmos conviene saber cuándo un modelo funciona.
¿Qué no puede hacer el machine learning?
Un modelo de machine learning depende de sus ejemplos. Aprende las regularidades de los datos con los que se entrena, con sus errores y sus vacíos incluidos. Su desempeño puede caer cuando el mundo cambia y los datos nuevos ya no se parecen a los viejos [14]. Por eso un modelo pide vigilancia, no fe.
El asunto se vuelve delicado cuando el modelo decide sobre personas. En 2019, Manish Raghavan y tres colegas revisaron a las empresas que venden algoritmos para filtrar candidatos a un empleo [15]. Partían de un vacío: se sabía poco de cómo se usaban esos métodos en la práctica [15]. Documentaron lo que esas empresas revelaban sobre cómo los validan y cómo buscan sesgos, que son errores sistemáticos que perjudican a un grupo [15].
Las reglas para que un algoritmo no discrimine, la protección de los datos personales y normas como la ley europea de inteligencia artificial serán tema de la guía de gobierno de datos, en preparación. En Colombia, el 14 de febrero de 2025 se aprobó la Política Nacional de Inteligencia Artificial [16]. Quedó en el documento CONPES 4144, que es como se llaman los grandes planes que aprueba el Consejo Nacional de Política Económica y Social [16].
Vuelvo a Yolanda. Creo que en un proyecto como el de su asociación el algoritmo es lo más barato. Lo valioso son las etiquetas: miles de granos bien calificados por alguien que sabe mirarlos. Ese saber es de ella y de las familias que le llevan su cacao.
Cuando ese saber se vuelve datos, alguien se queda con el modelo que aprende de ellos. Si es la asociación, el machine learning le multiplica el ojo a su mejor catadora. Si es solo el comprador, le enseña a prescindir de ella. La pregunta para Yolanda, y para usted, no es qué programa instalar. ¿Quién va a guardar esas etiquetas?
Preguntas frecuentes
¿Machine learning e inteligencia artificial son lo mismo? No exactamente. La inteligencia artificial abarca los programas o modelos no humanos que resuelven tareas sofisticadas, como traducir un texto o detectar una enfermedad en una radiografía [3]. El machine learning es, formalmente, uno de sus subcampos [3]. El glosario de Google reconoce que, en los últimos años, algunas organizaciones empezaron a usar los dos nombres como si fueran intercambiables [3]. La inteligencia artificial como disciplina tendrá su propia guía, en preparación.
¿En qué se diferencia el machine learning de la estadística? Comparten herramientas; a mi juicio, se separan sobre todo por el propósito. La regresión lineal, por ejemplo, es una técnica estadística para encontrar la relación entre variables, que son cosas que se miden y cambian [17]. En machine learning se usa para relacionar características con una etiqueta [17]. La estadística pregunta cuánto confiar en una conclusión; el machine learning, qué tan bien predice casos nuevos. En el estudio del Banco de la República sobre la inflación, ambos enfoques compitieron en la misma prueba [12]. La regresión lineal y la inferencia tendrán su desarrollo en la guía de estadística para ciencia de datos, en preparación.
¿El deep learning es lo mismo que el machine learning? No: el deep learning, o aprendizaje profundo, es un tipo de machine learning. La oficina de terminología de Quebec lo define como un modo de aprendizaje automático en el que el sistema usa una red de neuronas artificiales, es decir, unidades de cálculo organizadas en varias capas [18]. Con ella aprende de forma progresiva a partir de cantidades enormes de datos [18]. Las redes del Banco de la República para la inflación pertenecen a esa familia [13]. La comparación completa entre IA, machine learning y deep learning tendrá su propia guía, en preparación.
¿Un modelo de machine learning sigue aprendiendo solo cuando ya está en uso? Por lo general, no. Cuando un modelo se aprueba, sus números quedan fijos y se usa para responder casos que llegan sin etiqueta; Google llama inferencias a esas respuestas [7]. Si la realidad cambia, el modelo no se entera por su cuenta. Alguien tiene que notar que su desempeño bajó y volver a entrenarlo con datos recientes, que es lo que Google Cloud llama abrir una nueva iteración del proceso [14].
¿Qué diferencia hay entre un algoritmo y un modelo de machine learning? El algoritmo es el procedimiento de cálculo que aprende; el modelo es lo que queda después de aplicarlo a unos datos concretos. Google Cloud lo muestra en su descripción del trabajo: el científico de datos aplica distintos algoritmos a los datos preparados y obtiene varios modelos [14]. Con los mismos datos, dos algoritmos dan dos modelos distintos. El catálogo de algoritmos y cómo escoger entre ellos será tema de la guía de algoritmos de machine learning, en preparación.
¿Se puede hacer machine learning sin pagar licencias? Sí. Scikit-learn, por ejemplo, es de código abierto y se distribuye con licencia BSD (una licencia libre que permite incluso el uso comercial) [11]. Está construida sobre otras librerías de Python, como NumPy, SciPy y matplotlib [11]. El costo real está en otra parte: en el tiempo para reunir y etiquetar datos, y en formar a quien los trabaja. Cómo usar scikit-learn desde el código será tema de la guía de Python para análisis de datos, y las rutas de estudio, de la guía de rutas y carreras en datos. Las dos están en preparación.
Referencias
Las citas en otro idioma son traducción propia.
- Horta Tellez, Heidi Briggity; García Muñoz, María Cristina; Cerón Salazar, Ivonne Ximena; Sandoval Aldana, Angélica Piedad. Evaluación de la fermentación y calidad final de cinco clones de cacao proveniente del departamento del Huila, Colombia, DYNA, vol. 86, n.º 210, julio-septiembre de 2019, pp. 233-239 — microfermentación de cinco clones de cacao; prueba física de corte al final del proceso de fermentación; la definición de parámetros de fermentación permite mejorar la calidad final del cacao y aumentar su valor comercial. Universidad Nacional de Colombia: revista DYNA, DOI 10.15446/dyna.v86n210.75814 — Consultada: 2026-10-09.
- Sánchez, Karen; Bacca, Jorge; Arévalo-Sánchez, Laura; Arguello, Henry; Castillo, Sergio (Universidad Industrial de Santander). Classification of Cocoa Beans Based on their Level of Fermentation using Spectral Information, TecnoLógicas, vol. 24, n.º 50, publicado el 30 de enero de 2021 — imágenes hiperespectrales de 90 granos de cacao entre 350 y 950 nm en un laboratorio óptico; cada grano clasificado como poco, correctamente o altamente fermentado; comparación con la clasificación de expertos de la Federación Nacional de Cacaoteros reportada en la norma técnica colombiana 1252; el nivel de fermentación de granos secos puede estimarse con técnicas no invasivas de captura y procesamiento de imágenes hiperespectrales. Instituto Tecnológico Metropolitano: revista TecnoLógicas, DOI 10.22430/22565337.1654 — Consultada: 2026-10-09.
- Google for Developers. Machine Learning Glossary, entrada «artificial intelligence» — programa o modelo no humano que resuelve tareas sofisticadas (traducir texto, identificar enfermedades en imágenes radiológicas); «Formally, machine learning is a sub-field of artificial intelligence»; en los últimos años algunas organizaciones usan los dos términos como intercambiables. Google for Developers: Machine Learning Glossary — Consultada: 2026-10-09.
- Google for Developers. Machine Learning Crash Course, Intro to Machine Learning: What is Machine Learning? (página actualizada el 27 de enero de 2026) — «In basic terms, ML is the process of training a piece of software, called a model, to make useful predictions or generate content (like text, images, audio, or video) from data»; ejemplo del pronóstico de lluvia por el enfoque físico frente al de aprendizaje automático; aprendizaje supervisado (regresión y clasificación; correo basura, lluvia), no supervisado (agrupar datos del clima por temperatura, que revela las estaciones), por refuerzo (robots que caminan por una habitación, AlphaGo en el juego de go) e IA generativa. Google for Developers: What is Machine Learning? — Consultada: 2026-10-09.
- Office québécois de la langue française. Grand dictionnaire terminologique, ficha «apprentissage automatique» (última actualización en 2026) — definición: modo de aprendizaje en el que un sistema de inteligencia artificial se optimiza sin que se modifique su programa, para adquirir nuevos conocimientos y aptitudes a partir de datos o reorganizando los ya adquiridos; equivalentes en inglés: machine learning, ML; equivalentes en español: «aprendizaje automático» [España], «aprendizaje de máquina» y «aprendizaje de la computadora» [México]. OQLF: ficha apprentissage automatique — Consultada: 2026-10-09.
- Samuel, Arthur L. Some Studies in Machine Learning Using the Game of Checkers, IBM Journal of Research and Development, vol. 3, n.º 3, 1959, pp. 210-229 — dos procedimientos de aprendizaje automático investigados con el juego de damas; un computador puede programarse para que aprenda a jugar mejor que la persona que escribió el programa. Se cita en paráfrasis: las copias abiertas del artículo son escaneos. IBM Journal of Research and Development: DOI 10.1147/rd.33.0210 — Consultada: 2026-10-09.
- Google for Developers. Intro to Machine Learning: Supervised Learning (página actualizada el 25 de agosto de 2025) — conceptos centrales: datos («Data is the driving force of ML»), modelo («the complex collection of numbers that define the mathematical relationship from specific input feature patterns to specific output label values»), entrenamiento, evaluación e inferencia sobre ejemplos sin etiqueta; definiciones de característica y de etiqueta. Google for Developers: Supervised Learning — Consultada: 2026-10-09.
- Google for Developers. Machine Learning Crash Course, Linear regression: Loss (página actualizada el 5 de enero de 2026) — «Loss is a numerical metric that describes how wrong a model’s predictions are»; el objetivo de entrenar un modelo es minimizar la pérdida hasta su valor más bajo posible. Google for Developers: Linear regression, Loss — Consultada: 2026-10-09.
- Google for Developers. Machine Learning Crash Course, Linear regression: Gradient descent (página actualizada el 3 de febrero de 2026) — el descenso del gradiente es una técnica matemática que encuentra de forma iterativa los pesos y el sesgo que producen el modelo con la menor pérdida; pasos: calcular la pérdida, determinar la dirección que la reduce, mover los valores un poco en esa dirección y repetir; un modelo converge cuando más iteraciones no reducen la pérdida. Google for Developers: Linear regression, Gradient descent — Consultada: 2026-10-09.
- The scikit-learn developers. scikit-learn 1.9.1 User Guide, sección «Cross-validation: evaluating estimator performance» — «Learning the parameters of a prediction function and testing it on the same data is a methodological mistake»; un modelo que solo repitiera las etiquetas vistas tendría una puntuación perfecta pero fallaría con datos no vistos; esa situación se llama sobreajuste (overfitting); práctica habitual de apartar un conjunto de prueba. scikit-learn: Cross-validation, evaluating estimator performance — Consultada: 2026-10-09.
- The scikit-learn developers. scikit-learn: Machine Learning in Python, página principal de la documentación 1.9.1 (versión publicada en septiembre de 2026) — herramientas para el análisis predictivo de datos; construida sobre NumPy, SciPy y matplotlib; código abierto, uso comercial, licencia BSD; clasificación (detección de spam, reconocimiento de imágenes), regresión (respuesta a medicamentos, precios de acciones) y agrupamiento (segmentación de clientes, agrupación de resultados de experimentos). scikit-learn: página principal 1.9.1 — Consultada: 2026-10-09.
- Roldán-Ferrín, Felipe y Parra-Polanía, Julián A. Enhancing inflation nowcasting with online search data: a random forest application for Colombia, Borradores de Economía n.º 1318, Banco de la República, 2025 — modelo de aprendizaje automático basado en random forests con datos de Google Trends para pronosticar en tiempo real la inflación mensual de Colombia; entrenado con inflación histórica, indicadores macroeconómicos y actividad de búsqueda en internet; evaluación fuera de muestra en 2023-2024; supera de forma consistente a los modelos estadísticos (SARIMA, Ridge y Lasso) y es comparable a la mediana de la encuesta mensual de expectativas de analistas financieros del Banco, con predicciones aproximadamente una semana y media antes. Banco de la República: Borrador de Economía 1318, DOI 10.32468/be.1318 · IDEAS/RePEc: ficha del Borrador 1318 — Consultada: 2026-10-09.
- Cárdenas-Cárdenas, Julián Alonso; Cristiano-Botia, Deicy Johana; Martínez-Cortés, Nicolás. Pronóstico de la inflación en Colombia utilizando la metodología Long Short-Term Memory, Borradores de Economía, Banco de la República (publicado el 21 de junio de 2023) — redes neuronales LSTM, «una metodología de aprendizaje profundo»; superan en capacidad de pronóstico a modelos tipo ARIMA, en especial en horizontes de siete a 12 meses; el documento se presenta como «una herramienta adicional en la batería de modelos utilizados por el Banco de la República para el pronóstico de la inflación en Colombia». Banco de la República: Pronóstico de la inflación con la metodología LSTM — Consultada: 2026-10-09.
- Google Cloud. MLOps: Continuous delivery and automation pipelines in machine learning, Cloud Architecture Center (página actualizada el 28 de agosto de 2024) — después de definir el caso de uso y los criterios de éxito, los pasos para llevar un modelo a producción: extracción, análisis y preparación de datos, entrenamiento con distintos algoritmos, evaluación con un conjunto de prueba, validación frente a una línea base, despliegue y monitoreo que puede abrir una nueva iteración; el desempeño de un modelo puede caer por perfiles de datos que cambian; solo una pequeña fracción de un sistema real de machine learning es código de machine learning. Google Cloud: MLOps, continuous delivery and automation pipelines — Consultada: 2026-10-09.
- Raghavan, Manish; Barocas, Solon; Kleinberg, Jon; Levy, Karen. Mitigating Bias in Algorithmic Hiring: Evaluating Claims and Practices (arXiv 1906.09208, versión 3 del 6 de diciembre de 2019; versión publicada con DOI de la ACM 10.1145/3351095.3372828) — hasta entonces se sabía poco de cómo se usan en la práctica los algoritmos de contratación; documenta lo que revelan los proveedores de evaluaciones algorítmicas previas al empleo sobre su desarrollo y validación; analiza los riesgos de sus decisiones sobre recolección de datos y objetivos de predicción. arXiv: Mitigating Bias in Algorithmic Hiring — Consultada: 2026-10-09.
- Consejo Nacional de Política Económica y Social, República de Colombia. Documento CONPES 4144: Política Nacional de Inteligencia Artificial (versión aprobada, Bogotá, 14 de febrero de 2025), compilado en el normograma del Ministerio de Tecnologías de la Información y las Comunicaciones. MinTIC: normograma, Documento CONPES 4144 de 2025 — Consultada: 2026-10-09.
- Google for Developers. Machine Learning Crash Course, Linear regression (página actualizada el 9 de diciembre de 2025) — «Linear regression is a statistical technique used to find the relationship between variables»; en el contexto del aprendizaje automático encuentra la relación entre características y etiqueta. Google for Developers: Linear regression — Consultada: 2026-10-09.
- Office québécois de la langue française. Grand dictionnaire terminologique, ficha «apprentissage profond» (última actualización en 2026) — modo de aprendizaje automático en el que un sistema de inteligencia artificial, con una red de neuronas artificiales de varias capas jerarquizadas que interactúan entre sí, aprende de forma progresiva a partir de megadatos; equivalente en inglés: deep learning. OQLF: ficha apprentissage profond — Consultada: 2026-10-09.
Cómo investigamos esta página
- Pregunta que responde: Qué es el machine learning, qué significa en español, cómo aprende un modelo, cuáles son sus paradigmas, para qué sirve y qué límites tiene.
- Fuentes: identificadas 35 → incluidas 18 (documentación de Google y scikit-learn, un diccionario terminológico público, artículos por DOI y estudios del Banco de la República).
- Criterios de inclusión: solo documentación oficial, investigación publicada y registros públicos leídos hoy; ninguna enciclopedia, blog ni nota de prensa.
- Fecha de corte de los datos: 2026-10-09