
Bases de datos jerárquicas: el modelo de árbol que aún sobrevive
Una base de datos jerárquica guarda la información como un árbol: cada registro hijo depende de un único padre, y para llegar a un dato se baja desde la raíz. Es rápida para recorrer caminos conocidos, pero no representa bien las relaciones de muchos a muchos; el modelo en red nació para eso. Hoy la jerarquía sigue viva en los nombres de dominio y en los directorios.
Última actualización: 2026-11-02
Contenido de esta página
- ¿Qué es una base de datos jerárquica?
- ¿Cómo funciona el modelo jerárquico de base de datos?
- Ejemplo de base de datos jerárquica: el concesionario de IBM
- IBM IMS: la base de datos jerárquica que nació con el Apollo
- Ejemplos de bases de datos jerárquicas que usa todos los días
- Modelo en red de base de datos (CODASYL): la respuesta al límite del árbol
- Ventajas y desventajas del modelo jerárquico
- ¿Cómo se guarda una jerarquía en una base de datos relacional?
- ¿Vale la pena aprender el modelo jerárquico hoy?
Historia real. En noviembre de 1987, Paul Mockapetris publicó el documento que describe los conceptos del sistema de nombres de dominio de internet [1]. Empezaba contando un problema de crecimiento.
Antes del sistema de nombres de dominio, una lista unía el nombre de cada computador con su dirección. Vivía en un solo archivo de texto, llamado HOSTS.TXT (algo así como «computadores.txt») [1]. Lo mantenía el Centro de Información de la Red, y todos los computadores conectados lo descargaban [1]. El costo de repartir cada versión nueva crecía con el cuadrado del número de máquinas [1]. Y cada organización que cambiaba un nombre tenía que esperar a que ese centro editara el archivo [1].
La salida fue un espacio de nombres jerárquico: niveles que siguen, a grandes rasgos, la estructura de las organizaciones, separados por puntos [1]. Mockapetris lo dice sin rodeos: el espacio de nombres de dominio es una estructura de árbol [1]. Por eso, en el nombre de este sitio, la jerarquía se recorre de derecha a izquierda: arriba está «com» y, debajo, «jhonmosquera».
Esa idea, un árbol donde cada cosa cuelga de una sola cosa superior, es la base de datos jerárquica. En el repaso clásico de Michael Stonebraker y Joseph Hellerstein, dos investigadores de bases de datos, es la primera de las épocas de los modelos de datos [5]. Y, como muestran los nombres de dominio, una idea difícil de matar.
¿Qué es una base de datos jerárquica?
Una base de datos jerárquica organiza la información como un árbol genealógico al revés. Arriba hay un registro raíz, y de él cuelgan registros hijos, que a su vez tienen sus propios hijos. Cada hijo tiene un solo padre. Un padre, en cambio, puede tener muchos hijos. Para encontrar un dato, el programa baja por las ramas desde la raíz hasta la hoja que busca [2] [3].
Un ejemplo de casa ayuda. En un computador, la carpeta «Documentos» contiene la carpeta «2026», que contiene el archivo de la factura. El archivo no puede estar dentro de dos carpetas al mismo tiempo. La documentación de PostgreSQL, un gestor de bases de datos, pone justamente ese caso. Según ella, los archivos y directorios de los sistemas tipo Unix, una familia de sistemas operativos, forman una base de datos jerárquica [4].
Las bases de datos jerárquicas son, entonces, uno de los modelos de datos que existen junto a las tablas, los documentos o los grafos. En la guía de tipos de bases de datos aparecen ordenadas por ese y otros criterios.
¿Cómo funciona el modelo jerárquico de base de datos?
El modelo jerárquico funciona con una sola regla: cada registro, salvo la raíz, depende de un único registro superior. Esa relación se llama de uno a muchos, o 1:N, porque un padre puede tener N hijos y cada hijo tiene exactamente un padre. Todo lo demás, desde cómo se guarda hasta cómo se consulta, sale de esa regla [3].
IMS, el gestor jerárquico de la empresa estadounidense IBM, le pone nombre a cada pieza; su sigla viene de «sistema de gestión de información» en inglés. A cada caja del árbol la llama segmento, que es un grupo de datos relacionados, parecido a una fila [2] [3]. El vocabulario es este, según la presentación técnica que IBM dio en 2002 [3]:
- Raíz: el segmento de arriba. Hay una y solo una por cada registro de la base, y no tiene nada por encima.
- Padre: todo segmento que tiene dependientes en el nivel de abajo. Puede tener cualquier cantidad.
- Hijo: el segmento que depende de otro superior.
- Gemelos: las apariciones del mismo tipo de segmento bajo el mismo padre, por ejemplo, varios pedidos de un mismo modelo de carro.
- Hermanos: segmentos de tipos distintos que cuelgan del mismo padre.
La regla de oro la escribe IBM en una línea: «todo segmento hijo tiene uno y solo un padre» [3] (las citas en inglés de esta página son traducción propia).
Punteros y recorrido: cómo se llega a un dato
Un puntero es una dirección guardada dentro de un registro que dice dónde está el siguiente. En IMS, cada segmento se guarda con un prefijo, una cabecera que va antes de sus datos, y ahí viven los punteros [3]. Uno apunta al primer hijo, otro al gemelo siguiente, otro al siguiente segmento en el orden del árbol [3]. Gracias a eso, en la organización llamada directa, los segmentos pueden guardarse en cualquier parte y no se mueven físicamente [3].
El orden de lectura es fijo: de arriba abajo, de izquierda a derecha y, entre gemelos, de adelante hacia atrás [3]. Las órdenes de consulta se apoyan en él. «Siguiente dentro del padre», por ejemplo, lee el próximo segmento bajo un padre concreto y se detiene cuando se acaba esa rama [3] [5].
Jerarquía de datos: base, registro, segmento y campo
La jerarquía de datos de IMS tiene cuatro niveles, de lo grande a lo pequeño [3]:
- Base de datos: un grupo de registros relacionados.
- Registro: una sola jerarquía de segmentos, que empieza en una raíz.
- Segmento: un grupo de campos relacionados.
- Campo: un solo dato, que puede servir como clave para ordenar o para buscar.
Ejemplo de base de datos jerárquica: el concesionario de IBM
IBM trae en su documentación un ejemplo de base de datos jerárquica que se entiende sin saber programar: un concesionario de carros [2]. El árbol tiene cinco tipos de segmento:
- Concesionario (raíz): nombre y número único de cada vendedor de carros.
- Modelo (hijo del concesionario): cada tipo de carro que ese concesionario maneja.
- Pedido, Venta e Inventario (hijos del modelo): un pedido por carro encargado, un registro de inventario por carro disponible y uno de venta cuando se vende.
La consecuencia práctica está en la misma página. No se puede insertar un pedido que no cuelgue de un modelo específico [2]. IBM compara esa regla con la integridad referencial de las bases relacionales, el control que impide guardar una fila que apunta a otra que no existe [2].
Hay otra diferencia que IBM destaca. En el árbol, cada segmento ya está unido a su padre y a sus hijos por el camino jerárquico. En una base de tablas, esa unión hay que pedirla en cada consulta [2].
IBM IMS: la base de datos jerárquica que nació con el Apollo
IMS es el caso fundacional del modelo. American Rockwell ganó el contrato para construir la nave del programa Apollo [6]. Según la documentación de IBM, en 1965 se asoció con IBM para automatizar las enormes listas de materiales de la nave [6]. En 1966, según esa misma documentación técnica, un equipo de IBM, de esa empresa y de Caterpillar Tractor empezó el diseño formal del sistema [6]. La historia corporativa de IBM sitúa los primeros trabajos antes, en 1963 [16]. En 1969 se rebautizó IMS/360 y salió al mercado [6]. La cronología completa, con lo que vino después, está en la historia de las bases de datos.
¿Sigue vivo? IBM lo vende hoy como una base de datos jerárquica de alto rendimiento para z/OS, un sistema operativo de la propia IBM [7]. La empresa cita un caso: Atruvia, socia digital de más de 800 bancos cooperativos de Alemania [7]. Atruvia usa IMS junto con Db2, otro gestor de IBM, en su núcleo bancario [7]. IBM advierte que sus ejemplos de clientes son ilustrativos [7].
Ese dato no dice cuántos bancos usan IMS en el mundo. Dice algo más modesto y más útil: que un sistema cuyo diseño formal empezó en 1966 sostiene hoy, según IBM, operaciones de banca.
Ejemplos de bases de datos jerárquicas que usa todos los días
Quizá usted nunca vea un gestor jerárquico, pero la jerarquía sobrevive en sistemas que usa a diario. Cada uno de estos casos es un árbol según su documentación oficial:
| Dónde | Cómo lo describe su documentación oficial | Fuente |
|---|---|---|
| Nombres de dominio (DNS, el directorio de nombres de internet) | Un árbol: cada nodo tiene una etiqueta y la raíz tiene la etiqueta vacía | [1] |
| Directorios LDAP, un protocolo para consultar directorios de usuarios y equipos | Entradas organizadas en un árbol, cada una subordinada a una superior | [8] [9] |
| Active Directory, el directorio de cuentas y equipos de Windows Server | Una organización lógica y jerárquica de usuarios, computadores, impresoras y servidores | [10] [11] |
| Registro de Windows, la base de configuración del sistema | Una base de datos jerárquica en forma de árbol, con claves, subclaves y valores | [12] |
| Sistema de archivos tipo Unix | Archivos y directorios como ejemplo de base de datos jerárquica | [4] |
Dos de estos casos merecen una línea más. En LDAP, el nombre completo de una entrada se arma pegando su propio nombre al de su superior, como una dirección postal que va de lo pequeño a lo grande [8]. Y Microsoft documenta que Active Directory es un servidor de LDAP, así que ambos comparten esa lógica de árbol [11].
Microsoft es igual de directo con el registro de Windows: lo define como una base de datos jerárquica, con datos en forma de árbol donde cada nodo es una clave [12].
¿Y los formatos de intercambio? JSON, el formato de texto que usan muchas aplicaciones web, permite objetos dentro de objetos; su norma deja que cada programa fije una profundidad máxima de anidamiento [13].
Modelo en red de base de datos (CODASYL): la respuesta al límite del árbol
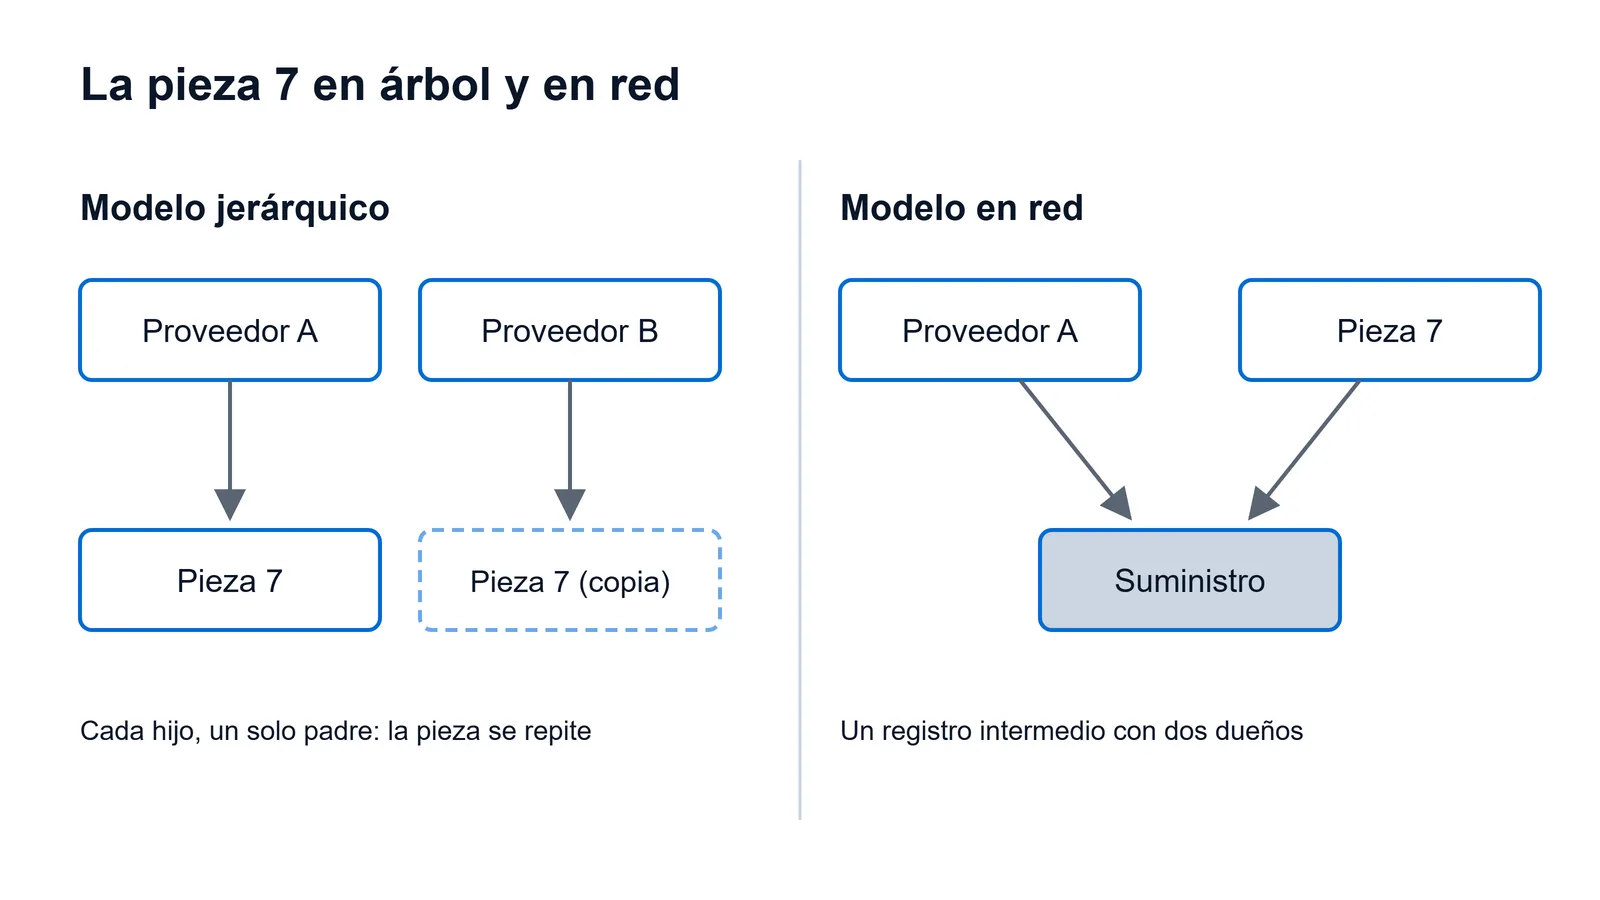
El modelo en red es la versión del árbol que admite varios padres. Lo promovió CODASYL, el comité de lenguajes de sistemas de datos, con un primer informe en 1969 y especificaciones de lenguaje en 1971 y 1973 [5]. En una red, un registro puede tener varios dueños, no uno solo como en IMS [5].
¿Por qué hacía falta? Por las relaciones de muchos a muchos, o N:M. Un proveedor vende muchas piezas, y cada pieza la pueden vender muchos proveedores. Stonebraker y Hellerstein usan ese ejemplo en su repaso de 2005 [5]. En un árbol hay que escoger quién es el padre. Si es el proveedor, los datos de cada pieza se repiten bajo cada proveedor que la vende. Y no puede existir una pieza que nadie suministre todavía [5].
La red lo resuelve con un registro intermedio, «Suministro», que tiene dos dueños: el proveedor y la pieza [5]. Cada enlace entre un dueño y sus registros hijos se llama conjunto, y por dentro sigue siendo de uno a muchos [5]. La relación de muchos a muchos sale de combinar dos de esos enlaces.
El precio fue la complejidad. Los mismos autores lo resumen así: «en IMS un programador navega en un espacio jerárquico, mientras que un programador de CODASYL navega en un hiperespacio multidimensional» [5].
| Criterio | Modelo jerárquico | Modelo en red (CODASYL) |
|---|---|---|
| Relación que admite | Uno a muchos (1:N): cada hijo, un solo padre | Uno a muchos por enlace, pero un registro puede tener varios dueños; el N:M se arma con un registro intermedio |
| Cómo se navega | Bajando desde la raíz en un orden fijo | Entrando por un punto de acceso y siguiendo enlaces, el programador debe recordar en qué registro va dentro de cada enlace |
| Ejemplo | IMS de IBM | La propuesta del comité CODASYL, con informes de 1969, 1971 y 1973 |
| Límite | Repite datos y no admite un hijo sin padre | Más difícil de programar, cargar y recuperar tras una falla |
| Fuente | [2] [3] [5] | [5] |
Ventajas y desventajas del modelo jerárquico
La ventaja principal es la velocidad cuando el camino ya se conoce. Si la pregunta sigue la forma del árbol, como «dame los pedidos de este modelo», el programa solo tiene que seguir los punteros de esa rama [3]. Stonebraker y Hellerstein explican que las rarezas de IMS se diseñaron para evitar operaciones con un rendimiento imposible de aceptar [5]. IBM, por su parte, presenta hoy a IMS como una base jerárquica de alto rendimiento [7].
Las desventajas son el reverso de esa misma rigidez:
- Datos repetidos. Si una cosa pertenece a dos padres, se copia en los dos lugares, y una copia puede quedar desactualizada [5].
- Hijos que no pueden existir solos. Un pedido sin modelo, o una pieza sin proveedor, no tiene dónde guardarse [2] [5].
- Muchos a muchos imposible de forma directa. IMS tuvo que ampliar la idea de bases «lógicas» para representar datos que no tienen forma de árbol [5].
- Cambiar cuesta. Reorganizar el almacenamiento no garantizaba que los programas siguieran funcionando [5].
La lección que sacan los autores cabe en una frase: los modelos de datos con estructura de árbol son muy restrictivos [5]. Las bases de datos relacionales, que guardan todo en tablas, respondieron a ese problema. Según los mismos autores, a Edgar Codd lo movía el tiempo que los programadores de IMS gastaban en mantener sus aplicaciones cada vez que algo cambiaba [5].
¿Cómo se guarda una jerarquía en una base de datos relacional?
En una base relacional, un árbol se puede guardar dentro de una sola tabla, con una columna que apunta al padre. Para recorrerlo se usa una consulta recursiva, es decir, una consulta que se llama a sí misma nivel por nivel. La documentación de SQLite, el gestor con el que corrí el ejemplo, la describe como la capacidad de hacer consultas jerárquicas sobre árboles y grafos [14].
El ejemplo usa una jerarquía colombiana real: la división político-administrativa del DANE, el Departamento Administrativo Nacional de Estadística. Santander tiene el código 68, y sus municipios llevan códigos que empiezan por 68, como Bucaramanga, 68001 [15]. En los cuatro municipios del ejemplo, el código del hijo arranca con el del padre. Lo corrí con SQLite 3.53.1 desde Python 3.11:
-- Árbol padre-hijo: cada fila guarda el código de su padre
CREATE TABLE territorio (
  codigo TEXT PRIMARY KEY,      -- código DIVIPOLA del DANE ('CO' es etiqueta propia)
  nombre TEXT NOT NULL,
  padre  TEXT REFERENCES territorio(codigo)  -- NULL solo en la raíz
);

INSERT INTO territorio VALUES
  ('CO',    'Colombia',      NULL),
  ('68',    'Santander',     'CO'),
  ('68001', 'Bucaramanga',   '68'),
  ('68276', 'Floridablanca', '68'),
  ('68307', 'Girón',         '68'),
  ('68547', 'Piedecuesta',   '68');

-- Recorrido de arriba abajo con una consulta recursiva (WITH RECURSIVE)
WITH RECURSIVE arbol(codigo, nombre, nivel) AS (
  SELECT codigo, nombre, 0 FROM territorio WHERE padre IS NULL   -- empieza en la raíz
  UNION ALL
  SELECT t.codigo, t.nombre, a.nivel + 1                          -- baja un nivel
  FROM territorio AS t JOIN arbol AS a ON t.padre = a.codigo
  ORDER BY 3 DESC                                                 -- primero en profundidad
)
SELECT substr('        ', 1, nivel * 4) || nombre || ' (' || codigo || ')' AS ruta
FROM arbol;

-- Camino de una hoja a la raíz: los ancestros de Girón
WITH RECURSIVE camino(codigo, nombre, padre, paso) AS (
  SELECT codigo, nombre, padre, 0 FROM territorio WHERE codigo = '68307'
  UNION ALL
  SELECT t.codigo, t.nombre, t.padre, c.paso + 1                  -- sube un nivel
  FROM territorio AS t JOIN camino AS c ON t.codigo = c.padre
)
SELECT group_concat(nombre, ' > ' ORDER BY paso) AS ruta FROM camino;
La salida, tal como la imprimió el programa:
Colombia (CO)
    Santander (68)
        Bucaramanga (68001)
        Floridablanca (68276)
        Girón (68307)
        Piedecuesta (68547)
Girón > Santander > Colombia
La primera consulta baja desde la raíz, igual que IMS. La segunda sube de una hoja a la raíz, igual que se lee un nombre de dominio. Si quiere practicar la sintaxis de esas consultas, la guía de SQL es el punto de partida. Cuánto cuesta recorrer un árbol grande ya es un asunto de algoritmos, no de modelos de datos.
¿Vale la pena aprender el modelo jerárquico hoy?
Aquí va mi opinión: sí, aunque usted nunca toque un computador central. No para diseñar una base nueva con él, sino porque muchos de los sistemas que administra un analista de datos en Colombia son árboles disfrazados. El directorio de usuarios de la empresa, los dominios, las carpetas compartidas, la división territorial con la que cruza cualquier encuesta.
Quien entiende por qué un árbol no admite dos padres deja de pelear con esos sistemas y empieza a modelarlos bien. Mockapetris dejó escrito en 1987 cómo un árbol resolvía un problema de crecimiento. Treinta y nueve años después, ese árbol sigue respondiendo cada vez que alguien escribe una dirección web.
Preguntas frecuentes
¿Por qué se dice que el modelo jerárquico es un árbol invertido?
Porque se dibuja con la raíz arriba y las ramas hacia abajo, al revés de un árbol del campo. En los diagramas de IBM, la raíz ocupa el nivel 1 y los segmentos dependientes van en los niveles 2, 3 y 4 [3]. La forma no tiene que ver con que la base sea de transacciones o de análisis: describe solo cómo se relacionan los registros.
¿Una base de datos jerárquica es lo mismo que una relacional?
No. En la relacional, los datos viven en tablas y la relación entre ellas se declara con claves; en la jerárquica, la relación está en la forma del árbol. IBM muestra que un segmento de IMS se puede leer como una tabla y una aparición de segmento como una fila, pero la unión con el padre ya viene dada [2].
¿Qué es un segmento gemelo en IMS?
Es cada aparición de un mismo tipo de segmento bajo el mismo padre. Si un modelo de carro tiene tres pedidos, esos tres pedidos son gemelos entre sí. Puede haber cualquier cantidad, y un puntero de gemelo enlaza cada uno con el siguiente [3].
¿El modelo en red es lo mismo que una base de datos de grafos?
Se parecen en la idea de registros unidos por enlaces que forman un grafo conectado [5]. La diferencia práctica está en cómo se consulta: en CODASYL el programador recorre los enlaces registro por registro y lleva la cuenta de su posición en cada uno [5]. Las bases de grafos actuales son otro tipo de sistema, con su propia forma de consultar.
¿Las carpetas del computador son una base de datos?
En sentido amplio, sí. La documentación de PostgreSQL usa los archivos y directorios de los sistemas tipo Unix como ejemplo de organización jerárquica de datos [4]. Lo que no tienen, frente a un gestor, son las consultas, los controles de integridad y la recuperación ante fallas.
Referencias
- Mockapetris, Paul. RFC 1034: Domain Names — Concepts and Facilities (IETF, noviembre de 1987) — autor del Instituto de Ciencias de la Información (ISI); historia de los nombres de dominio: el archivo único HOSTS.TXT mantenido por el Centro de Información de la Red (NIC) y descargado por todos los computadores; costo de distribución proporcional al cuadrado del número de computadores; organizaciones que debían esperar a que el NIC cambiara el archivo; espacio de nombres jerárquico que sigue aproximadamente la estructura organizacional, con el punto como separador; «The domain name space is a tree structure»; raíz con etiqueta vacía. RFC Editor: RFC 1034 — Consultada: 2026-11-02.
- IBM. Comparison of hierarchical and relational databases, documentación de IMS 13.1.0 — segmento comparable a una tabla y aparición de segmento comparable a una fila; los segmentos están unidos implícitamente con su padre y sus hijos, mientras que en una base relacional hay que unir las tablas de forma explícita; base de ejemplo Dealership con cinco tipos de segmento (raíz Dealer, hijo Model, y Order, Sales y Stock bajo Model); no se puede insertar un Order sin un Model padre, comparable a la integridad referencial. IBM Documentation: Comparison of hierarchical and relational databases — Consultada: 2026-11-02.
- Ryan, Charles (IBM Silicon Valley Lab). IMS Database Basics, IMS Technical Conference, 2002 — base de datos, registro, segmento y campo; una sola raíz por registro; padre con cualquier número de dependientes; «Every child segment has one and only one parent»; gemelos y hermanos; orden jerárquico de arriba abajo, de izquierda a derecha y de adelante hacia atrás; órdenes Get Unique, Get Next y Get Next Within Parent; punteros en el prefijo del segmento (jerárquicos, de primer hijo y de gemelo); diagrama con la raíz en el nivel 1 y segmentos hasta el nivel 4. IBM: IMS Database Basics (PDF) — Consultada: 2026-11-02.
- The PostgreSQL Global Development Group. PostgreSQL Documentation, sección «Concepts» del tutorial — «Files and directories on Unix-like operating systems form an example of a hierarchical database». PostgreSQL: Documentation, Concepts — Consultada: 2026-11-02.
- Stonebraker, Michael y Hellerstein, Joseph M. What Goes Around Comes Around, capítulo 1 de Readings in Database Systems, 4.ª edición (MIT Press, 2005) — IMS lanzado hacia 1968 con modelo jerárquico; cada tipo de registro salvo la raíz tiene un único padre; ejemplo proveedor-pieza-suministro: repetición de información y dependencia de existencia en un árbol; las rarezas de IMS buscaban evitar operaciones de rendimiento imposible; independencia física de datos limitada; bases lógicas para datos que no son árboles; lección 2, «Tree structured data models are very restrictive»; CODASYL publicó su primer informe en 1969 y especificaciones en 1971 y 1973; en la red un registro puede tener varios padres; los conjuntos son relaciones de uno a muchos entre dueño y miembro; red como grafo conectado con al menos un punto de entrada; navegación registro por registro con indicadores de posición; «In IMS a programmer navigates in a hierarchical space, while a CODASYL programmer navigates in a multi-dimensional hyperspace»; carga y recuperación más complejas que en IMS; según los autores, lo que movía a Codd era el tiempo que los programadores de IMS gastaban en mantenimiento cuando había cambios lógicos o físicos. Universidad de Washington: copia del capítulo para curso (PDF) — Consultada: 2026-11-02.
- IBM. History of IMS: Beginnings at NASA, z/OS Basic Skills (IBM Documentation) — American Rockwell ganó el contrato de la nave del programa Apollo y en 1965 se asoció con IBM para automatizar las listas de materiales; en 1966, 12 miembros de IBM, 10 de American Rockwell y 3 de Caterpillar Tractor empezaron a diseñar el sistema ICS/DL/I; en 1969 se rebautizó Information Management System/360 (IMS/360) y quedó disponible para el mercado. IBM Documentation: History of IMS, Beginnings at NASA — Consultada: 2026-11-02.
- IBM. IBM Information Management System (IMS), página de producto — «A high-performance hierarchical database and transaction manager for z/OS»; caso de Atruvia AG, «the digital partner for more than 800 cooperative banks in Germany», que usa IBM zSystems, IMS y Db2 en su núcleo bancario; aviso de que los ejemplos de clientes se presentan con fines ilustrativos. IBM: Information Management System — Consultada: 2026-11-02.
- Zeilenga, Kurt (ed.). RFC 4512: Lightweight Directory Access Protocol (LDAP): Directory Information Models (IETF, junio de 2006) — las entradas del directorio se organizan jerárquicamente en un árbol llamado Directory Information Tree; relación de superior inmediato y subordinado; el nombre distinguido de una entrada es la concatenación de su nombre relativo y el nombre distinguido de su superior inmediato. RFC Editor: RFC 4512 — Consultada: 2026-11-02.
- Sermersheim, Jim (ed.). RFC 4511: Lightweight Directory Access Protocol (LDAP): The Protocol (IETF, junio de 2006) — la búsqueda puede leer una sola entrada, las subordinadas inmediatas de una entrada o un subárbol completo (alcance wholeSubtree). RFC Editor: RFC 4511 — Consultada: 2026-11-02.
- Microsoft. Active Directory Domain Services overview (Windows Server 2016 a 2025, actualizado el 10 de marzo de 2025) — «A directory is a hierarchical structure that stores information about objects on a network»; AD DS usa un almacén estructurado como base de una organización lógica y jerárquica; objetos típicos: servidores, volúmenes, impresoras y cuentas de usuarios y computadores. Microsoft Learn: Active Directory Domain Services overview — Consultada: 2026-11-02.
- Microsoft. [MS-ADOD]: Protocol Summary, Active Directory Protocols Overview — «Active Directory is a server for LDAP», versiones 2 y 3, en los modos AD DS y AD LDS. Microsoft Learn: MS-ADOD Protocol Summary — Consultada: 2026-11-02.
- Microsoft. Structure of the Registry, documentación de Win32 — «The registry is a hierarchical database that contains data that is critical for the operation of Windows»; los datos tienen forma de árbol, cada nodo es una clave y cada clave puede contener subclaves y valores. Microsoft Learn: Structure of the Registry — Consultada: 2026-11-02.
- Bray, Tim (ed.). RFC 8259: The JavaScript Object Notation (JSON) Data Interchange Format (IETF, diciembre de 2017) — un valor puede ser un objeto o un arreglo; «An implementation may set limits on the maximum depth of nesting». RFC Editor: RFC 8259 — Consultada: 2026-11-02.
- SQLite. The WITH Clause — las expresiones de tabla comunes recursivas «provide the ability to do hierarchical or recursive queries of trees and graphs»; ejemplos de consultas jerárquicas sobre una tabla de organización con columna de jefe; control del recorrido en profundidad con ORDER BY. Ejemplo ejecutado con SQLite 3.53.1 (publicada el 5 de mayo de 2026, según el registro de cambios del proyecto). SQLite: The WITH Clause — Consultada: 2026-11-02.
- Departamento Administrativo Nacional de Estadística (DANE). DIVIPOLA – Códigos municipios, conjunto de datos en el portal de datos abiertos — código de departamento 68 (Santander) y códigos de municipio 68001 (Bucaramanga), 68276 (Floridablanca), 68307 (Girón) y 68547 (Piedecuesta). Datos Abiertos Colombia: DIVIPOLA, códigos de municipios — Consultada: 2026-11-02.
- IBM. Information Management Systems (página de IBM Heritage, historia de la empresa) — «In 1963, IBM’s Uri Berman teamed with Rockwell’s Peter Nordyke to address an urgent request from the space program for a parts tracker and a version manager». IBM: Information Management Systems — Consultada: 2026-11-02.
Cómo investigamos esta página
- Pregunta que responde: Qué es una base de datos jerárquica, cómo funciona el árbol padre-hijo y por qué nació el modelo en red.
- Fuentes: identificadas 28 → incluidas 15
- Criterios de inclusión: documentación oficial de IBM, Microsoft, PostgreSQL y SQLite, normas de internet, un capítulo académico y datos del DANE; nada de enciclopedias ni blogs.
- Fecha de corte de los datos: 2026-11-02