Bases de datos relacionales: qué son, cómo se conectan sus tablas y ejemplos
Una base de datos relacional organiza la información en tablas que se enlazan por identificadores compartidos, llamados claves. Cada dato se escribe una sola vez y las demás tablas lo señalan; así el motor puede cruzarlas y rechazar lo que no cuadra. Aquí verá cómo funciona, sus tres tipos de relación y cuatro ejemplos resueltos.
Última actualización: 2026-10-18
Contenido de esta página
- ¿Qué es una base de datos relacional?
- Clave primaria y clave foránea: cómo se conectan las tablas
- Los tres tipos de relaciones en una base de datos: 1:1, 1:N y N:M
- ¿Cómo funciona una consulta con JOIN? Unir tablas sin escribir código
- Integridad referencial: la regla que impide los registros huérfanos
- Ejemplos de bases de datos relacionales resueltos: tienda, colegio, clínica y biblioteca
- Ventajas de las bases de datos relacionales
- Límites de las bases de datos relacionales: esquema rígido y escalado vertical
- ¿Cuándo no usar una base de datos relacional?
- ¿Qué cambia cuando cada dato vive en un solo lugar?
Escena compuesta, con nombre ficticio: Marcela es la secretaria académica de un colegio público de Girón, en Santander. Cada profesor lleva sus notas en su propia hoja de cálculo, y cada hoja empieza con la lista de estudiantes copiada a mano. Son once hojas por curso.
En marzo, un estudiante se retira y otra corrige su apellido en el registro. La novedad llega a seis hojas y no a las otras cinco. Al cierre del periodo, Marcela arma los boletines pegando columnas de once archivos. Una nota de Ciencias termina en el boletín de un compañero con un apellido parecido. Lo descubre el acudiente.
A Marcela no le faltan datos. Le sobra un estudiante repetido once veces.
Eso es justo lo que arregla una base de datos relacional. El estudiante se escribe una sola vez, en una tabla de estudiantes, con un número que lo identifica. Las notas no repiten su nombre: guardan ese número y apuntan a él. Si el apellido cambia, cambia en un solo lugar, y el boletín sale de cruzar las tablas por ese número.
¿Qué es una base de datos relacional?
Una base de datos relacional reparte la información en varias tablas, cada una sobre un solo tema, y las conecta mediante columnas en común llamadas claves. Cada tabla tiene filas, que son los registros, y columnas con un tipo de dato fijo. El programa que la administra se llama sistema gestor de bases de datos relacionales, o RDBMS por su sigla en inglés.
La documentación de PostgreSQL, un gestor libre, se presenta así: PostgreSQL es un RDBMS, un sistema para administrar datos guardados en relaciones [1]. Y aclara de inmediato que relación es, en esencia, el término matemático para tabla [1].
Ese detalle desarma una confusión frecuente. En el nombre, «relacional» no se refiere en primer lugar al vínculo entre dos tablas, sino a la tabla misma. Los vínculos existen, y son la parte más útil, pero se construyen con claves.
Cada tabla es una colección de filas con nombre, y todas sus filas tienen las mismas columnas, cada una con un tipo de dato definido: número, texto o fecha [1]. El manual de MySQL, otro gestor libre, describe la idea de fondo con una imagen doméstica. Una base relacional guarda los datos en tablas separadas, en lugar de amontonarlos todos en un solo gran depósito [2].
Si lo que busca es qué es una base de datos en general, para qué sirve y qué otros tipos existen, empiece por la guía de bases de datos. Esta página se queda con las relacionales.
Modelo relacional de base de datos: la idea en un párrafo
El modelo relacional es la idea que sostiene a estas bases de datos: organizar la información en tablas que se pueden enlazar por características comunes. Así se obtienen respuestas combinándolas, sin que el usuario tenga que saber cómo están guardados los datos en el disco. Lo propuso Edgar F. Codd, investigador de IBM, en un artículo de 1970 [3].
Según la historia que publica IBM, el diseño de Codd permitía armar una tabla nueva a partir de otras con una sola consulta [3]. Cada esquema de tablas de esta página es, en la práctica, un ejemplo de modelo relacional: tablas, claves y reglas.
La parte formal del modelo, con su vocabulario matemático y sus operaciones, tendrá su propia guía, modelo relacional, que está en preparación.
Clave primaria y clave foránea: cómo se conectan las tablas
La clave primaria es la columna que identifica cada fila de una tabla sin repetirse, como la cédula identifica a una persona. La clave foránea es una columna de otra tabla que guarda ese mismo identificador para señalar a quién se refiere. Con esas dos piezas, una nota sabe de qué estudiante es sin copiar su nombre.
La documentación de PostgreSQL 18 (versión 18.6, consultada en octubre de 2026) fija las reglas. Una clave primaria exige valores únicos y nunca vacíos [4]. Cada tabla puede tener como máximo una, aunque puede abarcar varias columnas a la vez; a eso se le llama clave compuesta [4].
La clave foránea, por su parte, obliga a que sus valores coincidan con los de alguna fila de otra tabla [4]. Y no puede apuntar a cualquier columna. Debe señalar una clave primaria o una columna que no admita repetidos [4].
La documentación de SQLite, un motor que no necesita servidor, pone nombre a los dos lados. La tabla padre es la que recibe la referencia; la tabla hija es la que lleva la clave foránea [5]. En el colegio de Marcela, estudiantes es la tabla padre y calificaciones, la hija.
Así se ve ese colegio escrito para SQLite 3. Son tres tablas: estudiantes, asignaturas y la tabla que las une, calificaciones.
-- Colegio: tres tablas unidas por claves. Escrito para SQLite 3.
-- En PostgreSQL 18 corre igual si se borra la línea PRAGMA.
PRAGMA foreign_keys = ON;  -- SQLite: activa las claves foráneas en esta conexión

CREATE TABLE estudiantes (
  id_estudiante INTEGER PRIMARY KEY,  -- clave primaria: un número por estudiante
  nombre        TEXT NOT NULL
);

CREATE TABLE asignaturas (
  id_asignatura INTEGER PRIMARY KEY,  -- clave primaria: un número por asignatura
  nombre        TEXT NOT NULL
);

-- Tabla puente: une estudiantes y asignaturas (relación de muchos a muchos)
CREATE TABLE calificaciones (
  id_estudiante INTEGER NOT NULL REFERENCES estudiantes (id_estudiante),  -- clave foránea
  id_asignatura INTEGER NOT NULL REFERENCES asignaturas (id_asignatura),  -- clave foránea
  periodo       INTEGER NOT NULL,
  desempeno     TEXT NOT NULL
    CHECK (desempeno IN ('Superior', 'Alto', 'Básico', 'Bajo')),  -- escala nacional
  PRIMARY KEY (id_estudiante, id_asignatura, periodo)  -- clave compuesta
);

INSERT INTO estudiantes VALUES (1, 'Laura'), (2, 'Andrés');
INSERT INTO asignaturas VALUES (10, 'Matemáticas'), (20, 'Ciencias naturales');
INSERT INTO calificaciones VALUES
  (1, 10, 1, 'Alto'),
  (1, 20, 1, 'Superior'),
  (2, 10, 1, 'Básico');
La clave primaria de calificaciones es compuesta: estudiante, asignatura y periodo. Eso impide registrar dos notas de Matemáticas para Laura en el mismo periodo.
La regla CHECK (una condición que solo acepta ciertos valores) tiene acento colombiano. Cada colegio del país define su propia escala de valoración, pero debe expresar su equivalencia con la escala nacional de cuatro niveles: desempeño superior, alto, básico y bajo [6]. La base de datos convierte esa norma en algo que el sistema hace cumplir solo: un «Excelente» escrito a mano no entra.
Los tres tipos de relaciones en una base de datos: 1:1, 1:N y N:M
Entre dos tablas hay tres tipos de relación, según cuántas filas de una corresponden a cuántas de la otra. En la de uno a uno (1:1), cada fila tiene como máximo una pareja. En la de uno a muchos (1:N), una fila se conecta con muchas. En la de muchos a muchos (N:M), hace falta una tercera tabla, llamada tabla puente.
El manual de MySQL nombra las reglas que se pueden fijar entre los datos: relaciones de uno a uno, de uno a muchos, valores únicos, obligatorios u opcionales [2]. La tabla resume cómo se construye cada relación con las dos claves que ya vimos.
| Tipo de relación | Qué significa | Cómo se construye | Ejemplo |
|---|---|---|---|
| Uno a uno (1:1) | A cada fila le corresponde como máximo una fila de la otra tabla | Una clave foránea que, además, no admite valores repetidos | Un paciente y su historia clínica |
| Uno a muchos (1:N) | Una fila de la tabla padre se conecta con muchas de la tabla hija | Una clave foránea común en la tabla hija [4] | Un cliente y sus pedidos |
| Muchos a muchos (N:M) | Muchas filas de un lado se conectan con muchas del otro | Una tabla puente con dos claves foráneas [4] | Estudiantes y asignaturas, a través de las calificaciones |
La relación de uno a muchos aparece en los cuatro ejemplos de esta página. La de uno a uno, en cambio, solo aparece en uno: si dos tablas siempre van en pareja, a veces basta con una sola.
La tabla puente: cómo se resuelve una relación de muchos a muchos
Una tabla puente es una tabla intermedia que convierte una relación de muchos a muchos en dos relaciones de uno a muchos. Cada fila guarda la clave de un lado y la clave del otro. Un estudiante cursa muchas asignaturas y cada asignatura tiene muchos estudiantes, así que la tabla de calificaciones registra cada pareja por separado.
PostgreSQL lo explica desde la regla técnica. Una tabla puede tener más de una clave foránea, y así se implementan las relaciones de muchos a muchos entre tablas [4]. Su propio ejemplo es la tabla de artículos de un pedido, que une productos con pedidos [4].
Lo interesante de una tabla puente es que casi nunca está vacía de sentido. Suele guardar el dato que solo existe cuando las dos cosas se juntan.
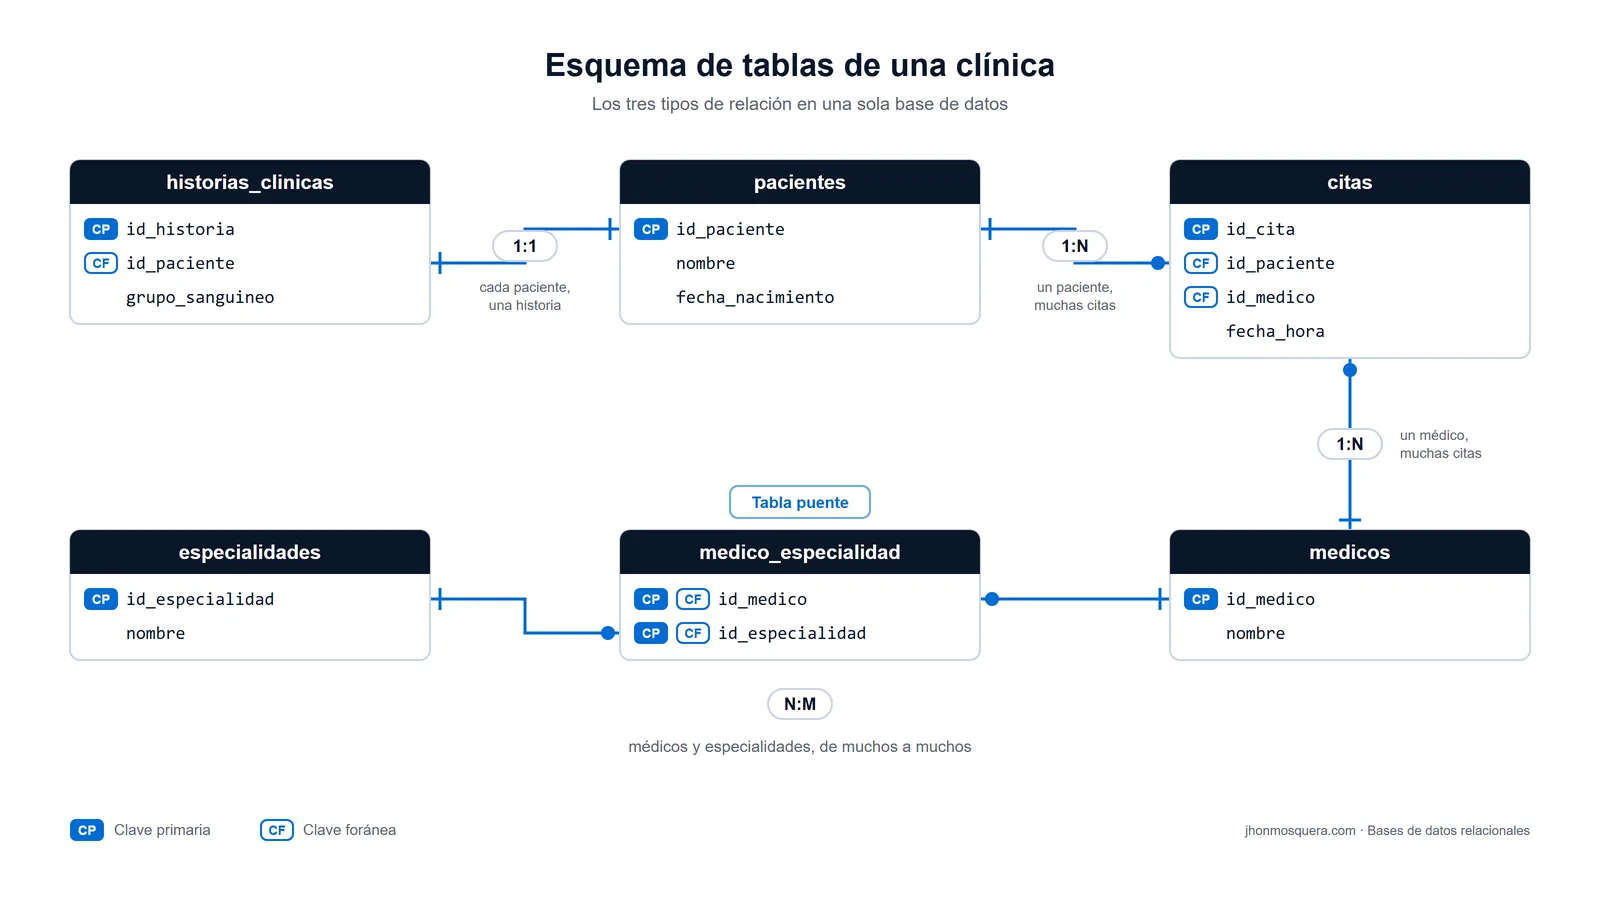
La nota no es del estudiante ni de la asignatura: es de los dos. La cantidad comprada no es del producto ni del pedido. El esquema de la clínica, que se resuelve más abajo, reúne los tres tipos de relación en una sola base.
¿Cómo funciona una consulta con JOIN? Unir tablas sin escribir código
Una consulta con JOIN (en inglés, «unir») le pide a la base de datos que junte las filas de dos o más tablas cuando coinciden en una columna. Casi siempre es la clave foránea de una con la clave primaria de otra. El resultado es una tabla nueva y temporal, que no estaba guardada en ninguna parte. Así sale el boletín sin copiar un solo nombre.
La documentación de PostgreSQL lo define en esos términos. Las consultas de unión combinan filas de una tabla con filas de otra, mediante una condición que dice qué filas forman pareja [7]. En el colegio, la condición es que el número de estudiante de la nota sea igual al número de la tabla de estudiantes.
Con los datos del ejemplo anterior, el razonamiento que sigue una unión es este:
- Toma la primera fila de calificaciones: estudiante 1, asignatura 10, periodo 1, desempeño alto.
- Busca el 1 en la tabla de estudiantes y encuentra a Laura.
- Busca el 10 en la tabla de asignaturas y encuentra Matemáticas.
- Escribe una fila en el resultado con los tres datos y repite con cada calificación.
El boletín del periodo 1 queda así:
| Estudiante | Asignatura | Desempeño |
|---|---|---|
| Laura | Matemáticas | Alto |
| Laura | Ciencias naturales | Superior |
| Andrés | Matemáticas | Básico |
Ese es el razonamiento, no necesariamente el orden en que trabaja la máquina. El gestor escoge su propio camino para llegar al mismo resultado, como explica la guía de SQL, el lenguaje con que se consultan estas bases.
Hay un matiz que cambia respuestas. La unión común solo devuelve las parejas que coinciden. Si el colegio recibe en agosto a una estudiante nueva que todavía no tiene notas, la unión común la deja por fuera del listado. Para que aparezca, hace falta una unión externa, que conserva todas las filas de la tabla principal aunque no tengan pareja [7]. En ese caso, la estudiante saldría con la nota en blanco.
La forma de escribir estas consultas, con las órdenes SELECT (seleccionar) y JOIN, queda para esa misma guía.
Integridad referencial: la regla que impide los registros huérfanos
La integridad referencial es la garantía de que toda clave foránea apunta a una fila que existe. Si una nota dice «estudiante 99» y no hay estudiante 99, la base de datos la rechaza. Y si alguien intenta borrar a un estudiante que todavía tiene notas, el gestor lo impide o aplica la regla de borrado que se haya definido.
PostgreSQL resume la función de la clave foránea con esa misma expresión: mantiene la integridad referencial entre dos tablas relacionadas [4]. Esto es lo que pasa en el colegio cuando alguien intenta romperla:
-- Continúa el ejemplo anterior (misma conexión, claves foráneas activas).

-- 1. Una nota para una estudiante que no existe: el gestor la rechaza
INSERT INTO calificaciones VALUES (99, 10, 1, 'Alto');

-- 2. Borrar a Laura mientras tiene notas: el gestor también lo rechaza
DELETE FROM estudiantes WHERE id_estudiante = 1;
Las dos órdenes terminan en un error de clave foránea, y ninguna cambia los datos. Esa es la integridad referencial funcionando.
Un detalle de SQLite explica la línea de activación del ejemplo anterior. Por compatibilidad con versiones viejas, SQLite trae las claves foráneas apagadas, y hay que activarlas en cada conexión [5]. Si se olvida esa línea, la nota de la estudiante 99 entra sin protesta.
MySQL 8.4 se comporta como PostgreSQL. Si la clave foránea no dice qué hacer al borrar o actualizar, MySQL rechaza la fila hija que apunta a un padre inexistente y también el borrado de un padre que tiene hijas [8].
La regla de borrado se puede escoger. PostgreSQL 18 ofrece cinco [4]:
| Regla al borrar la fila padre | Qué pasa con las filas hijas | Cuándo la usaría (lectura del autor) |
|---|---|---|
| NO ACTION («ninguna acción»), la que se aplica si no se dice nada | El borrado falla si quedan filas que apuntan a la borrada; la revisión se puede aplazar al final de la transacción, el grupo de cambios que se confirma completo o no se aplica [4] | Casi siempre, como punto de partida |
| RESTRICT («restringir») | Impide el borrado de inmediato, sin aplazar la revisión [4] | Datos que nunca deben quedar sin dueño, como notas o facturas |
| CASCADE («en cascada») | Borra también las filas hijas [4] | Piezas que no existen sin su dueño, como las líneas de un pedido |
| SET NULL («dejar vacío») | Deja vacía la clave foránea de las hijas [4] | Vínculos opcionales, como el profesor asignado a una tutoría |
| SET DEFAULT («poner el valor por defecto») | Pone en las hijas el valor por defecto de la columna [4] | Pocas veces; exige que ese valor exista en la tabla padre |
Ejemplos de bases de datos relacionales resueltos: tienda, colegio, clínica y biblioteca
Estos cuatro ejemplos de bases de datos relacionales están resueltos como esquemas de tablas: qué tablas hay, cuál es la clave primaria de cada una, qué claves foráneas las conectan y qué tipo de relación resulta. Son ejemplos didácticos, simplificados a propósito, para ver el modelo relacional en negocios y servicios que cualquiera reconoce.
Los sistemas reales que usted usa a diario, con el tipo de base de datos que hay detrás de cada uno, tendrán su propia guía de ejemplos de bases de datos, que está en preparación.
Ejemplo 1: la tienda (clientes, productos y pedidos)
Una tienda que vende por pedidos necesita cuatro tablas. La clave de la cuarta es doble, porque un pedido lleva muchos productos y un producto aparece en muchos pedidos.
| Tabla | Columnas | Clave primaria | Claves foráneas |
|---|---|---|---|
| clientes | id_cliente, nombre, ciudad | id_cliente | — |
| productos | id_producto, nombre, precio | id_producto | — |
| pedidos | id_pedido, id_cliente, fecha | id_pedido | id_cliente → clientes |
| detalle_pedido | id_pedido, id_producto, cantidad, precio_unitario | id_pedido + id_producto | id_pedido → pedidos · id_producto → productos |
Relaciones: un cliente tiene muchos pedidos (1:N), y pedidos y productos se unen en una relación de muchos a muchos a través de detalle_pedido.
El precio unitario repetido en el detalle no es un descuido. Es el precio del día de la venta: si el producto sube mañana, la factura de ayer no debe cambiar. Y el ejemplo de PostgreSQL para esta misma tabla usa reglas distintas en cada lado. Borrar un pedido borra sus líneas, pero un producto que aparece en algún pedido no se puede borrar [4].
Ejemplo 2: el colegio (estudiantes, asignaturas y calificaciones)
Es el esquema del código de arriba, con la escala nacional de desempeños como regla de la columna de notas [6].
| Tabla | Columnas | Clave primaria | Claves foráneas |
|---|---|---|---|
| estudiantes | id_estudiante, nombre | id_estudiante | — |
| asignaturas | id_asignatura, nombre | id_asignatura | — |
| calificaciones | id_estudiante, id_asignatura, periodo, desempeno | id_estudiante + id_asignatura + periodo | id_estudiante → estudiantes · id_asignatura → asignaturas |
Relaciones: estudiantes y asignaturas, de muchos a muchos, a través de calificaciones.
Si el colegio quiere guardar a los acudientes, aparece otra relación de muchos a muchos. Un estudiante puede tener dos acudientes, y una misma madre puede responder por tres hermanos. La solución es otra tabla puente, no una columna «acudiente 1, acudiente 2».
Ejemplo 3: la clínica (pacientes, médicos y citas)
La clínica es el ejemplo más completo, porque reúne los tres tipos de relación en una sola base.
| Tabla | Columnas | Clave primaria | Claves foráneas |
|---|---|---|---|
| pacientes | id_paciente, nombre, fecha_nacimiento | id_paciente | — |
| historias_clinicas | id_historia, id_paciente, grupo_sanguineo | id_historia | id_paciente → pacientes, sin repetirse |
| medicos | id_medico, nombre | id_medico | — |
| especialidades | id_especialidad, nombre | id_especialidad | — |
| medico_especialidad | id_medico, id_especialidad | id_medico + id_especialidad | id_medico → medicos · id_especialidad → especialidades |
| citas | id_cita, id_paciente, id_medico, fecha_hora | id_cita | id_paciente → pacientes · id_medico → medicos |
Relaciones: cada paciente tiene una historia clínica (1:1); un paciente tiene muchas citas y un médico atiende muchas citas (1:N); médicos y especialidades se unen en una relación de muchos a muchos.
Las citas también son, en el fondo, un puente entre pacientes y médicos. La diferencia con medico_especialidad está en la clave. Un mismo paciente puede ver al mismo médico diez veces, así que la pareja paciente-médico se repite y cada cita necesita su propio número.
Ejemplo 4: la biblioteca (libros, ejemplares, socios y préstamos)
La biblioteca enseña una distinción que muchos esquemas de práctica pasan por alto: el libro como obra y el ejemplar como objeto físico.
| Tabla | Columnas | Clave primaria | Claves foráneas |
|---|---|---|---|
| libros | id_libro, título | id_libro | — |
| autores | id_autor, nombre | id_autor | — |
| libro_autor | id_libro, id_autor | id_libro + id_autor | id_libro → libros · id_autor → autores |
| ejemplares | id_ejemplar, id_libro, estado | id_ejemplar | id_libro → libros |
| socios | id_socio, nombre | id_socio | — |
| prestamos | id_prestamo, id_ejemplar, id_socio, fecha_prestamo, fecha_devolucion | id_prestamo | id_ejemplar → ejemplares · id_socio → socios |
Relaciones: libros y autores, de muchos a muchos; un libro tiene muchos ejemplares; un socio tiene muchos préstamos.
El préstamo apunta al ejemplar, no al libro, porque lo que sale por la puerta es una copia concreta. Y la fecha de devolución queda vacía mientras el ejemplar está afuera. Con esa sola columna, la biblioteca sabe qué copias le deben.
Ventajas de las bases de datos relacionales
La principal ventaja de una base de datos relacional es que las reglas viven en la base y no en la memoria de las personas: cada dato se guarda una vez y el gestor rechaza lo que no cuadra. A eso se suman consultas que cruzan tablas de formas que nadie previó al diseñarlas, un lenguaje estándar para hablarles y motores libres de buen nivel.
La primera ventaja ya la vimos en acción. La regla de la escala nacional y la integridad referencial no dependen de que Marcela se acuerde de revisarlas.
La segunda es menos visible. Las tablas del colegio se diseñaron para sacar boletines, pero también responden preguntas que nadie planeó, como qué estudiantes bajaron de alto a básico entre dos periodos. Esa era la promesa del diseño de Codd: pedir datos sin conocer cómo están guardados y armar tablas nuevas con una sola consulta [3].
La tercera es el idioma. Las bases relacionales se consultan con SQL, que es norma internacional. Su parte central la publica la ISO (Organización Internacional de Normalización), y va en su sexta edición, de junio de 2023 [9]. Lo que se aprende en un gestor sirve, con matices, en otro.
La cuarta pesa más en Colombia que en un manual. SQLite es de dominio público: cualquiera puede copiarlo, usarlo y distribuirlo, con fines comerciales o no [10]. La licencia de PostgreSQL permite usarlo, copiarlo, modificarlo y distribuirlo para cualquier propósito y sin pagar [11]. Para un colegio público o una pyme, la barrera no es la licencia. Es el diseño de las tablas.
Límites de las bases de datos relacionales: esquema rígido y escalado vertical
Las bases de datos relacionales tienen dos límites reales. El primero es el esquema rígido: el plano de tablas, columnas y tipos de dato se define antes de guardar información, y cambiarlo en una tabla grande cuesta tiempo y bloqueos. El segundo es que suelen crecer en vertical, con una máquina más potente, y repartirlas entre muchos servidores encarece justo lo que las hace valiosas.
Empiece por el esquema. En PostgreSQL 18, cambiar el tipo de dato de una columna existente suele obligar a reescribir la tabla entera y sus índices [12]. Un índice es una estructura auxiliar que acelera las búsquedas, como el índice de un libro.
Además, la orden que modifica tablas toma por defecto el bloqueo más estricto, llamado ACCESS EXCLUSIVE (acceso exclusivo) [12]. Ese bloqueo garantiza que nadie más toque la tabla de ninguna forma mientras dura [13]. Ni lecturas ni escrituras. En una tabla grande, cambiar el tipo de una columna puede exigir una ventana de mantenimiento; no es un clic.
No todo cambio exige reescribir, y la documentación detalla las excepciones [12]. Pero la lección para quien diseña es clara: pensar bien las columnas al principio es más barato que corregirlas después.
El segundo límite es el tamaño. La guía de arquitectura de Microsoft Architecting Cloud Native .NET Applications for Azure (2022) lo dice sin rodeos sobre las bases relacionales: «por lo general se instalan en un solo servidor y escalan en vertical, añadiendo más recursos a la máquina» [14]. Escalar en vertical es comprar una máquina más grande; escalar en horizontal, sumar máquinas.
Repartir una base relacional entre varios servidores se puede hacer. El costo, según la misma guía, está en lo más valioso del modelo. Las uniones entre tablas, las transacciones y la integridad referencial sufren fuertes castigos de rendimiento cuando los datos quedan partidos entre máquinas [14]. Muchos gestores relacionales ofrecen otra salida: copias de la base que atienden solo lecturas, mientras todas las escrituras van a la principal [14].
Cuando el volumen supera lo que cabe en una máquina, el problema entra en otro terreno, el del big data.
¿Cuándo no usar una base de datos relacional?
No conviene una base de datos relacional cuando la forma de los datos cambia todo el tiempo, cuando el volumen exige millones de operaciones por segundo con respuesta predecible o cuando los datos deben replicarse entre regiones con control fino. Tampoco cuando el problema cabe en una lista que usa una sola persona.
La guía de Microsoft trae una lista de criterios para escoger [14]. Los casos en que apunta lejos de una relacional son estos:
- Datos que cambian de forma con frecuencia. La guía habla de datos dinámicos, que cambian a menudo [14]. Un ejemplo sería un catálogo donde cada categoría trae atributos distintos y obliga a alterar el esquema una y otra vez.
- Volúmenes enormes con respuesta predecible. Como regla general, la guía ubica a las relacionales en cargas de miles de transacciones por segundo, y a las alternativas en millones, con respuestas de milisegundos [14].
- Datos repartidos por el mundo. Cuando las copias viven en varias regiones y se necesita decidir con detalle entre consistencia, disponibilidad y velocidad [14].
- Consultas simples sin uniones. Si casi todo se resuelve recuperando un dato sin cruzar tablas, la ventaja relacional pesa poco [14].
Hay un quinto caso, más pequeño, que agrego yo: la lista de una sola persona. Para los cumpleaños del equipo o el inventario de una papelería de barrio, una hoja de cálculo bien armada alcanza; la guía de Excel explica cómo trabajar con ella.
Las alternativas a las tablas, como documentos, pares clave-valor o grafos, son tema de la guía de bases de datos NoSQL. La comparación punto por punto irá en SQL vs NoSQL, y la elección de un producto concreto, en la guía de gestores de bases de datos. Las tres están en preparación.
Mi regla como practicante: si sus datos tienen dueños, fechas y montos que deben cuadrar, empiece con una relacional y deje que la realidad le demuestre que no le sirve. En una organización mediana, creo que rara vez pasa.
¿Qué cambia cuando cada dato vive en un solo lugar?
Cuando cada dato vive en un solo lugar, los errores dejan de multiplicarse. Una corrección se hace una vez y aparece en todos los reportes, y una nota mal asignada choca contra una regla antes de llegar al boletín. El trabajo deja de ser cuadrar copias y pasa a ser diseñar bien las tablas.
Marcela no necesitaba un sistema costoso. Creo que tres tablas, una regla con la escala nacional y un motor libre en el computador de la secretaría le habrían ahorrado el boletín equivocado.
Y ese boletín no era un detalle administrativo. En un colegio público, una nota que cae en el estudiante equivocado puede decidir quién repite el año o quién recibe una beca. Sospecho que los colegios con menos personal de sistemas son los que más dependen de copiar a mano, y por eso serían los que más ganan con una base que se protege sola.
La pregunta para Marcela, y para usted, es cuántas veces está escrito hoy cada uno de sus datos, y cuál de esas copias manda.
Preguntas frecuentes
¿MySQL, PostgreSQL y SQLite son bases de datos relacionales? En sentido estricto son gestores: los programas que administran bases de datos relacionales. PostgreSQL se define como un RDBMS [1], el manual de MySQL dice que sus bases de datos son relacionales [2] y SQLite hace cumplir claves foráneas entre tablas padre e hija [5]. En qué se diferencian como productos y cuál conviene en cada caso será tema de la guía de gestores de bases de datos, en preparación.
¿Una tabla puede tener dos claves primarias? No. Cada tabla admite como máximo una clave primaria [4]. Lo que sí se puede es una clave primaria compuesta, que abarca varias columnas a la vez [4], como la de estudiante, asignatura y periodo del ejemplo del colegio. Si otra columna también debe ser única, como un número de documento, se le pone una regla de valores únicos sin convertirla en clave primaria; una clave foránea puede apuntar a esa columna igual que a la primaria [4].
¿En qué orden guarda las filas una base de datos relacional? En ninguno que se pueda dar por hecho. La documentación de PostgreSQL advierte que SQL no garantiza de ninguna manera el orden de las filas dentro de una tabla, aunque se pueden ordenar al mostrarlas [1]. Si un reporte necesita un orden, la consulta lo tiene que pedir; confiar en que «siempre salen así» es una fuente clásica de errores.
¿Se puede guardar JSON en una base de datos relacional? Sí. JSON es un formato de texto para datos con estructura flexible. PostgreSQL 18 tiene dos tipos de columna para guardarlo, json y jsonb, y revisa que cada valor cumpla las reglas del formato [15]. A mi juicio, sirve para los atributos que varían de un registro a otro; usarlo para todo es renunciar a las reglas que hacen valiosa a la base.
¿Qué diferencia hay entre una base de datos relacional y SQL? La base de datos es el depósito organizado en tablas; SQL es el lenguaje con que se le piden y se le cambian los datos. El manual de MySQL lo describe como el lenguaje estandarizado más común para acceder a bases de datos [2]. Cómo funciona y cómo se escribe está en la guía de SQL.
Referencias
Las citas en otro idioma son traducción propia.
- The PostgreSQL Global Development Group. PostgreSQL 18 Documentation (versión 18.6), sección 2.2 «Concepts» — PostgreSQL es un sistema de gestión de bases de datos relacionales (RDBMS) que administra datos guardados en relaciones; relación es en esencia el término matemático para tabla; cada tabla es una colección de filas con nombre, todas con las mismas columnas y cada columna de un tipo de dato; SQL no garantiza el orden de las filas dentro de la tabla, aunque se pueden ordenar para mostrarlas. PostgreSQL: Documentation 18, Concepts — Consultada: 2026-10-18.
- Oracle. MySQL 8.4 Reference Manual, sección 1.2.1 «What is MySQL?» — «MySQL databases are relational»: una base relacional guarda los datos en tablas separadas en lugar de ponerlos todos en un gran depósito; se fijan reglas sobre las relaciones entre campos, como uno a uno, uno a muchos, únicos, obligatorios u opcionales; SQL es el lenguaje estandarizado más común para acceder a bases de datos. MySQL: Reference Manual 8.4, What is MySQL? — Consultada: 2026-10-18.
- IBM. The relational database (página de historia de la empresa) — Edgar F. Codd, investigador de IBM, y su artículo de 1970 «A Relational Model of Data for Large Shared Data Banks»; la propuesta de organizar la información en tablas enlazables por características comunes; el diseño permitía obtener información sin conocer la organización física de la base y armar una tabla nueva a partir de otras con una sola consulta. IBM: The relational database — Consultada: 2026-10-18.
- The PostgreSQL Global Development Group. PostgreSQL 18 Documentation (versión 18.6), sección 5.5 «Constraints», apartados 5.5.4 «Primary Keys» y 5.5.5 «Foreign Keys» — la clave primaria exige valores únicos y no nulos; una tabla puede tener como máximo una clave primaria, que puede abarcar varias columnas; la clave foránea exige que sus valores coincidan con los de alguna fila de otra tabla y mantiene la integridad referencial entre dos tablas relacionadas; debe referenciar una clave primaria o columnas con restricción de unicidad; una tabla con más de una clave foránea implementa relaciones de muchos a muchos (ejemplo de la tabla order_items, con RESTRICT hacia productos y CASCADE hacia pedidos); acciones al borrar: NO ACTION (por defecto, revisión aplazable), RESTRICT, CASCADE, SET NULL y SET DEFAULT. PostgreSQL: Documentation 18, Constraints — Consultada: 2026-10-18.
- SQLite. SQLite Foreign Key Support (página actualizada el 20 de marzo de 2026) — la tabla padre es la que recibe la referencia de la clave foránea y la tabla hija es la que la contiene; las restricciones de clave foránea vienen desactivadas por defecto, por compatibilidad con versiones anteriores, y deben activarse en cada conexión con PRAGMA foreign_keys. SQLite: Foreign Key Support — Consultada: 2026-10-18.
- Presidencia de la República de Colombia y Ministerio de Educación Nacional. Decreto 1075 de 2015, Decreto Único Reglamentario del Sector Educación — art. 2.3.3.3.3.5, «Escala de valoración nacional» (compila el art. 5 del Decreto 1290 de 2009): cada establecimiento define su escala de valoración y debe expresar su equivalencia con la escala nacional de desempeño superior, alto, básico y bajo. Función Pública: Decreto 1075 de 2015 — Consultada: 2026-10-18.
- The PostgreSQL Global Development Group. PostgreSQL 18 Documentation (versión 18.6), sección 2.6 «Joins Between Tables» — las consultas que acceden a varias tablas a la vez se llaman consultas de unión (join) y combinan filas de una tabla con filas de otra mediante una expresión que indica qué filas forman pareja; la unión externa izquierda conserva al menos una vez cada fila de la tabla de la izquierda. PostgreSQL: Documentation 18, Joins Between Tables — Consultada: 2026-10-18.
- Oracle. MySQL 8.4 Reference Manual, sección 5.6.6 «Using Foreign Keys» — ejemplo de tablas padre e hija con InnoDB; sin cláusulas ON UPDATE ni ON DELETE, MySQL rechaza insertar una fila hija cuyo padre no existe y borrar una fila padre que tiene filas hijas; con ON DELETE CASCADE, borrar el padre borra las hijas. MySQL: Reference Manual 8.4, Using Foreign Keys — Consultada: 2026-10-18.
- Organización Internacional de Normalización (ISO). ISO/IEC 9075-2:2023 Information technology — Database languages SQL — Part 2: Foundation (SQL/Foundation) (ficha del catálogo) — edición 6, publicada en junio de 2023, 1.715 páginas; estado: norma por revisar (etapa 90.92, desde el 22 de junio de 2025). ISO: ficha de ISO/IEC 9075-2:2023 — Consultada: 2026-10-18.
- SQLite. SQLite Copyright — el código y la documentación de SQLite están dedicados al dominio público; cualquiera puede copiar, modificar, publicar, usar, compilar, vender o distribuir el código original, para cualquier fin, comercial o no. SQLite: SQLite Is Public Domain — Consultada: 2026-10-18.
- The PostgreSQL Global Development Group. PostgreSQL Licence — permiso para usar, copiar, modificar y distribuir el software y su documentación para cualquier propósito, sin pago y sin acuerdo escrito. PostgreSQL: Licence — Consultada: 2026-10-18.
- The PostgreSQL Global Development Group. PostgreSQL 18 Documentation (versión 18.6), referencia de la orden ALTER TABLE — se adquiere un bloqueo ACCESS EXCLUSIVE salvo que se indique otra cosa; cambiar el tipo de una columna existente normalmente obliga a reescribir la tabla entera y sus índices, con excepciones que la página detalla. PostgreSQL: Documentation 18, ALTER TABLE — Consultada: 2026-10-18.
- The PostgreSQL Global Development Group. PostgreSQL 18 Documentation (versión 18.6), sección 13.3 «Explicit Locking» — el modo ACCESS EXCLUSIVE entra en conflicto con todos los demás modos y garantiza que quien lo tiene es la única transacción que accede a la tabla, de cualquier forma. PostgreSQL: Documentation 18, Explicit Locking — Consultada: 2026-10-18.
- Microsoft. Relational vs. NoSQL data, capítulo del libro Architecting Cloud Native .NET Applications for Azure (fecha de la página: 6 de abril de 2022) — sobre las bases relacionales: «They’re typically provisioned to a single server and scale vertically by adding more resources to the machine»; réplicas secundarias para distribuir lecturas mientras las escrituras van a la primaria; las uniones, las transacciones y la integridad referencial sufren fuertes penalizaciones de rendimiento cuando los datos se reparten entre nodos; tabla de criterios para escoger entre una base relacional (cargas de miles de transacciones por segundo, datos muy estructurados con integridad referencial, consultas y reportes complejos) y una NoSQL (millones de transacciones por segundo con latencia de milisegundos, datos dinámicos, recuperación simple sin uniones, réplicas entre geografías). Microsoft Learn: Relational vs. NoSQL data — Consultada: 2026-10-18.
- The PostgreSQL Global Development Group. PostgreSQL 18 Documentation (versión 18.6), sección 8.14 «JSON Types» — los tipos json y jsonb guardan datos JSON y obligan a que cada valor sea válido según las reglas del formato. PostgreSQL: Documentation 18, JSON Types — Consultada: 2026-10-18.
Cómo investigamos esta página
- Pregunta que responde: Qué es una base de datos relacional, cómo se conectan sus tablas y cuándo conviene usarla o no.
- Fuentes: identificadas 22 → incluidas 15
- Criterios de inclusión: documentación oficial de PostgreSQL 18, MySQL 8.4 y SQLite, la norma ISO de SQL, la historia de IBM, una guía de Microsoft y el Decreto 1075 de 2015; nada de enciclopedias ni blogs de cursos.
- Fecha de corte de los datos: 2026-10-18