Historia de las bases de datos: seis décadas en una línea de tiempo
La historia de las bases de datos empieza en los años sesenta, cuando las empresas dejaron las cintas magnéticas por programas que guardaban en disco datos compartidos. Cada generación resolvió un problema de la anterior: árboles rígidos, rutas difíciles de programar, falta de escala o búsqueda por significado. Las tablas relacionales, de 1970, siguen en el centro.
Última actualización: 2026-10-19
Contenido de esta página
- Historia y evolución de las bases de datos, en pocas palabras
- Línea del tiempo de las bases de datos: el problema que resolvió cada generación
- Origen y antecedentes de las bases de datos: de la cinta al disco
- Las primeras bases de datos: IDS, IMS y el programa Apollo
- 1970: Codd y la idea de las tablas
- SQL se vuelve norma: 1986 en Estados Unidos y 1987 en el mundo
- Los noventa: objetos, almacenes de datos y software libre
- Evolución de las bases de datos en el siglo XXI: NoSQL, Hadoop, NewSQL y la nube
- Las bases de datos vectoriales y la inteligencia artificial
- ¿Qué país lideró la creación de las bases de datos?
- ¿Por qué siguen vivas las bases de datos más viejas?
Historia real. El 14 de agosto de 1968, en la división espacial de Rockwell en Downey, California, un programa de IBM, la empresa estadounidense de computadores, mostró su primer mensaje: «READY», es decir, «listo» [1]. La empresa que lo había pedido era la contratista principal de la nave Apollo. El programa llevaba la cuenta de los materiales de millones de piezas y de cada cambio de ingeniería que se les hacía [1].
Mientras tanto, en Colombia, el Banco de la República, el banco central del país, ya procesaba parte de su contabilidad y de la compensación de cheques en un computador arrendado a IBM. Lo hacía desde 1964, según su memoria institucional [2].
Las dos escenas comparten un punto de partida: más registros de los que una oficina podía llevar a mano, y una máquina nueva que prometía ordenarlos.
El programa de la Apollo se convirtió en IMS, sigla en inglés de sistema de gestión de información, uno de los primeros gestores de bases de datos [13]. Un gestor es el programa que guarda los datos, los protege y se los entrega a quien los pide. La historia de las bases de datos es la historia de esos programas. Cada generación nació para arreglar lo que la anterior dejó sin resolver.
Historia y evolución de las bases de datos, en pocas palabras
Las bases de datos nacieron en los años sesenta. Las empresas pasaron de guardar datos en cintas, que se leen de principio a fin, a discos que saltan a cualquier registro. Primero vinieron los modelos de árbol y de red. En 1970 llegó la idea de las tablas. Después aparecieron las alternativas para la web, la nube y la inteligencia artificial. De 1963, cuando el primer gestor ya funcionaba, a hoy van 63 años [5].
El orden importa porque explica el presente. Los sistemas viejos no desaparecieron cuando llegó uno nuevo. IMS sigue funcionando en grandes bancos y aseguradoras [1]. Y las tablas de 1970 terminaron absorbiendo varias de las ideas que nacieron para reemplazarlas, según el análisis que Michael Stonebraker y Andrew Pavlo publicaron en 2024 [14].
La tabla que sigue es la línea del tiempo completa. Las secciones de abajo cuentan cada etapa con sus nombres propios.
Línea del tiempo de las bases de datos: el problema que resolvió cada generación
Una línea del tiempo de las bases de datos se entiende mejor por problemas que por fechas. Cada fila de la tabla dice qué no funcionaba en esa década, qué respuesta técnica apareció y qué queda de ella hoy. La última columna solo afirma lo que una fuente documenta.
| Década | Problema | Respuesta técnica | Superviviente hoy |
|---|---|---|---|
| 1950-1960 | Los datos estaban en cintas magnéticas y en tarjetas; encontrar un dato podía exigir un programa completo [4] [3] | El disco de acceso aleatorio de IBM, el RAMAC, presentado tras cuatro años de trabajo iniciados en 1952 [3] | El disco duro: IBM llama al RAMAC el antecesor de todos los discos duros [3] |
| 1960 | Empresas y gobiernos armaban sus propias herramientas de datos, cada una a su manera [1] | IDS, de General Electric, que ya funcionaba en 1963, e IMS, de IBM, en 1968 [5] [1] | IMS: a finales de la década de 2010 lo usaban 7 de las 10 mayores empresas financieras [1] |
| Finales de 1960 | Hacía falta un estándar para el modelo de red | Primer informe del comité CODASYL, de octubre de 1969 [6] | La plantilla del gestor moderno y las reglas de integridad entre tablas [5] |
| 1970 | Cada búsqueda había que programarla a mano, y si los datos cambiaban, a menudo había que reescribir las consultas [1] | El modelo relacional de Codd, de 1970; System R, de 1973, e INGRES, con prototipo en 1974 [7] [4] [9] | El modelo relacional sigue siendo el dominante [14] |
| 1980 | La norma de 1986 declara como propósito llevar las definiciones y los programas de un motor a otro [10] | SQL como norma de Estados Unidos en 1986 e internacional en 1987 [10] [11] | SQL, cuya versión de 2023 sigue sumando funciones [14] |
| 1990 | Los programas orientados a objetos chocaban con las tablas [13], y las empresas querían analizar sus históricos de ventas [14] | Bases objeto-relacionales y almacenes de datos para análisis [14] | Los tipos de datos extensibles dentro de los motores relacionales [14] |
| 1990 (la web) | Llevar el gestor relacional a proyectos de código abierto [13] | MySQL, en 1995, y PostgreSQL, que nace de Postgres en 1994 y toma ese nombre en 1996 [13] [12] | Los dos siguen activos: PostgreSQL va en su versión 18 [12] y Meta opera una enorme flota de bases MySQL [14] |
| 2000 | Un gran número de usuarios simultáneos, y una sola máquina ya no alcanzaba [13] | NoSQL: BigTable, de Google, y Dynamo, que Amazon creó en 2007; Hadoop, en 2005 [13] [14] | MongoDB, el más popular de su tipo; de Hadoop quedan sobre todo sus clústeres de archivos [14] |
| 2010 | NoSQL renunciaba a las transacciones completas que pedían bancos y comercios [13] | NewSQL a comienzos de la década; gestores rediseñados para la nube [14] [13] | Bases SQL distribuidas como CockroachDB, TiDB y YugabyteDB [14] |
| 2020 | Buscar por parecido de significado, no por coincidencia exacta | Bases vectoriales; en 2023, varios motores relacionales añaden índices vectoriales [14] | Pinecone, Milvus y Weaviate, más los índices vectoriales de los motores relacionales [14] |
Dos advertencias para leer la tabla. Las décadas son aproximadas, porque una generación no empieza el 1 de enero. Y «superviviente» no significa que sea lo más usado, sino que sigue en operación o que su idea pasó a los sistemas de hoy.
Origen y antecedentes de las bases de datos: de la cinta al disco
El origen de las bases de datos está en los años cincuenta, con las cintas magnéticas y las tarjetas perforadas. En una cinta, los datos se leen en orden, como una canción en un casete. Para llegar al registro del cliente número diez mil había que pasar por los anteriores. Así, consultar un solo dato costaba tiempo y trabajo de especialistas.
IBM lo describe con un costo concreto. En los sesenta, los mainframes (computadores centrales del tamaño de un cuarto) costaban cientos de dólares por minuto de uso, en buena parte por lo complejo que era manejar los datos [4]. Y los especialistas solían escribir programas completos para sacar un solo dato [4].
El cambio de fondo vino del disco. El RAMAC, un computador de IBM, fue el primero con un disco de acceso aleatorio, es decir, que salta directo al dato sin recorrer los anteriores [3]. Guardaba unos 5 megabytes y ocupaba lo que dos neveras de cocina [3]. Era poco, pero bastaba para pedir un dato y tenerlo en segundos.
Con el disco, compartir los mismos datos entre varios programas se volvió posible. Faltaba el programa que pusiera orden.
Las primeras bases de datos: IDS, IMS y el programa Apollo
Las primeras bases de datos fueron IDS (almacén integrado de datos, por su nombre en inglés), creada por Charles Bachman en General Electric, e IMS, de IBM. IDS ya funcionaba en 1963 y guardaba un solo juego de archivos compartidos en disco, que los programas consultaban por medio de él [5]. La Asociación de Maquinaria Computacional (ACM), la sociedad científica de la informática, lo presenta como el primer sistema gestor de bases de datos [5].
Ese rótulo tiene matices. El perfil de Michael Stonebraker en la misma ACM habla de lo que «a menudo se llama» el primer gestor [9]. Lo seguro es que la idea quedó instalada en esa década: un programa aparte cuida los datos y los demás le piden lo que necesitan.
IMS tiene una historia más larga. IBM empezó a trabajar en él en 1963, con Rockwell, por un pedido urgente del programa espacial [1]. La primera versión salió en 1967 y el sistema se entregó a la NASA, la agencia espacial de Estados Unidos, un año después [1]. En el equipo también hubo gente de Caterpillar, que suministraba los generadores diésel de las estaciones de transmisión de la misión [1].
IMS organizaba los datos como un árbol: cada registro cuelga de uno superior, como las carpetas de un computador [1]. Era muy eficiente cuando se sabía de antemano dónde buscar. El problema aparecía cuando la pregunta cambiaba. IBM reconoce que había que programar cada búsqueda a mano, y que si los datos cambiaban, las consultas a menudo tenían que reescribirse [1].
CODASYL y el modelo de red (1969)
CODASYL fue la asociación del sector informático que creó el COBOL, un lenguaje de programación pensado para negocios [5]. En octubre de 1969, su comité publicó el primer informe sobre el modelo de red [6]. En ese modelo, un registro puede tener varios registros superiores, no uno solo como en IMS [6].
El diseño de IDS fue la influencia principal del grupo de CODASYL que estudió las bases de datos [5]. En 1973, Bachman recibió el Premio Turing que entrega la ACM [5].
Stonebraker y Joseph Hellerstein, en su repaso de 2005, juzgaron que la propuesta de CODASYL fracasó por su complejidad [6]. Pero algo quedó. La ACM señala que los gestores relacionales de hoy siguen la plantilla de CODASYL: un programa complejo que guarda los datos, controla el acceso y ofrece consultas a programas y personas [5].
1970: Codd y la idea de las tablas
En junio de 1970, Edgar F. Codd, matemático de IBM en San José, California, publicó el artículo que propuso organizar los datos en tablas relacionadas [7] [4]. Su meta era que nadie tuviera que conocer la ruta física de los datos para consultarlos. Con una sola consulta se podía armar una tabla nueva a partir de otras [4].
Donald Chamberlin creó con Raymond Boyce el lenguaje SQL, con el que se le piden datos a una base. Así resumió el cambio: «la idea básica de Ted era que las relaciones entre los datos se basaran en sus valores, no en enlaces o anidamientos definidos por separado» [4]. Es decir, un pedido se une con su cliente porque comparten un número, no porque alguien dibujó una flecha de uno a otro.
La idea tuvo que demostrar que funcionaba. En 1973, un equipo de IBM emprendió System R, una implementación a escala industrial [4]. En la Universidad de California en Berkeley, Stonebraker y Eugene Wong construyeron INGRES (sistema interactivo de gráficos y recuperación), que tenía un prototipo funcionando en 1974 [9].
En 1974 hubo, además, un debate público entre Bachman y Codd en un taller de la ACM [5]. Terminó sin ganador, quizá porque todavía no se había construido un sistema relacional práctico [5].
IBM, de hecho, tardó en vender productos relacionales. La biografía de Codd en la ACM sugiere que la empresa quería proteger los ingresos de IMS [8]. Mientras tanto, Relational Software, hoy Oracle, y la empresa que comercializó INGRES llegaron antes al mercado [8].
Cómo funcionan esas tablas y sus claves lo explica la guía de bases de datos relacionales.
SQL se vuelve norma: 1986 en Estados Unidos y 1987 en el mundo
En los ochenta, el lenguaje de consulta de IBM se convirtió en norma. El ANSI, el instituto que coordina las normas técnicas de Estados Unidos, aprobó la norma de SQL el 16 de octubre de 1986 [10]. La ISO, la Organización Internacional de Normalización, publicó su primera edición en junio de 1987 [11].
Conviene no confundir las dos fechas. La de 1986 es estadounidense; la de 1987, internacional. Cómo nació el lenguaje y cómo ha cambiado su norma hasta hoy lo cuenta la guía de SQL.
Los noventa: objetos, almacenes de datos y software libre
En los noventa, las bases de datos tuvieron que guardar cosas que no cabían bien en columnas de números y textos. Las bases orientadas a objetos y las objeto-relacionales intentaron resolverlo entre finales de los ochenta y comienzos de los noventa [14]. La segunda opción ganó: un modelo relacional con tipos de datos que el usuario puede ampliar [14].
En Berkeley, el proyecto Postgres, dirigido por Stonebraker, empezó a implementarse en 1986 con esa idea [12]. Sumaba reglas entre tablas y tipos de datos complejos llamados «objeto-relacionales» [9].
A mediados de los noventa llegó otra necesidad. Las empresas empezaron a acumular sus históricos de ventas para analizarlos, según Stonebraker y Pavlo [14]. Así nacieron los almacenes de datos y las consultas OLAP, sigla en inglés de procesamiento analítico en línea, que resumen años de registros en una sola respuesta. Los autores cuentan que los comercios con tiendas físicas solían recuperar la inversión en seis meses, por mejores pedidos de inventario [14]. Ese terreno es hoy parte de la ingeniería de datos.
Y llegó el software libre. MySQL empezó en Suecia en 1995 [13]. En 1994, dos estudiantes de Berkeley añadieron SQL al viejo Postgres y lo publicaron como Postgres95 [12]. En 1996 tomó el nombre de PostgreSQL [12].
Evolución de las bases de datos en el siglo XXI: NoSQL, Hadoop, NewSQL y la nube
La evolución de las bases de datos en este siglo la empujó la escala. Las aplicaciones de internet tenían que atender a muchísimos usuarios a la vez y no podían apagarse nunca [13]. Comprar una máquina más grande ayudaba cada vez menos [13]. Por eso varias empresas construyeron sistemas que reparten los datos entre muchas máquinas baratas [13].
De ahí salió el movimiento NoSQL, a mediados y finales de los años 2000 [13]. NoSQL agrupa bases que no usan tablas relacionales y aflojan las garantías de las transacciones a cambio de crecer. Sus dos primeros referentes fueron BigTable, de Google, y Dynamo, que Amazon creó en 2007 [13] [14].
En paralelo, Yahoo! desarrolló en 2005 Hadoop, una versión abierta del sistema de Google para procesar datos repartidos [14]. Su historia pertenece al big data. Stonebraker y Pavlo la cierran con una opinión dura: Hadoop «murió hace unos diez años», escribieron en 2024, es decir, hacia 2014, y dejó clústeres de archivos en las empresas [14].
NoSQL dejó un hueco. Bancos y comercios no podían renunciar a las transacciones completas, las operaciones de todo o nada [13]. Para ellos llegaron, a comienzos de los años 2010, los sistemas NewSQL, que reparten los datos como NoSQL pero conservan SQL y las transacciones [14]. El término lo usó por primera vez Matthew Aslett en un informe de 2011 [13].
Al mismo tiempo, la nube, es decir, el alquiler de servidores ajenos por uso, obligó a rediseñar los gestores desde finales de los 2000 [14]. Hoy un proveedor puede sumar capacidad de cálculo sobre la marcha, sin reacomodar los datos [14].
Las bases de datos vectoriales y la inteligencia artificial
Las bases de datos vectoriales son la generación de los años 2020. Guardan cada texto o imagen como una lista larga de números, llamada vector, que representa su significado. Luego buscan los registros cuyo vector se parece más al de la pregunta [14]. Sirven, por ejemplo, para encontrar documentos que hablan de lo mismo con otras palabras.
Esos vectores los producen herramientas de inteligencia artificial, el terreno del aprendizaje automático. Según Stonebraker y Pavlo, son hoy la categoría que más atrae a programadores e inversionistas, con Pinecone, Milvus y Weaviate al frente [14].
La reacción de los motores relacionales fue rápida. ChatGPT popularizó los grandes modelos de lenguaje a finales de 2022, y en 2023 varios de esos motores añadieron índices vectoriales [14]. Con JSON, un formato de texto para documentos que NoSQL popularizó, la misma adopción les había tomado varios años [14].
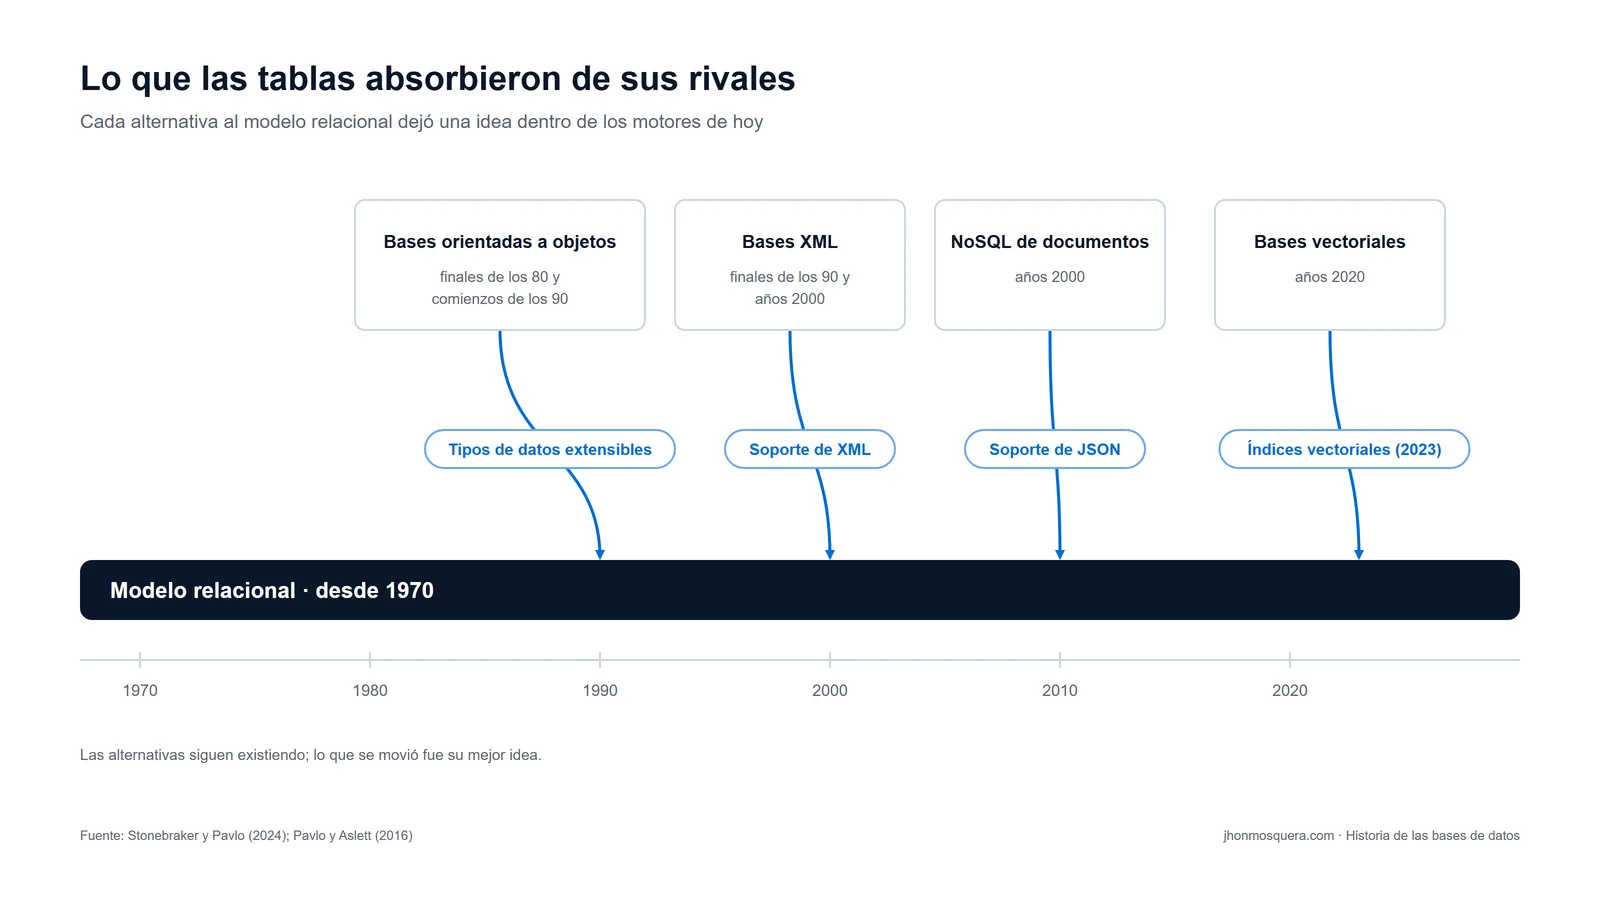
El esquema muestra el patrón que esos autores ven en toda la historia. Una alternativa nace para reemplazar a las tablas, gana entusiasmo y, al final, su mejor idea termina dentro de los motores relacionales [14] [13]. Pasó con los objetos, con el XML (otro formato de texto con etiquetas), con los documentos JSON y ahora con los vectores.
¿Qué país lideró la creación de las bases de datos?
Estados Unidos. Los hitos fundadores ocurrieron en empresas y universidades de ese país: IDS en General Electric [5], IMS en IBM con Rockwell [1], el modelo relacional en el laboratorio de IBM en San José [4] e INGRES en Berkeley [9]. La norma de SQL también fue primero estadounidense, en 1986, antes de ser internacional [10] [11].
Hay matices que vale la pena conocer. Codd nació en Inglaterra, estudió matemáticas en Oxford y emigró a Estados Unidos poco después de graduarse en 1948 [8]. Bachman, en cambio, nació en Kansas [5]. Y uno de los dos grandes proyectos libres de gestores, MySQL, empezó en Suecia [13].
La respuesta corta es Estados Unidos, pero las ideas viajaron rápido. La norma de 1987 ya la publicó un organismo internacional [11].
¿Por qué siguen vivas las bases de datos más viejas?
Las bases de datos viejas siguen vivas porque cambiarlas cuesta y asusta. Stonebraker y Pavlo lo explican sin rodeos: todavía hay muchas bases IMS en uso porque migrarlas es caro y arriesgado. Aun así, según ellos, ninguna empresa nueva escogería IMS para una aplicación nueva [14].
IBM da la otra cara. A finales de la década de 2010, siete de las diez mayores empresas del sector financiero usaban IMS [1]. La empresa afirma que todavía mueve miles de millones de transacciones al día [1]. Cuando un sistema así funciona, cambiarlo es un riesgo que pocos bancos quieren correr.
El Banco de la República muestra el mismo tiempo largo desde Colombia. Su primer computador propio, un Burroughs B-3500, llegó en 1971 [2]. En 1976, su comité ejecutivo ya pedía «un sistema de información orientado a ayudar en la toma de decisiones y la estructuración de políticas» [2]. Dicho de otro modo, el acta pedía usar los datos para decidir, no solo para llevar las cuentas.
Creo que la lección para una organización latinoamericana con poco presupuesto es de orden, no de moda. Los datos duran más que el software que los guarda. Cuando una entidad escoge dónde guardarlos, está escogiendo con qué va a convivir durante décadas.
Si quiere ver esas generaciones funcionando en sistemas que usa a diario, la guía de ejemplos de bases de datos recorre diez casos. Y el panorama de qué es una base de datos está en la guía de bases de datos.
Preguntas frecuentes
¿Cuál fue la primera base de datos de la historia? Depende de qué se cuente. Si se habla de un programa que guarda datos compartidos en disco y los entrega a otros programas, el candidato más citado es IDS, de Charles Bachman, operativo en 1963 [5]. IMS, de IBM, llegó poco después y, según la empresa, ayudó a arrancar el mercado de gestores comerciales [1]. Las colecciones en papel, como los archivadores de fichas, son anteriores, pero no son el sentido informático del término.
¿Quién inventó las bases de datos? No hubo un solo inventor. Charles Bachman definió el gestor de bases de datos con IDS y el modelo de red [5]. Edgar F. Codd propuso el modelo de tablas que domina hoy [7]. Michael Stonebraker llevó esas ideas a sistemas que funcionaban, con INGRES y Postgres [9]. Los tres recibieron el Premio Turing, en 1973, 1981 y 2014 [5] [8] [9].
¿Cuántas generaciones de bases de datos hay? No hay una cuenta oficial. Stonebraker y Hellerstein distinguieron nueve épocas de modelos de datos entre finales de los sesenta y comienzos de este siglo [6]. Para leer esta línea del tiempo, aquí se agrupan en cinco familias: las que siguen rutas entre registros (árbol y red), las relacionales, las objeto-relacionales, las NoSQL y distribuidas, y las vectoriales.
¿Las bases de datos NoSQL reemplazaron a las relacionales? No. Varios sistemas NoSQL que empezaron rechazando el modelo relacional hoy ofrecen una interfaz parecida a SQL, y los grandes añadieron transacciones en la década anterior a ese análisis de 2024 [14]. MongoDB, Cassandra y DynamoDB están entre los que dieron ese giro [14]. Para Stonebraker y Pavlo, los dos mundos van hacia la convergencia, no hacia el reemplazo [14].
¿IMS todavía se usa? Sí. IBM lo presenta como una plataforma vigente, adaptada a la nube y a los dispositivos móviles [1]. Según la empresa, a finales de la década de 2010 lo usaban cuatro de las cinco mayores aseguradoras y siete de las diez mayores empresas financieras [1]. Su fortaleza está en las transacciones en fila, como los retiros en cajeros automáticos, donde el orden de cada operación importa [1].
Referencias
Las citas en otro idioma son traducción propia.
- IBM. Information Management Systems (página de IBM Heritage, historia de la empresa) — primer mensaje «READY» del sistema ICS/DL/I el 14 de agosto de 1968 en la Rockwell Space Division, en Downey (California); pedido de North American Aviation, después Rockwell, contratista principal de la nave Apollo; seguimiento de listas de materiales de millones de piezas y de las versiones de los cambios de ingeniería; trabajo iniciado en 1963 por Uri Berman (IBM) y Peter Nordyke (Rockwell); equipo con miembros de IBM, Rockwell y Caterpillar; primera versión en 1967 y entrega a la NASA un año después; modelo jerárquico en forma de árbol; antes de IMS, empresas y gobiernos construían sus propias herramientas; cada búsqueda debía programarse y los cambios en los datos obligaban a reescribir consultas; a finales de los años 2010 lo usaban 7 de las 10 mayores empresas del sector financiero y 4 de las 5 mayores aseguradoras; adaptado a plataformas móviles y de nube. IBM: Information Management Systems — Consultada: 2026-10-19.
- Pinzón, Mauricio. Un banco apoyado en la tecnología desde su fundación, capítulo de Memorias del Banco de la República en su primer centenario (Banco de la República, repositorio institucional) — desde 1964 el Banco hacía procesamientos contables y de compensación de cheques en un computador arrendado a IBM; en 1971 compró su primer computador electrónico, el Burroughs B-3500; en el acta del Comité Ejecutivo de octubre de 1976 se expresaba la necesidad de «un sistema de información orientado a ayudar en la toma de decisiones y la estructuración de políticas». Banco de la República: Un banco apoyado en la tecnología desde su fundación — Consultada: 2026-10-19.
- IBM. RAMAC (página de IBM Heritage) — el IBM 305 RAMAC, primer computador con disco de acceso aleatorio y antecesor de todos los discos duros; equipo reunido en 1952 en el laboratorio de San José, con resultado tras cuatro años de trabajo; capacidad de unos 5 megabytes y tamaño de dos neveras de cocina; acceso en segundos frente a horas o días; antes, los datos se consultaban pasando pilas de tarjetas perforadas. IBM: RAMAC — Consultada: 2026-10-19.
- IBM. The relational database (página de IBM Heritage) — artículo de Edgar F. Codd de 1970, desde el laboratorio de investigación de IBM en San José; las primeras bases usaban estructuras jerárquicas rígidas y planes de navegación para enlazar datos en cintas magnéticas; los mainframes costaban cientos de dólares por minuto; tablas enlazables y una tabla nueva con una sola consulta; System R desde 1973; cita de Donald Chamberlin: «Ted’s basic idea was that relationships between data items should be based on the item’s values, and not on separately specified linking or nesting». IBM: The relational database — Consultada: 2026-10-19.
- Association for Computing Machinery (ACM). Charles W. Bachman, perfil del Premio Turing (1973) — nacido en Manhattan, Kansas; en General Electric creó el Integrated Data Store (IDS), operativo en 1963, que mantenía un solo juego de archivos compartidos en disco; presentado como el primer sistema gestor de bases de datos; su diseño fue la principal influencia del Database Task Group de CODASYL, la asociación que creó COBOL; debate con Codd en un taller de la ACM en 1974, sin conclusión; los sistemas relacionales eclipsaron a los de CODASYL a finales de los noventa, pero siguen su plantilla de gestor e incorporan la integridad referencial. ACM: Charles W. Bachman, A.M. Turing Award — Consultada: 2026-10-19.
- Stonebraker, Michael y Hellerstein, Joseph M. What Goes Around Comes Around, capítulo 1 de Readings in Database Systems, 4.ª edición (MIT Press, 2005) — nueve épocas de modelos de datos, desde el jerárquico (IMS, finales de los sesenta) hasta el semiestructurado; IMS lanzado hacia 1968; en 1969 el comité CODASYL publicó su primer informe (Data Base Task Group Report, octubre de 1969); la propuesta de CODASYL fracasó por su complejidad. Universidad de Washington: copia del capítulo para curso — Consultada: 2026-10-19.
- Codd, Edgar F. A Relational Model of Data for Large Shared Data Banks, Communications of the ACM, vol. 13, n.º 6, junio de 1970, pp. 377-387 — artículo que propone el modelo relacional (datos bibliográficos verificados en el registro del DOI; se cita en paráfrasis). ACM: DOI 10.1145/362384.362685 — Consultada: 2026-10-19.
- Association for Computing Machinery (ACM). Edgar F. Codd, perfil del Premio Turing (1981) — nacido en 1923 en la isla de Portland, Inglaterra; matemático de Oxford; emigró a Estados Unidos poco después de graduarse en 1948; pasó al laboratorio de IBM en San José en 1968; IBM, quizá por proteger los ingresos de IMS, recibió al principio sus ideas con poco entusiasmo, y Relational Software (luego Oracle) y Relational Technology (luego Ingres) llegaron antes al mercado. ACM: Edgar F. Codd, A.M. Turing Award — Consultada: 2026-10-19.
- Association for Computing Machinery (ACM). Michael Stonebraker, perfil del Premio Turing (2014) — desarrolló INGRES con Eugene Wong en la Universidad de California en Berkeley; prototipo funcionando en 1974; Bachman diseñó lo que «a menudo se llama» el primer gestor a comienzos de los sesenta; Postgres añadió reglas entre tablas y tipos de datos «objeto-relacionales». ACM: Michael Stonebraker, A.M. Turing Award — Consultada: 2026-10-19.
- National Bureau of Standards. Federal Information Processing Standards Publication 127: Database Language SQL, que reproduce la norma ANSI X3.135-1986 (copia digitalizada en Internet Archive) — «American National Standard for Information Systems – Database Language – SQL», aprobada el 16 de octubre de 1986. Internet Archive: FIPS PUB 127, Database Language SQL — Consultada: 2026-10-19.
- Organización Internacional de Normalización (ISO). ISO 9075:1987 Information processing systems — Database language — SQL (ficha del catálogo) — edición 1, de junio de 1987; hoy retirada. ISO: ficha de ISO 9075:1987 — Consultada: 2026-10-19.
- The PostgreSQL Global Development Group. PostgreSQL 18 Documentation, capítulo 2 «A Brief History of PostgreSQL» — la implementación de POSTGRES, dirigida por Michael Stonebraker en Berkeley, empezó en 1986; en 1994 Andrew Yu y Jolly Chen añadieron un intérprete de SQL y lo publicaron como Postgres95; en 1996 tomó el nombre de PostgreSQL. PostgreSQL: Documentation 18, A Brief History of PostgreSQL — Consultada: 2026-10-19.
- Pavlo, Andrew y Aslett, Matthew. What’s Really New with NewSQL?, ACM SIGMOD Record, vol. 45, n.º 2, 2016, pp. 45-55 — IMS se construyó para llevar el inventario de partes de los proyectos Saturno V y Apollo; System R e INGRES a comienzos de los setenta; MySQL empezó en Suecia en 1995 y PostgreSQL en 1994; en los años 2000 las aplicaciones de internet necesitaban atender a muchos usuarios a la vez; el movimiento NoSQL surgió a mediados y finales de esa década, con BigTable y Dynamo como primeros referentes; muchas aplicaciones no podían renunciar a las transacciones; el término NewSQL se usó por primera vez en un informe de 2011 de uno de los autores. ACM: DOI 10.1145/3003665.3003674 — Consultada: 2026-10-19.
- Stonebraker, Michael y Pavlo, Andrew. What Goes Around Comes Around… And Around…, ACM SIGMOD Record, vol. 53, n.º 2, junio de 2024, pp. 21-37 — el modelo relacional sigue siendo el dominante y SQL absorbió las mejores ideas de sus rivales; el objeto-relacional se impuso; todavía hay muchas bases IMS en uso porque migrarlas es caro y arriesgado; Yahoo! desarrolló Hadoop en 2005 y, según los autores, «Hadoop died about a decade ago»; Amazon creó Dynamo en 2007; MongoDB es el sistema de documentos más popular; los almacenes de datos para análisis desde mediados de los noventa, que solían pagarse solos en seis meses; nube desde finales de los 2000; NewSQL a comienzos de los 2010 y sus herederos distribuidos (TiDB, CockroachDB, YugabyteDB); bases vectoriales (Pinecone, Milvus, Weaviate) y adopción de índices vectoriales por varios motores relacionales en 2023; varios NoSQL añadieron transacciones e interfaces parecidas a SQL. ACM: DOI 10.1145/3685980.3685984 — Consultada: 2026-10-19.
Cómo investigamos esta página
- Pregunta que responde: cómo evolucionaron las bases de datos y qué problema resolvió cada generación
- Fuentes: identificadas 22 → incluidas 14
- Criterios de inclusión: historia institucional, perfiles de la ACM, artículos con DOI y normas leídos en texto original
- Fecha de corte de los datos: 2026-10-19