
Apache Spark: qué es y cómo reparte el trabajo entre muchas máquinas
Apache Spark es un motor gratuito y de código abierto que reparte el análisis de grandes volúmenes de datos entre muchas máquinas y los guarda en memoria cuando puede. Un programa central divide el trabajo en tareas, y nada se calcula hasta que alguien pide un resultado. Corre en un portátil, en servidores propios o en la nube.
Última actualización: 2026-11-11
Contenido de esta página
- ¿Qué es Apache Spark?
- ¿De dónde viene Spark y qué cambió?
- ¿Cómo funciona Spark? Driver, executors y gestor del clúster
- RDD, DataFrame y Dataset: ¿cuál usar?
- Los cuatro módulos de Spark
- ¿Dónde corre Spark? Local, en clúster o en la nube
- Errores típicos de Spark: shuffle y particionado
- ¿Cuándo conviene usar Spark?
Un grupo de la Universidad de California en Berkeley apagó a propósito una de sus máquinas en plena tarea. Lo cuentan Matei Zaharia y ocho coautores en un artículo de 2012 [1]. Ahí describieron a fondo los RDD, unos conjuntos de datos repartidos entre muchas máquinas sobre los que se construyó Spark [1].
El experimento corría k-means, un algoritmo que agrupa datos parecidos repitiendo el mismo cálculo varias veces. Usaba 75 máquinas y 100 gigabytes de datos [1]. Cada vuelta del algoritmo tardaba unos 58 segundos [1].
Al comenzar la sexta vuelta, mataron una de las máquinas. Se perdieron sus tareas y los pedazos de datos que guardaba en memoria [1]. Esa vuelta subió a 80 segundos. La siguiente volvió a 58 [1].
Spark no fue a buscar una copia de respaldo. Repitió esas tareas en las otras máquinas, que volvieron a leer los datos de entrada y rehicieron los pedazos perdidos con la receta que los había fabricado [1]. Esa receta, que los autores llaman linaje, ocupaba menos de 10 kilobytes en sus ejemplos [1].
Esa idea está en el centro de Apache Spark. Guarda los datos en memoria para trabajar rápido. Y en lugar de copiarlos por si acaso, recuerda los pasos para rehacerlos.
¿Qué es Apache Spark?
Apache Spark es un programa gratuito que reparte el análisis de muchos datos entre varias máquinas y les da a quienes programan una sola manera de pedir ese trabajo. Su documentación oficial lo define como un motor unificado de análisis para procesar datos a gran escala [2].
Se programa en Java, Scala, Python o R [2]. Scala es un lenguaje que corre sobre la misma plataforma de Java. El soporte para R sigue, aunque la documentación de la versión 4.3.0 lo marca como obsoleto [2].
Sobre ese motor viven herramientas para consultar tablas con SQL (el lenguaje estándar para pedirle datos a una base), aprender de los datos, analizar redes y procesar flujos continuos [2]. Spark es un proyecto de la Fundación Apache, que publica su software con la licencia Apache 2.0 [3].
La versión estable más reciente es la 4.3.0, que el proyecto anunció el 30 de octubre de 2026 [4]. Tres días antes había publicado versiones de corrección para ramas anteriores, que siguen recibiendo arreglos [4].
Para probarlo no hace falta un clúster, es decir, un grupo de computadores conectados que trabajan como uno solo. Basta tener Java instalado para ejecutarlo en una sola máquina [2]. Esta versión corre con Java 17, 21 o 25 y con Python 3.11 o posterior [2].
¿De dónde viene Spark y qué cambió?
Spark nació en 2009 en un grupo de investigación de Berkeley, que buscaba un motor único para procesar datos repartidos entre muchas máquinas [5]. Se liberó al público en 2010 [5]. Su pieza central es el RDD, siglas en inglés de conjunto de datos distribuido y resiliente, que el artículo de 2012 describió a fondo [1].
Un RDD es una colección de datos partida en pedazos, llamados particiones, que viven en distintas máquinas y se procesan en paralelo [1]. No se modifica: cada operación produce un RDD nuevo [1]. El artículo de 2012 lo pensó para dos casos que los sistemas de entonces manejaban mal: los algoritmos que repiten cálculos sobre los mismos datos y la exploración interactiva [1].
El secreto estaba en lo que el RDD recuerda. En vez de guardar copias, guarda la lista de operaciones que lo produjeron [1]. Si se pierde una partición, Spark repite solo esas operaciones sobre los datos de origen [1]. La versión que describe el artículo tenía unas 14.000 líneas de código en Scala [1].
En 2016, Zaharia y otros trece coautores contaron lo que vino después en Communications of the ACM, la revista de la Association for Computing Machinery, una asociación internacional de informática [5]. Su tesis: un modelo sencillo bastaba para servir a usos que antes exigían motores separados. SQL, flujos continuos, aprendizaje automático y grafos corrían como bibliotecas sobre un mismo motor [5].
Para entonces el proyecto tenía más de 1.000 contribuyentes y se usaba en más de 1.000 organizaciones [5]. La instalación más grande publicada superaba las 8.000 máquinas [5].
¿Cómo funciona Spark? Driver, executors y gestor del clúster
Spark funciona con un programa central que planea el trabajo y varios procesos trabajadores que lo ejecutan. Al central la documentación lo llama driver, o programa conductor; a los trabajadores, executors, o ejecutores [6]. Entre los dos media un gestor del clúster, el servicio que presta las máquinas [6].
El recorrido de una aplicación sigue cuatro pasos [6]:
- El driver arranca el programa del usuario y se conecta a un gestor del clúster.
- El gestor le asigna executors en las máquinas disponibles: procesos que calculan y guardan datos para esa aplicación.
- El driver envía el código de la aplicación a los executors.
- El driver reparte tareas, y cada executor las corre en varios hilos, es decir, en varias líneas de trabajo simultáneas.
Cada aplicación tiene sus propios executors, que viven mientras ella dure [6]. Eso aísla a unas aplicaciones de otras. También tiene un costo: dos aplicaciones no pueden compartir datos sin escribirlos antes en un almacenamiento externo [6].
El driver necesita hablar con sus executors durante toda la ejecución. Por eso la documentación recomienda ponerlo cerca de las máquinas trabajadoras, de preferencia en la misma red local [6].
La documentación usa un vocabulario preciso, y vale la pena tenerlo a mano:
| Término | Qué es, según la documentación oficial |
|---|---|
| Aplicación | El programa del usuario: un driver más sus executors en el clúster [6] |
| Driver | El proceso que corre la función principal del programa y crea el contexto de Spark [6] |
| Gestor del clúster | Un servicio externo que consigue recursos en el clúster [6] |
| Executor | Un proceso que corre tareas y guarda datos en memoria o en disco [6] |
| Tarea | La unidad de trabajo que se envía a un executor [6] |
| Trabajo (job) | Un cálculo en paralelo, hecho de muchas tareas, que se dispara con una acción [6] |
| Etapa (stage) | Cada grupo de tareas en que se divide un trabajo; unas etapas dependen de otras [6] |
El lugar del driver también se elige. En el modo de despliegue de clúster, el driver corre dentro del clúster; en el modo cliente, corre fuera, en el equipo de quien lanza la aplicación [6].
Transformaciones y acciones: la evaluación perezosa
Spark distingue dos tipos de operación. Las transformaciones crean un conjunto de datos nuevo a partir de otro, como filtrar filas. Las acciones devuelven un resultado al driver, como contar filas [7].
Todas las transformaciones son perezosas: no calculan nada en el momento, solo anotan qué hay que hacer [7]. El cálculo ocurre cuando una acción pide un resultado [7]. El artículo de 2016 da la razón en una frase: «Spark evalúa los RDD de forma perezosa, lo que le permite encontrar un plan eficiente para el cálculo del usuario» [5]. Las citas de esta página son traducción propia.
Piense en una lista de mercado. Usted la va armando durante la semana, pero solo sale a comprar cuando la necesita. Y como ve la lista entera, organiza la ruta para no pasar dos veces por el mismo pasillo.
Eso hace Spark con el plan. Si hay varios filtros seguidos, puede juntarlos en una sola pasada sobre los datos [5]. El ejemplo de abajo lo muestra con la interfaz de Python, en modo local: dos transformaciones que no ejecutan nada y una acción que dispara el trabajo.
# Ejemplo mínimo: transformaciones perezosas y una acción que dispara el trabajo
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

# Sesión local: el driver y los executors viven en este mismo computador, con 2 hilos
spark = SparkSession.builder.master("local[2]").appName("perezoso").getOrCreate()
spark.sparkContext.setLogLevel("ERROR")
rastreo = spark.sparkContext.statusTracker()

ventas = spark.createDataFrame(
    [("Bucaramanga", 120), ("Cúcuta", 80), ("Bucaramanga", 50),
     ("Barrancabermeja", 30), ("Cúcuta", 70), ("Bucaramanga", 10)],
    "ciudad string, valor long",
)

# Dos transformaciones: Spark solo anota el plan, todavía no calcula nada
grandes = ventas.filter(F.col("valor") >= 50)
por_ciudad = grandes.groupBy("ciudad").agg(F.sum("valor").alias("total"))
print("Trabajos ejecutados antes de la acción:", len(rastreo.getJobIdsForGroup()))

# El plan físico: «Exchange» es el shuffle que exige agrupar por ciudad
por_ciudad.explain()

# La acción: ahora sí se ejecuta el trabajo y el resultado vuelve al driver
for fila in por_ciudad.orderBy("ciudad").collect():
    print(fila["ciudad"], fila["total"])
print("Trabajos ejecutados después de la acción:", len(rastreo.getJobIdsForGroup()))

print("Spark", spark.version)
spark.stop()
Lo ejecuté el 11 de noviembre de 2026 con PySpark 4.3.0, Python 3.12 y Java 21, en un portátil con Windows. Esta fue la salida, sin los avisos de arranque:
Trabajos ejecutados antes de la acción: 0
== Physical Plan ==
AdaptiveSparkPlan isFinalPlan=false
+- HashAggregate(keys=[ciudad#0], functions=[sum(valor#1L)])
   +- Exchange hashpartitioning(ciudad#0, 200), ENSURE_REQUIREMENTS, [plan_id=15]
      +- HashAggregate(keys=[ciudad#0], functions=[partial_sum(valor#1L)])
         +- Filter (isnotnull(valor#1L) AND (valor#1L >= 50))
            +- Scan ExistingRDD[ciudad#0,valor#1L]

Bucaramanga 170
Cúcuta 150
Trabajos ejecutados después de la acción: 4
Spark 4.3.0
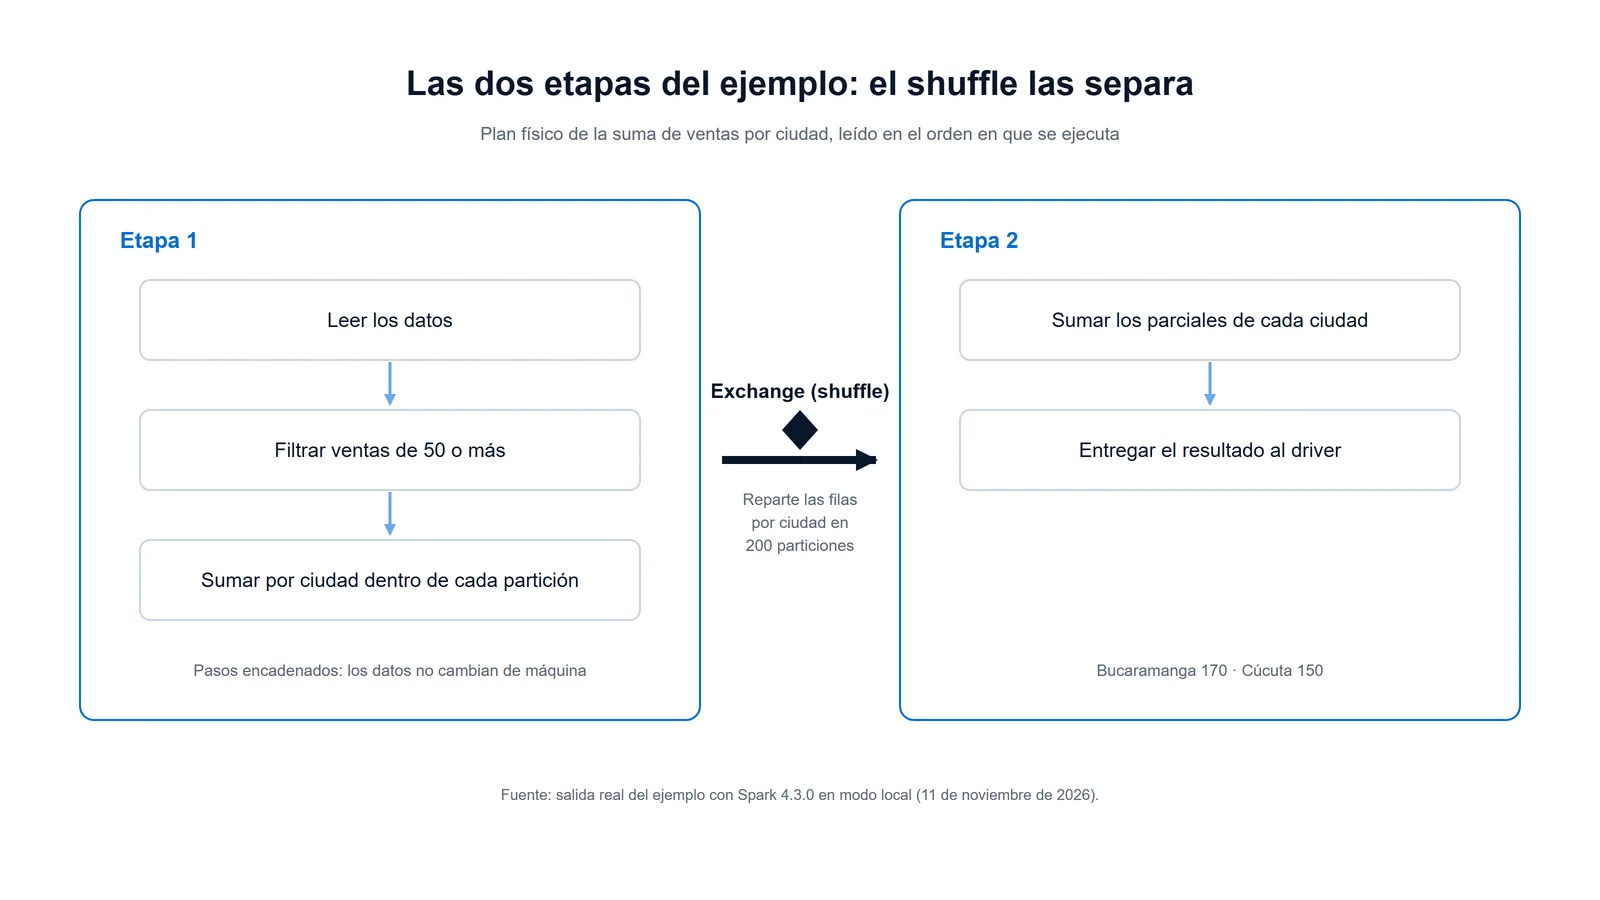
Antes de la acción, Spark no había ejecutado ningún trabajo: solo tenía el plan. El plan se lee de abajo hacia arriba. Primero lee los datos, luego filtra y suma por ciudad dentro de cada partición. Después viene el «Exchange», que reparte las filas en 200 particiones según la ciudad. Al final suma los parciales. Barrancabermeja no aparece porque su única venta no pasó el filtro. El contador marca 4 trabajos y no 1 porque la acción del ejemplo también ordena el resultado por ciudad, y ese orden añade trabajos que el plan impreso no muestra.
El DAG: el mapa de pasos que arma Spark
Cuando llega una acción, el planificador de Spark mira el linaje completo y arma un DAG (grafo acíclico dirigido) de etapas [1]. Es un mapa de pasos unidos por flechas que nunca regresan a un paso anterior. La interfaz web de Spark lo dibuja para cada trabajo [8].
Las etapas se cortan donde los datos tienen que cambiar de máquina [1]. El artículo de 2012 distingue dos clases de dependencia entre conjuntos de datos [1]:
- Estrecha. Cada partición de origen alimenta a lo sumo una partición del resultado, como en un filtro. Se puede encadenar en la misma máquina sin mover datos.
- Amplia. Una partición de origen alimenta a varias particiones del resultado, como al agrupar por una clave. Obliga a mover datos entre máquinas.
Esa redistribución se llama shuffle, y es la frontera entre una etapa y la siguiente [1]. En la salida del ejemplo aparece con el nombre «Exchange», que es también la etiqueta que muestra la interfaz web [8].
RDD, DataFrame y Dataset: ¿cuál usar?
Spark ofrece tres formas de representar los datos, y la documentación recomienda las dos más nuevas. El RDD fue la interfaz principal hasta la versión 2.0 [9]. Después lo reemplazó el Dataset, aunque el RDD sigue soportado [9].
La diferencia es cuánto sabe Spark de sus datos. Con un RDD, Spark ve objetos y funciones que le cuesta analizar y optimizar por su cuenta [5]. Con un DataFrame, sabe qué columnas hay y qué se les pide, y con esa información optimiza el plan [10].
| Abstracción | Para qué sirve | Nota |
|---|---|---|
| RDD | Colección de elementos repartida entre las máquinas, que se opera en paralelo con funciones propias [7] | Sigue soportado; la guía de inicio recomienda pasar al Dataset, que según ella rinde mejor [9] |
| DataFrame | Datos organizados en columnas con nombre, como una tabla de una base de datos relacional [10] | Disponible en Python, Scala, Java y R [10]; Spark lo añadió en 2015 [5] |
| Dataset | Colección con tipos de datos fijos, que suma ventajas del RDD al motor optimizado de Spark SQL [10] | Llegó en la versión 1.6 y solo existe en Scala y Java; Python no lo tiene [10] |
En Scala y Java, un DataFrame no es más que un Dataset de filas [10]. Por eso la documentación los trata casi como sinónimos.
Los cuatro módulos de Spark
Spark trae cuatro bibliotecas principales que corren sobre el mismo motor, y esa es la razón de llamarlo unificado [5]. Un programa puede consultar con SQL, entrenar un modelo y procesar un flujo sin copiar los datos de un sistema a otro [5].
| Módulo | Qué hace, en una frase |
|---|---|
| Spark SQL | Procesa datos estructurados con consultas SQL o con DataFrames, y usa la información de su estructura para optimizar [10] |
| Structured Streaming | Procesa flujos de datos que no paran de llegar, escritos igual que un cálculo sobre datos fijos [11] |
| MLlib | Es la biblioteca de aprendizaje automático: clasificación, regresión, agrupamiento y herramientas para armar flujos de modelos [12] |
| GraphX | Trabaja con grafos, es decir, redes de puntos unidos por relaciones, como quién sigue a quién [13] |
La biblioteca de aprendizaje automático tiene hoy dos interfaces. La principal trabaja con DataFrames. La antigua, basada en RDD, está en mantenimiento: recibe correcciones, pero no funciones nuevas [12]. La documentación aclara que ninguna de las dos está obsoleta [12]. Qué hace cada algoritmo y cuándo conviene es tema del machine learning, no de Spark.
Spark Streaming y Structured Streaming: dos nombres, dos motores
El nombre confunde porque hubo dos motores de flujos. Spark Streaming fue el primero: dividía los datos en pequeños lotes y procesaba cada lote con el motor de Spark [14]. Sus flujos se llamaban DStreams, por discretized streams, o flujos discretizados [5].
Hoy la documentación lo llama proyecto heredado: dice que ya no recibe actualizaciones y pide usar Structured Streaming [14].
Structured Streaming se construyó sobre el motor de Spark SQL [11]. Usted escribe la consulta como si los datos estuvieran quietos, y el motor la ejecuta de forma continua a medida que llegan [11]. Los datos suelen entrar desde una plataforma de eventos como Kafka, que se explica en la guía de ingeniería de datos.
¿Dónde corre Spark? Local, en clúster o en la nube
Spark no depende de un gestor de clúster en particular: le basta con conseguir executors que se comuniquen entre sí, y la documentación lo describe como relativamente fácil [6]. Por eso el mismo programa puede correr en un portátil o en un clúster grande. La opción se elige con la dirección del maestro (master URL) al lanzar la aplicación [15].
| Dónde | Qué es | Para qué sirve |
|---|---|---|
| Local | Spark corre en un solo computador; «local[K]» usa K hilos y «local[*]» tantos hilos como núcleos lógicos tenga la máquina [15] | Aprender y probar; la documentación sugiere empezar con «local» [2] |
| Standalone | Un gestor de clúster sencillo que viene con Spark [6][16] | Montar un clúster propio con lo que trae Spark; también puede correr en una sola máquina para pruebas [16] |
| YARN | El gestor de recursos de Hadoop 3 [6] | Organizaciones que ya tienen un clúster de big data montado sobre Hadoop |
| Kubernetes | Un sistema de código abierto que despliega y escala aplicaciones en contenedores, que son paquetes de software listos para correr [6] | El driver y los executors corren cada uno en un pod, la unidad mínima de Kubernetes [17] |
| Servicio gestionado | Un proveedor de nube monta y administra el clúster | Pagar por uso sin administrar servidores (ver abajo) |
Así describen su servicio, en su propia documentación, tres proveedores:
- Amazon EMR. Amazon Web Services lo presenta como una plataforma de clústeres administrada para correr Hadoop y Spark [18]. Su versión emr-7.14.0, la última de la serie 7.x, trae Spark 3.5.8 con la etiqueta «amzn» de Amazon [19].
- Google Cloud. El servicio antes conocido como Dataproc se llama hoy Managed Service for Apache Spark [20]. Ofrece clústeres que se crean y se apagan según se necesiten, y una modalidad sin servidor que corre trabajos sin que usted cree un clúster [20][21].
- Databricks. La empresa la fundaron los creadores originales de Spark, según su documentación [22]. Su plataforma configura Spark por usted y le suma optimizaciones propias que no están en el proyecto abierto [22].
Ojo con un detalle del primer punto. La versión de Spark que trae un servicio gestionado puede ir detrás del proyecto abierto: mientras Apache ya publicó la 4.3.0 [4], la serie 7.x de EMR trae la 3.5.8 [19]. Antes de copiar un ejemplo de la documentación, revise qué versión tiene su servicio.
Errores típicos de Spark: shuffle y particionado
Los errores más comunes de rendimiento en Spark nacen de cómo se mueven y se reparten los datos. La documentación califica el shuffle de operación compleja y costosa [7]. Implica leer y escribir en disco, serializar los datos, es decir, convertirlos en bytes para enviarlos, y moverlos por la red [7].
Lo provocan operaciones como reagrupar por una clave, unir dos tablas o cambiar el número de particiones [7]. No siempre se puede evitar. Sí se puede hacer más barato.
| Síntoma | Causa según la documentación | Qué propone o indica la documentación |
|---|---|---|
| El clúster no se usa completo | Pocas tareas en paralelo para los núcleos disponibles [23] | Subir el nivel de paralelismo; en general recomienda de 2 a 3 tareas por núcleo [23] |
| Falta de memoria aunque los datos caben | La tabla interna que arma una tarea al agrupar, por ejemplo en un «groupByKey», crece demasiado [23] | Subir el paralelismo para que cada tarea reciba menos datos [23] |
| Muchas tareas diminutas después de un shuffle | Un número fijo de particiones; en consultas SQL el valor por defecto es 200 [24] | La ejecución adaptativa de consultas (AQE), activa por defecto desde la versión 3.2.0, junta particiones pequeñas mientras corre [24] |
| Una tarea tarda mucho más que las demás en una unión | Sesgo: una partición mucho más grande que el resto [24] | La AQE parte las particiones sesgadas en tareas de tamaño parecido [24] |
| Tareas pesadas de enviar | El código usa un objeto grande del driver, como una tabla de referencia [23] | Convertirlo en variable de difusión (broadcast), que se envía una vez a cada máquina; vale revisar tareas de más de unos 20 KiB, algo más de 20.000 bytes [23] |
| Disco lleno en trabajos largos | El shuffle deja archivos intermedios que se borran solo cuando ya no se usan [7] | Esos archivos van al directorio temporal que fija la configuración; trabajos largos pueden ocupar mucho disco [7] |
La AQE (ejecución adaptativa de consultas) reoptimiza el plan de una consulta a mitad de camino, con estadísticas reales de la ejecución [24]. Trabaja con DataFrames y SQL. Si su código usa RDD, sigue a cargo del paralelismo a mano.
Un caso merece atención especial: unir una tabla enorme con una pequeña. Spark SQL envía la tabla pequeña completa a cada máquina cuando pesa hasta 10 MB, según su configuración por defecto [24]. Si su tabla pequeña pesa un poco más, ese límite se puede ajustar [24].
¿Cuándo conviene usar Spark?
Spark nació para dos casos: repetir cálculos sobre los mismos datos y explorarlos de forma interactiva, con los datos repartidos en un clúster [1]. Si su trabajo cabe con holgura en un computador, puede que no lo necesite todavía. No es la única herramienta del ecosistema; el panorama completo está en la guía de big data.
Para empezar, un analista colombiano necesita poco: el motor no tiene costo de licencia [3] y la documentación explica cómo correrlo en un solo computador con Java [2]. El costo aparece después, cuando se alquilan máquinas en la nube.
Voy a tomar partido, y es opinión mía. Lo valioso de Spark no es la velocidad que promete su publicidad. Es aquel momento del experimento de Berkeley: una máquina cae y el trabajo sigue sin que nadie restaure nada. Para un equipo pequeño, sin ingenieros de guardia de madrugada, esa tolerancia vale más que unos segundos ganados.
Por eso aprenda primero el modelo, no los comandos. Quien entiende por qué un agrupamiento dispara un shuffle escribe trabajos que no se caen a las tres de la mañana. ¿Qué parte de su proceso de datos se rompería hoy si se apagara una máquina?
Preguntas frecuentes
¿Apache Spark es gratis? Sí. Es software de la Fundación Apache, que publica sus proyectos bajo su licencia Apache 2.0 [3]. Se descarga sin pagar. Lo que sí cuesta es la infraestructura: los servidores propios o el alquiler de un servicio en la nube.
¿Spark necesita un clúster para funcionar? No. Puede correr en un solo computador en modo local, con uno o varios hilos de trabajo, que es lo que la documentación sugiere para empezar [2][15]. El mismo programa se lleva después a un clúster cambiando la dirección del maestro, sin reescribir la lógica.
¿Qué es Spark Connect? Es una arquitectura de cliente y servidor que llegó con la versión 3.4 [2]. Separa la aplicación del clúster: el programa del usuario corre en un lado y se conecta a distancia al motor que está en el otro [2]. Así se puede usar Spark desde otra aplicación sin instalar el clúster junto a ella.
¿En qué lenguajes se programa Spark? En Java, Scala, Python y R, aunque R figura como obsoleto en la versión 4.3.0 [2]. La versión que describe el artículo de 2012 estaba escrita en Scala [1]. La interfaz de Python tiene su propio nombre, PySpark, y su guía propia.
¿Qué versión de Spark se debe instalar hoy? La más reciente es la 4.3.0, del 30 de octubre de 2026 [4]. Si su empresa usa un servicio gestionado, la versión la fija el proveedor y puede ser anterior; en Amazon EMR, la serie 7.x trae la 3.5.8 [19]. Para aprender, conviene la misma versión que usará en el trabajo.
Referencias
- Zaharia, Matei; Chowdhury, Mosharaf; Das, Tathagata; Dave, Ankur; Ma, Justin; McCauley, Murphy; Franklin, Michael J.; Shenker, Scott; Stoica, Ion (University of California, Berkeley). Resilient Distributed Datasets: A Fault-Tolerant Abstraction for In-Memory Cluster Computing, NSDI 2012 — definición de RDD como abstracción de memoria distribuida tolerante a fallas, motivada por algoritmos iterativos y minería interactiva; RDD inmutables y particionados; recuperación por linaje; acciones y cálculo perezoso de los RDD; dependencias estrechas y amplias; el planificador arma un DAG de etapas cuyas fronteras son los shuffle; implementación en unas 14.000 líneas de Scala; experimento de k-means en 75 nodos con 100 GB, iteraciones de unos 58 s, una máquina eliminada al inicio de la 6.ª iteración que subió a 80 s y regreso a 58 s; grafos de linaje de menos de 10 KB. USENIX: Resilient Distributed Datasets, NSDI 2012 — Consultada: 2026-11-11.
- The Apache Software Foundation. Spark Overview, documentación de Apache Spark 4.3.0 — «Apache Spark is a unified analytics engine for large-scale data processing»; interfaces en Java, Scala, Python y R; Spark SQL, pandas API on Spark, MLlib, GraphX y Structured Streaming; corre en una sola máquina con Java instalado; Java 17/21/25, Scala 2.13, Python 3.11+ y R 4.0+ (obsoleto); empezar con «local» para pruebas; Spark Connect, arquitectura cliente-servidor introducida en Spark 3.4. Apache Spark: Overview 4.3.0 — Consultada: 2026-11-11.
- The Apache Software Foundation. Licenses — todo el software producido por la Fundación Apache o sus proyectos se licencia según los documentos listados; la Apache License 2.0 es su licencia actual. Apache: Licenses — Consultada: 2026-11-11.
- The Apache Software Foundation. Spark News — Spark 4.3.0 publicada el 30 de octubre de 2026; Spark 4.2.1, 4.1.4 y 4.0.5 publicadas el 27 de octubre de 2026. Apache Spark: News — Consultada: 2026-11-11.
- Zaharia, Matei; Xin, Reynold S.; Wendell, Patrick; Das, Tathagata; Armbrust, Michael; Dave, Ankur; Meng, Xiangrui; Rosen, Josh; Venkataraman, Shivaram; Franklin, Michael J.; Ghodsi, Ali; Gonzalez, Joseph; Shenker, Scott; Stoica, Ion. Apache Spark: A Unified Engine for Big Data Processing, Communications of the ACM 59(11), noviembre de 2016, DOI 10.1145/2934664 — el proyecto empezó en 2009 en Berkeley y se liberó en 2010; «Spark evaluates RDDs lazily, allowing it to find an efficient plan for the user’s computation»; fusión de filtros y mapas en una pasada; SQL, streaming, aprendizaje automático y grafos como bibliotecas sobre un motor común; discretized streams; más de 1.000 contribuyentes y más de 1.000 organizaciones; despliegue público más grande de más de 8.000 nodos; DataFrames añadidos en 2015; en el API funcional el sistema no podía optimizar las funciones arbitrarias de los RDD. ACM: DOI 10.1145/2934664 · UC Berkeley: copia de los autores — Consultada: 2026-11-11.
- The Apache Software Foundation. Cluster Mode Overview, documentación de Apache Spark 4.3.0 — aplicaciones coordinadas por el SparkContext del driver; gestores standalone, YARN («the resource manager in Hadoop 3») y Kubernetes; executors propios de cada aplicación, que no comparten datos sin almacenamiento externo; Spark es agnóstico al gestor; el driver debe estar cerca de los nodos trabajadores, de preferencia en la misma red local; glosario de aplicación, driver, gestor del clúster, modo de despliegue, executor, tarea, trabajo y etapa. Apache Spark: Cluster Mode Overview — Consultada: 2026-11-11.
- The Apache Software Foundation. RDD Programming Guide, documentación de Apache Spark 4.3.0 — transformaciones y acciones; «All transformations in Spark are lazy»; el shuffle redistribuye datos entre particiones y es una operación compleja y costosa que implica E/S de disco, serialización y E/S de red; operaciones que lo causan; archivos intermedios de shuffle conservados hasta que los RDD dejan de usarse, en el directorio de spark.local.dir. Apache Spark: RDD Programming Guide — Consultada: 2026-11-11.
- The Apache Software Foundation. Web UI, documentación de Apache Spark 4.3.0 — visualización del grafo acíclico dirigido (DAG) de cada trabajo y etapa, con nodos etiquetados por operación (BatchScan, WholeStageCodegen, Exchange). Apache Spark: Web UI — Consultada: 2026-11-11.
- The Apache Software Foundation. Quick Start, documentación de Apache Spark 4.3.0 — antes de Spark 2.0 la interfaz principal era el RDD; después lo reemplazó el Dataset; el RDD sigue soportado y se recomienda pasar al Dataset, que tiene mejor rendimiento. Apache Spark: Quick Start — Consultada: 2026-11-11.
- The Apache Software Foundation. Spark SQL, DataFrames and Datasets Guide, documentación de Apache Spark 4.3.0 — Spark SQL usa la información de estructura para optimizar; Dataset añadido en Spark 1.6, disponible en Scala y Java, no en Python; DataFrame como Dataset organizado en columnas con nombre, equivalente a una tabla relacional, disponible en Python, Scala, Java y R; en Scala, DataFrame es alias de Dataset[Row]. Apache Spark: SQL, DataFrames and Datasets Guide — Consultada: 2026-11-11.
- The Apache Software Foundation. Structured Streaming Programming Guide, documentación de Apache Spark 4.3.0 — motor de flujos construido sobre el motor de Spark SQL; el cálculo se expresa igual que uno por lotes sobre datos estáticos y se ejecuta de forma incremental y continua. Apache Spark: Structured Streaming Programming Guide — Consultada: 2026-11-11.
- The Apache Software Foundation. Machine Learning Library (MLlib) Guide, documentación de Apache Spark 4.3.0 — algoritmos de clasificación, regresión, agrupamiento y filtrado colaborativo, y pipelines; el API basado en DataFrames es el principal; el basado en RDD está en modo de mantenimiento; ninguno está obsoleto. Apache Spark: MLlib Guide — Consultada: 2026-11-11.
- The Apache Software Foundation. GraphX Programming Guide, documentación de Apache Spark 4.3.0 — componente para grafos y cálculo paralelo sobre grafos, que extiende el RDD con una abstracción de grafo dirigido con propiedades. Apache Spark: GraphX Programming Guide — Consultada: 2026-11-11.
- The Apache Software Foundation. Spark Streaming Programming Guide, documentación de Apache Spark 4.3.0 — Spark Streaming es la generación anterior del motor de flujos; ya no recibe actualizaciones y es un proyecto heredado; se recomienda Structured Streaming; divide los datos en lotes que procesa el motor de Spark. Apache Spark: Spark Streaming (DStreams) — Consultada: 2026-11-11.
- The Apache Software Foundation. Submitting Applications, documentación de Apache Spark 4.3.0 — formatos de la master URL: local, local[K], local[*], spark://, yarn y k8s://. Apache Spark: Submitting Applications — Consultada: 2026-11-11.
- The Apache Software Foundation. Spark Standalone Mode, documentación de Apache Spark 4.3.0 — modo de despliegue autónomo sencillo; se puede lanzar a mano o con scripts y correr en una sola máquina para pruebas. Apache Spark: Standalone Mode — Consultada: 2026-11-11.
- The Apache Software Foundation. Running Spark on Kubernetes, documentación de Apache Spark 4.3.0 — el driver corre dentro de un pod de Kubernetes y crea executors que también corren en pods. Apache Spark: Running on Kubernetes — Consultada: 2026-11-11.
- Amazon Web Services. What is Amazon EMR? — plataforma de clústeres administrada que simplifica correr marcos de big data como Apache Hadoop y Apache Spark en AWS. AWS: What is Amazon EMR — Consultada: 2026-11-11.
- Amazon Web Services. Apache Spark, Amazon EMR Release Guide — la última versión de la serie 7.x, emr-7.14.0, incluye Spark 3.5.8-amzn-0. AWS: Apache Spark en Amazon EMR — Consultada: 2026-11-11.
- Google Cloud. Managed Service for Apache Spark on clusters overview (última actualización: 2026-11-09) — es el nuevo nombre del producto antes conocido como «Dataproc on Compute Engine» y «Google Cloud Serverless for Apache Spark»; automatiza crear, administrar y apagar clústeres. Google Cloud: Managed Service for Apache Spark on clusters — Consultada: 2026-11-11.
- Google Cloud. Managed Service for Apache Spark serverless overview (última actualización: 2026-11-09) — corre cargas de Spark sin aprovisionar ni administrar un clúster propio. Google Cloud: Managed Service for Apache Spark serverless — Consultada: 2026-11-11.
- Databricks. Apache Spark on Databricks (última actualización: 11 de septiembre de 2026) — la empresa la fundaron los creadores originales de Apache Spark; el Databricks Runtime añade optimizaciones y funciones propietarias, como Photon; Spark se configura y despliega en máquinas virtuales sin que el usuario inicialice la sesión. Databricks: Apache Spark on Databricks — Consultada: 2026-11-11.
- The Apache Software Foundation. Tuning Spark, documentación de Apache Spark 4.3.0 — nivel de paralelismo, en general de 2 a 3 tareas por núcleo; OutOfMemoryError por el conjunto de trabajo de una tarea de reducción como groupByKey, con el arreglo de subir el paralelismo; variables de difusión para objetos grandes del driver, con tareas de más de unos 20 KiB como candidatas a optimizar. Apache Spark: Tuning Spark — Consultada: 2026-11-11.
- The Apache Software Foundation. Performance Tuning, guía de Spark SQL 4.3.0 — spark.sql.shuffle.partitions con valor por defecto 200; Adaptive Query Execution activada por defecto desde Spark 3.2.0, que reoptimiza con estadísticas de ejecución; unión de particiones pequeñas tras el shuffle; manejo del sesgo en uniones; spark.sql.autoBroadcastJoinThreshold de 10485760 bytes (10 MB). Apache Spark: SQL Performance Tuning — Consultada: 2026-11-11.
Cómo investigamos esta página
- Pregunta que responde: Qué es Apache Spark, cómo reparte y planea el trabajo, qué módulos trae, dónde corre y qué errores de shuffle y particionado son típicos.
- Fuentes: identificadas 41 → incluidas 24
- Criterios de inclusión: documentación oficial de Spark 4.3.0 y de tres proveedores de nube, más los dos artículos fundacionales; sin blogs, cursos ni enciclopedias.
- Fecha de corte de los datos: 2026-11-11