
Histograma: qué es, cómo se hace y cómo se interpreta
Un histograma es un gráfico de barras pegadas que muestra cómo se reparten los valores de una variable numérica: el eje horizontal se parte en intervalos del mismo ancho y cada barra cuenta cuántos datos caen en el suyo. Sirve para ver la forma de los datos, y el ancho que se elija para los intervalos puede cambiar lo que uno concluye.
Última actualización: 2026-11-06
Contenido de esta página
- ¿Qué es un histograma?
- ¿Cómo se hace un histograma? De los datos a los intervalos
- ¿Cómo se interpreta un histograma?
- ¿Cuántos intervalos debe tener un histograma? El mismo dato, dibujado tres veces
- Histograma vs gráfico de barras: ¿en qué se diferencian?
- La curva de densidad (KDE): el histograma suavizado
- ¿Cómo se hace un histograma en Python o en Excel?
- ¿Quién decide lo que muestra un histograma?
En el parque nacional de Yellowstone, en Estados Unidos, los guardaparques anuncian a qué hora volverá a hacer erupción el géiser Old Faithful [1]. No adivinan. El Servicio de Parques Nacionales explica que matemáticos, estadísticos y observadores encontraron una relación entre lo que dura una erupción y la espera que viene después [1]. Una erupción corta descarga menos agua y calor, así que el géiser se recarga pronto. Una larga necesita más tiempo [1].
El mismo servicio cuenta otro detalle. Después del terremoto de Hebgen Lake, en 1959, el géiser empezó a hacer erupción con dos intervalos distintos: uno corto y otro largo [1].
Ahora imagine la lista de esas esperas, una detrás de otra: 79, 54, 74 minutos, y así sigue. Así empieza la versión de estos datos que el proyecto R distribuye para practicar [2].
Leída cifra por cifra, la lista no dice nada. El promedio de sus 272 esperas tampoco ayuda: da 70,9 minutos [2], un número que cae entre los dos grupos y no describe a ninguno.
El gráfico que deja ver esos dos grupos de un vistazo se llama histograma. Y, como verá más abajo, el mismo gráfico también puede esconderlos.
¿Qué es un histograma?
El histograma es el gráfico que muestra la forma de una variable numérica medida, como minutos, kilos o estaturas. Se arma con barras pegadas: la base de cada barra es un tramo de la escala y su altura dice cuántos datos cayeron en ese tramo. A esos tramos se les llama intervalos, o clases.
El manual de estadística del NIST, el instituto de normas técnicas del gobierno de Estados Unidos, le asigna un propósito preciso [3]. Según ese manual, el histograma sirve para resumir con un gráfico la distribución de un conjunto de datos de una sola variable [3]. La distribución es la manera en que los valores se reparten: dónde se amontonan y dónde escasean.
Ese resumen muestra cinco rasgos, según el mismo manual: el centro de los datos, su dispersión, su asimetría, la presencia de valores atípicos y la presencia de varias modas [3]. La asimetría aparece cuando una de las colas es más larga que la otra. Un valor atípico es un dato que queda lejos de todos los demás. Una moda es un pico marcado de la forma [4].
El libro abierto OpenIntro Statistics lo dice en términos sencillos: las barras más altas marcan dónde los datos son relativamente más comunes [4].
¿Cómo se hace un histograma? De los datos a los intervalos
Un histograma se construye en cuatro pasos. Los tres primeros son de cálculo; el último es el dibujo. El manual del NIST describe la forma más común así [3]:
- Tome el rango de los datos, del valor más pequeño al más grande. En las esperas del géiser, va de 43 a 96 minutos.
- Parta ese rango en intervalos del mismo ancho. El ancho lo puede escoger quien grafica o una regla sistemática [3].
- Cuente cuántos datos caen en cada intervalo. Cada dato va a un solo intervalo. Para los que caen justo en un borde, cada libro o programa fija una convención; OpenIntro, por ejemplo, los asigna al intervalo de abajo [4].
- Dibuje una barra por intervalo, pegada a la siguiente, con la altura igual al conteo. Ese conteo se llama frecuencia, y va en el eje vertical [3].
El conteo del paso 3 es una tabla de frecuencias, que tendrá su propia guía.
El eje vertical admite dos variantes, según el NIST [3]. En el histograma relativo, cada conteo se divide por el total de datos, y las alturas pasan a ser proporciones que suman uno. En la otra, el conteo se divide también por el ancho del intervalo: así, el área total de las barras vale uno. Esa segunda versión es la indicada cuando se quiere poner encima una curva de densidad, de la que se habla más abajo [3].
¿Cómo se interpreta un histograma?
Para leer un histograma, se mira la silueta antes que cualquier barra suelta. Cuatro preguntas ordenan esa lectura, y salen de las que propone el manual del NIST [3]:
- ¿Dónde está el centro? Es la zona de las barras más altas.
- ¿Qué tan repartidos están los datos? Una silueta angosta indica valores parecidos; una ancha, valores muy distintos.
- ¿Es simétrico o tiene una cola más larga? Una cola larga hacia la derecha indica unos pocos valores muy altos [4].
- ¿Hay barras sueltas, lejos del resto? Pueden ser valores atípicos, y conviene mirarlos uno por uno.
La quinta pregunta es cuántas jorobas tiene la silueta. OpenIntro llama unimodal a la forma con un pico prominente, bimodal a la de dos y multimodal a la de más de dos [4]. El libro hace una advertencia útil: un segundo pico que solo se diferencia de sus vecinos por unas pocas observaciones no cuenta como moda [4].
Esa advertencia es la clave de lo que sigue. Ponerles número a la forma, con medidas como la asimetría y la curtosis, es trabajo de la estadística para ciencia de datos. El diagrama de caja, otro gráfico que el NIST lista junto al histograma [3], tendrá su propia guía.
¿Cuántos intervalos debe tener un histograma? El mismo dato, dibujado tres veces
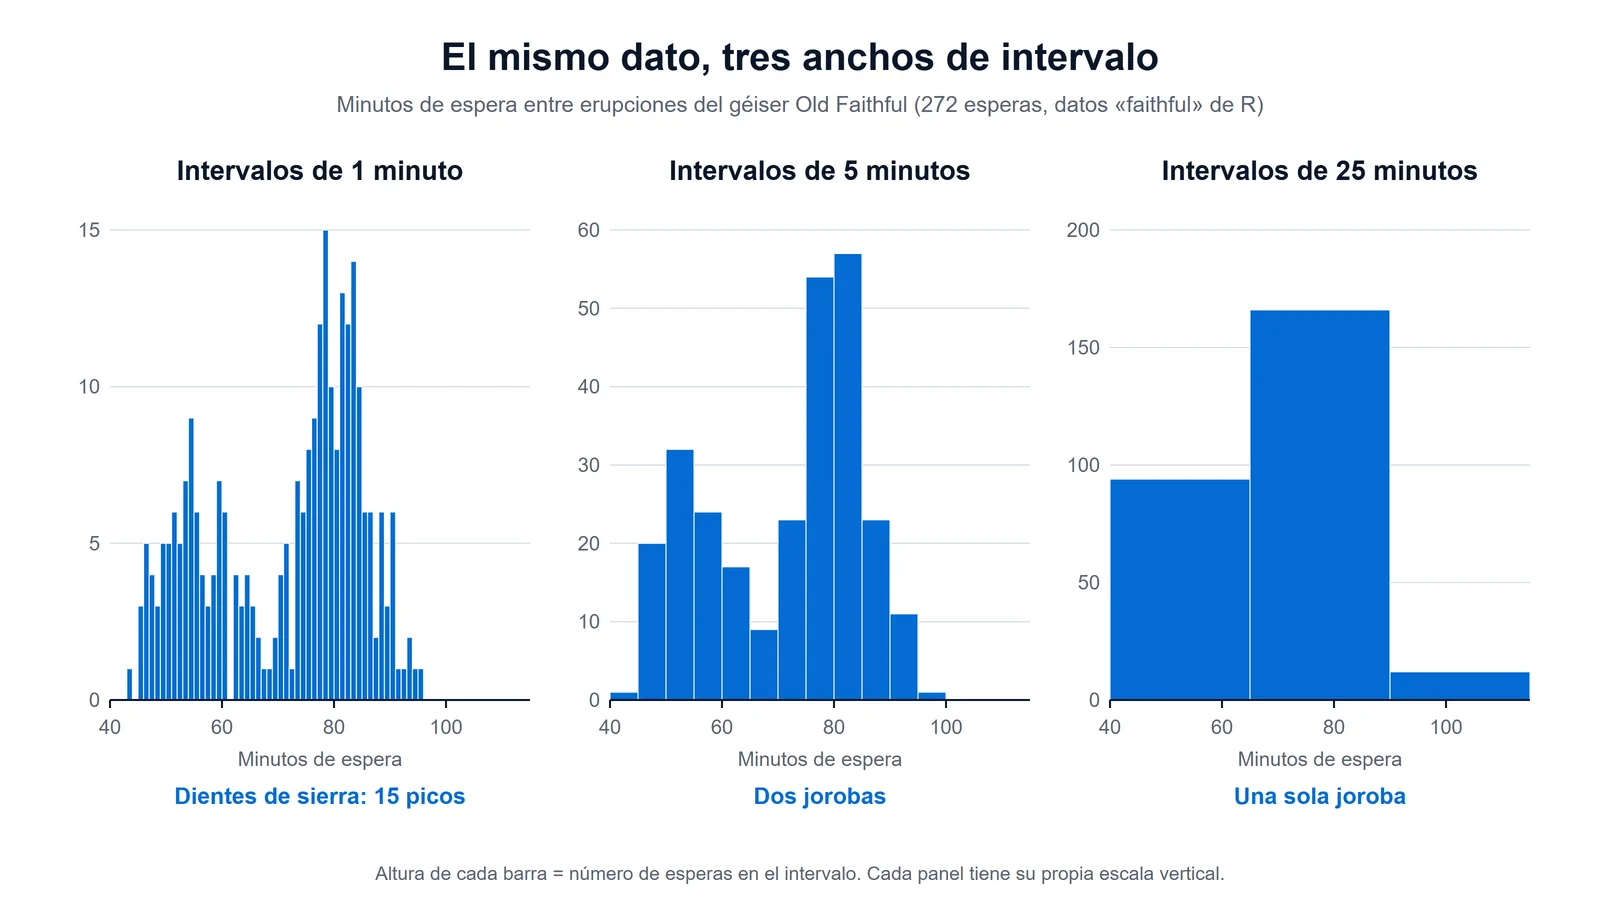
El número de intervalos no es un detalle de formato: decide qué forma ve el lector. Para mostrarlo, dibujé las 272 esperas del géiser tres veces [2]. Los datos son los mismos en los tres paneles. Solo cambia el ancho de los intervalos, y todos arrancan en 40 minutos.
| Ancho del intervalo | Intervalos, desde 40 minutos | Lo que se ve |
|---|---|---|
| 1 minuto | 56 | Dientes de sierra: 15 barras más altas que sus dos vecinas y huecos sueltos, como el de 61 minutos |
| 5 minutos | 12 | Dos jorobas: la más alta entre 80 y 85 minutos (57 esperas) y otra entre 50 y 55 minutos (32 esperas) |
| 25 minutos | 3 | Una sola joroba: 166 de las 272 esperas caen en el intervalo de 65 a 90 minutos |
Fuente: cálculo propio con los datos faithful del proyecto R [2].
Con intervalos de un minuto, el gráfico tiembla. Cada barra recoge tan pocos datos que el azar las sube y las baja, y aparecen quince picos que nadie llamaría grupos. Con intervalos de cinco minutos aparece lo mismo que describe el parque: esperas cortas y esperas largas [1]. Con intervalos de 25 minutos, los dos grupos se funden en un solo bloque.
Tres anchos, tres conclusiones.
La documentación de seaborn, una librería de gráficos para Python, lo resume en una frase. Allí se advierte que «usar un tamaño de intervalo equivocado puede engañar, porque oculta rasgos importantes de los datos o crea rasgos aparentes a partir de la variabilidad aleatoria» [5]. La traducción del inglés es mía.
Existen reglas automáticas para escoger cuántos intervalos usar, como las de Sturges, Scott o Freedman-Diaconis. La documentación de seaborn pide no depender demasiado de los tamaños automáticos, porque se basan en supuestos sobre la estructura de los datos [5]. Su consejo práctico es comprobar que la impresión sobre la forma se mantiene con distintos tamaños de intervalo [5].
Histograma vs gráfico de barras: ¿en qué se diferencian?
Los dos usan barras, y por eso se confunden. La diferencia está en lo que hay en el eje horizontal. En el histograma hay una escala numérica partida en tramos; en el gráfico de barras hay categorías con nombre, como departamentos, productos o tipos de vivienda.
| Histograma | Gráfico de barras | |
|---|---|---|
| Qué variable muestra | Una variable numérica medida, de una sola variable a la vez [3] | Una variable categórica, es decir, de grupos con nombre [4] |
| Qué hay en el eje horizontal | La escala de la variable, dividida en intervalos [3][5] | Las categorías, una por barra [4] |
| Separación entre barras | Pegadas, porque los intervalos parten el rango sin dejar espacios [3] | Separadas; seaborn sugiere angostarlas cuando el eje es de categorías [5] |
| Orden de las barras | Fijo: el de la escala numérica | Libre cuando las categorías no tienen un orden propio; por ejemplo, de mayor a menor |
| Qué pasa si cambia el ancho | Cambia la forma, y puede cambiar la conclusión [5] | Nada importante: el ancho es solo estética |
| Qué se lee | La forma: centro, dispersión, asimetría, atípicos y modas [3] | La comparación de conteos o proporciones entre categorías [4] |
Una prueba rápida sirve para no equivocarse. Si las barras se pueden reordenar sin mentir, es un gráfico de barras. Si moverlas rompe la escala, es un histograma. Las ventas por departamento van en barras; los tiempos de entrega de esas mismas ventas, en histograma.
La curva de densidad (KDE): el histograma suavizado
La curva de densidad reemplaza las barras por una línea continua que sube donde hay muchos datos y baja donde hay pocos. Su nombre técnico es estimación de densidad por núcleos, o KDE por su sigla en inglés (kernel density estimation). La documentación de seaborn la describe como un método para ver la distribución de un conjunto de datos, análogo al histograma [6].
La idea cabe en una imagen. En lugar de contar datos dentro de intervalos, la curva pone una pequeña campana sobre cada dato y luego las promedia todas en una sola curva [5][7]. A esa campana se le llama núcleo gaussiano. Su ancho, llamado ancho de banda, cumple el mismo papel que el ancho del intervalo en el histograma [6].
La advertencia también es la misma. Si el ancho de banda está mal escogido, la representación de los datos sale distorsionada [6]. Una curva demasiado suave puede borrar rasgos reales de la distribución. Una curva poco suavizada puede crear rasgos falsos a partir de la variabilidad aleatoria [6].
Lo probé con las esperas del géiser. Usé el ancho de banda que SciPy, una librería de cálculo científico para Python, aplica por defecto: la regla de Scott [7]. Con él, la curva marca dos picos, cerca de 54 y de 80 minutos. Con el triple de ese ancho, queda un solo pico, cerca de 76 minutos.
La documentación de SciPy anticipa este resultado. Su versión 1.18.0 advierte que el método funciona mejor con distribuciones de un solo pico y que las de dos o más tienden a quedar demasiado suavizadas [7]. Seaborn, en su versión 0.13.2, añade dos cuidados: la curva siempre sale suave, aunque los datos no lo sean, y puede invadir valores imposibles, como tiempos negativos [6].
¿Cómo se hace un histograma en Python o en Excel?
Las instrucciones paso a paso dependen de la herramienta. Cómo se programa un histograma con las librerías de gráficos está en la guía de Python para el análisis de datos. Si trabaja en hoja de cálculo, el punto de partida es la guía de Excel para el análisis de datos.
Aquí importa la decisión que ninguna de las dos toma por usted: el ancho del intervalo. Para escoger entre el histograma y otros gráficos sirve la guía de tipos de gráficos. El panorama completo está en visualización de datos.
¿Quién decide lo que muestra un histograma?
El géiser no cambió entre el primer panel y el tercero. Cambió una sola decisión, el ancho del intervalo, y con ella la historia que cuenta el gráfico: quince picos, dos grupos o uno.
Voy a tomar partido, sabiendo que es una postura y no una regla: ningún histograma debería publicarse sin haberlo dibujado antes con al menos tres anchos distintos. El programa propone uno por defecto. Aceptarlo sin mirar es dejar que una regla automática decida qué ve el lector.
Esto pesa más cuando el gráfico informa una decisión pública. Un tiempo de espera promedio puede esconder dos poblaciones, una que espera poco y otra que espera mucho. El histograma bien dibujado las muestra; uno con intervalos demasiado anchos las funde y le entrega al lector un promedio que no le pasa a nadie.
La próxima vez que un programa le proponga un histograma, cambie el ancho dos veces antes de creerle. Si la forma se sostiene, ya tiene un hallazgo. Si no, tiene una pregunta mejor.
Preguntas frecuentes
¿Puede un histograma tener espacios entre las barras? Sí, cuando un intervalo queda vacío. En las esperas del géiser, con intervalos de un minuto, ninguna de las 272 esperas fue de 61 minutos, y en ese punto aparece un hueco [2]. Ese hueco es información, no un error de diseño. Con intervalos más anchos, el mismo hueco desaparece.
¿Qué va en el eje vertical de un histograma? Lo más común es el número de datos de cada intervalo. También puede ir la proporción del total, o una densidad ajustada para que el área de todas las barras sume uno. En la densidad, una altura mayor que uno no es un error [3].
¿Qué es un histograma acumulado? Es una variante en la que cada barra suma su conteo y el de todos los intervalos anteriores [3]. Por eso las barras nunca bajan: crecen hasta llegar al total de datos. Sirve para responder cuántos casos quedan por debajo de un valor.
¿Se puede hacer un histograma con datos de categorías, como colores o ciudades? Algunos programas lo permiten, pero el resultado es en la práctica un gráfico de barras. Seaborn, por ejemplo, sugiere angostar un poco esas barras para que se note que el eje es de categorías [5].
¿Conviene mostrar a la vez el histograma y la curva de densidad? Puede servir como punto intermedio. La documentación de seaborn presenta esa combinación, con la curva dibujada sobre las barras [5]. Para que ambas estén en la misma escala, las barras deben ir en densidad, con área total igual a uno [3].
Referencias
- National Park Service (Servicio de Parques Nacionales de Estados Unidos). Explore Old Faithful, Yellowstone National Park — matemáticos, estadísticos y observadores mostraron una relación entre la duración de una erupción del Old Faithful y la longitud del intervalo siguiente; una erupción corta descarga menos agua y calor y se recarga pronto, una larga requiere más tiempo; después del terremoto de Hebgen Lake (1959) el géiser empezó a hacer erupción con dos intervalos distintos, uno corto y uno largo; el intervalo promedio ha aumentado con el tiempo. NPS: Explore Old Faithful — Consultada: 2026-11-06.
- R Core Team. faithful: Old Faithful Geyser Data, paquete datasets de R (versión 4.6.0 de la documentación), y archivo de datos del paquete — tiempo de espera hasta la siguiente erupción y duración de la erupción del géiser Old Faithful; 272 observaciones de 2 variables, en minutos; fuente: W. Härdle; existen varias versiones del conjunto. Con la columna de esperas el autor calculó el rango (43 a 96 minutos), el promedio (70,9), los tres histogramas, los intervalos vacíos y la curva de densidad. R: documentación de faithful {datasets} · R Project: datos de faithful — Consultada: 2026-11-06.
- NIST/SEMATECH. e-Handbook of Statistical Methods, sección 1.3.3.14, Histogram — propósito: resumir gráficamente la distribución de un conjunto de datos univariado; muestra centro, dispersión, asimetría, valores atípicos y presencia de varias modas; definición: dividir el rango en intervalos de igual tamaño (clases) y contar los puntos de cada uno; eje vertical, frecuencia; eje horizontal, la variable de respuesta; las clases las fija el usuario o una regla sistemática (reglas propuestas por Scott); histograma acumulado; histograma relativo normalizado por el total o por el total por el ancho de clase (área igual a uno, apropiado para superponer una función de densidad; admite frecuencias relativas mayores que uno); técnicas relacionadas: diagrama de caja y gráfico de probabilidad. NIST: e-Handbook, Histogram — Consultada: 2026-11-06.
- Diez, David; Çetinkaya-Rundel, Mine, y Barr, Christopher D. OpenIntro Statistics, 4.ª edición, 2019 (actualizada en 2022), secciones 2.1.3 Histograms and shape y 2.2.1 Contingency tables and bar plots — los valores se agrupan en intervalos y los conteos se dibujan como barras; las observaciones que caen en el borde de un intervalo se asignan al intervalo inferior; las barras más altas indican dónde los datos son relativamente más comunes; cola larga a la derecha; una moda es un pico prominente; distribuciones unimodal, bimodal y multimodal; un pico que solo difiere de sus vecinos por pocas observaciones no se cuenta; el gráfico de barras es una forma común de mostrar una variable categórica, con conteos o proporciones. OpenIntro: OpenIntro Statistics — Consultada: 2026-11-06.
- Waskom, Michael. Visualizing distributions of data, guía de usuario de seaborn 0.13.2 — un histograma divide el eje de la variable en intervalos y muestra con la altura de cada barra el conteo de observaciones; «using the wrong bin size can mislead by obscuring important features of the data or by creating apparent features out of random variability»; no depender demasiado de los tamaños automáticos, porque se basan en supuestos sobre la estructura de los datos; comprobar que la impresión se mantiene con distintos tamaños de intervalo; para variables categóricas, angostar las barras para enfatizar la naturaleza categórica del eje; la KDE suaviza las observaciones con un núcleo gaussiano en lugar de usar intervalos; se pueden combinar histograma y curva. seaborn: Visualizing distributions of data — Consultada: 2026-11-06.
- Waskom, Michael. seaborn.kdeplot, documentación de seaborn 0.13.2 — la KDE es un método para visualizar la distribución de observaciones, análogo al histograma, con una curva continua de densidad; el ancho de banda es la desviación estándar del núcleo de suavizado; si se especifica mal, la representación sale distorsionada; una curva sobresuavizada puede borrar rasgos reales y una poco suavizada puede crear rasgos falsos a partir de la variabilidad aleatoria; la regla por defecto funciona mejor con distribuciones suaves, de un pico y con forma aproximada de campana; la curva puede extenderse a valores negativos en datos naturalmente positivos; siempre produce una curva suave. seaborn: kdeplot — Consultada: 2026-11-06.
- The SciPy community. scipy.stats.gaussian_kde, manual de SciPy 1.18.0 — representación de una estimación de densidad por núcleos con núcleos gaussianos; incluye determinación automática del ancho de banda, por defecto la regla de Scott; la estimación funciona mejor con una distribución unimodal y las bimodales o multimodales tienden a quedar sobresuavizadas; la elección del ancho de banda influye mucho más que la forma del núcleo. SciPy: gaussian_kde — Consultada: 2026-11-06.
Cómo investigamos esta página
- Pregunta que responde: Qué es un histograma, cómo se construye y se lee, cómo el ancho del intervalo cambia la conclusión y en qué se diferencia de un gráfico de barras.
- Fuentes: identificadas 12 → incluidas 7
- Criterios de inclusión: manual del NIST, libro abierto OpenIntro, documentación oficial de seaborn, SciPy y R, y el Servicio de Parques Nacionales; ninguna enciclopedia, blog ni curso.
- Fecha de corte de los datos: 2026-11-06