
Apache Hadoop: el sistema que hizo barato procesar lo que no cabía
Apache Hadoop es un programa gratuito y de código abierto que une muchos computadores comunes para guardar y procesar juntos datos que no caben en uno solo. Su idea central es llevar el cálculo a la máquina donde ya está el dato. El proyecto sigue activo en 2026, aunque en la nube convive con otras herramientas.
Última actualización: 2026-11-11
Contenido de esta página
En 2004, los ingenieros de Yahoo! empezaron a investigar una forma de programar llamada MapReduce, montada sobre un sistema de archivos repartido entre muchas máquinas [1]. Era la combinación que Google había descrito en dos artículos de 2003 y 2004 [5][6]. En 2006 nació el proyecto Apache Hadoop [1].
A finales de 2006, Yahoo! ya lo usaba por dentro y tenía un clúster de 300 nodos para desarrollo [1]. Un clúster es un grupo de computadores conectados que trabajan como uno solo; cada computador es un nodo.
Su aplicación estrella era el Web Map, un índice de la web que era pieza crítica del buscador de la empresa [1]. Construirlo tomaba 75 horas y generaba 500 terabytes de datos intermedios, es decir, quinientos mil gigabytes de cálculos a medio camino [1].
Para 2010, los clústeres de Hadoop de Yahoo! sumaban 25.000 servidores y 25 petabytes (25 millones de gigabytes) de datos [1].
Ese es el oficio de Hadoop: juntar muchas máquinas baratas para que guarden y procesen como si fueran una.
¿Qué es Apache Hadoop?
Apache Hadoop es un software gratuito que reparte el almacenamiento y el cálculo de un conjunto de datos entre muchos computadores. Su documentación lo define como un marco de trabajo, es decir, un conjunto de programas que ya resuelve lo difícil y al que cada usuario le pone su propia lógica [2]. Ese marco permite procesar grandes conjuntos de datos repartidos en clústeres con modelos de programación sencillos [2].
Está diseñado para crecer desde un solo servidor hasta miles de máquinas, cada una con su propio cálculo y su propio disco [2]. Es un proyecto de la Fundación Apache, de código abierto, o sea, con el código fuente publicado para que cualquiera lo use y lo modifique, bajo la licencia Apache 2.0 [2][4].
Hay un rasgo que lo define más que el tamaño. Hadoop no confía en que el hardware nunca falle. La propia biblioteca está hecha para detectar y manejar las fallas, de modo que el servicio siga disponible aunque alguna máquina se dañe [2].
La versión más reciente es la 3.5.0, publicada el 2 de abril de 2026 y presentada como la primera versión estable de la línea 3.5 [2][3].
¿Qué problema resolvió Hadoop?
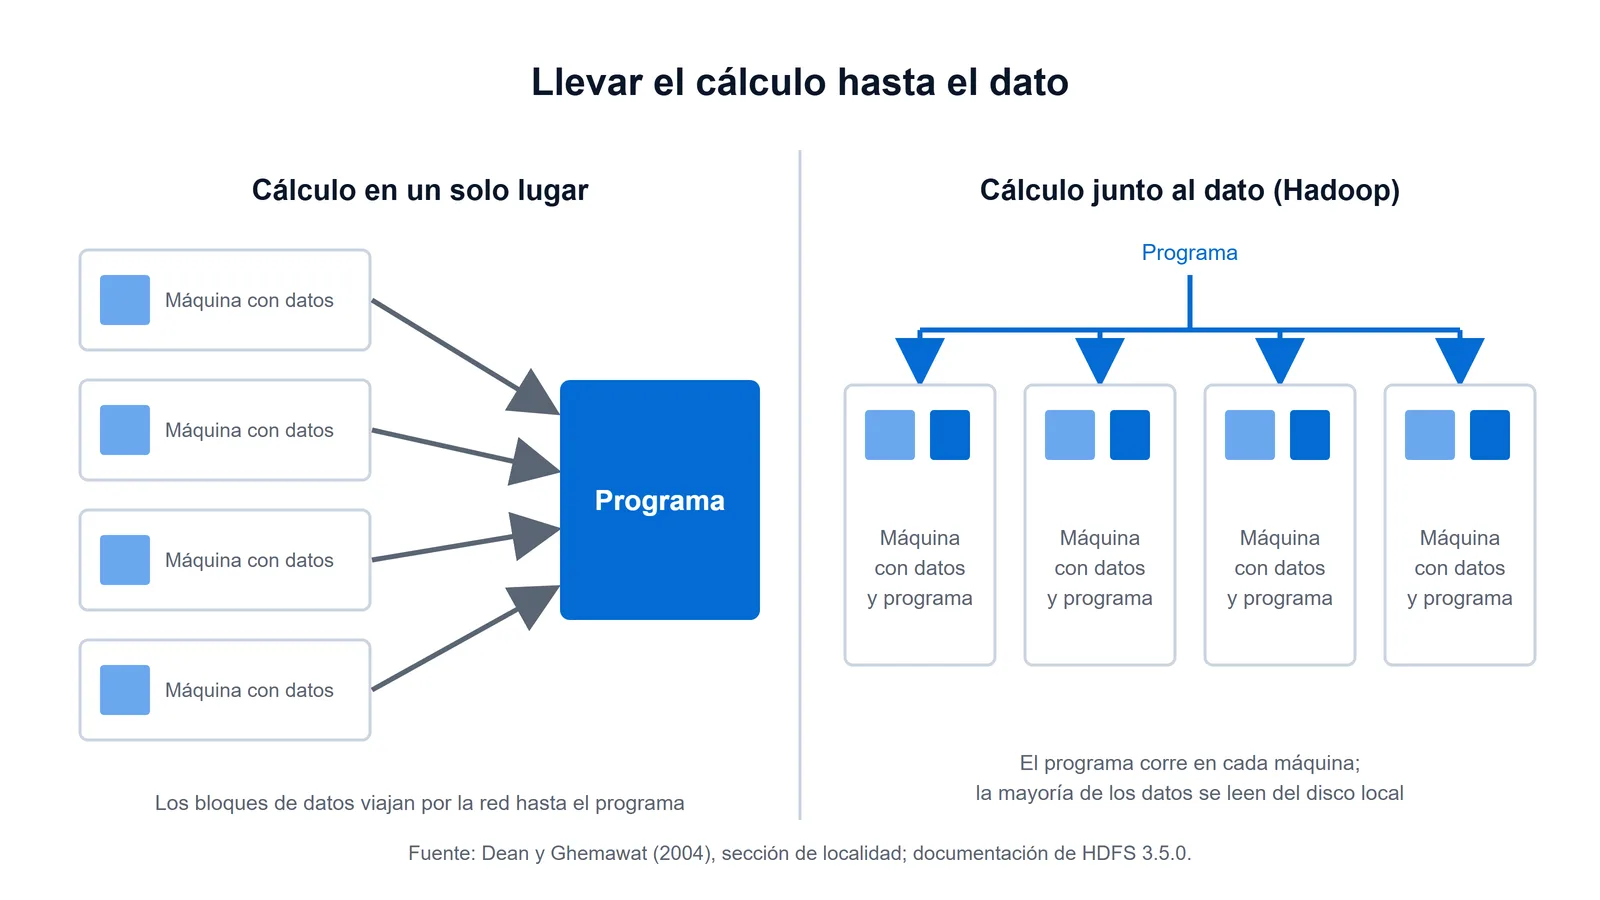
Hadoop resolvió un problema de costo y de transporte. Había que procesar datos enormes sin comprar una supercomputadora y sin mover esos datos por la red.
La respuesta fue usar muchas máquinas comunes y llevar el programa a cada una, en vez de traer los datos a una sola.
La idea venía de dos artículos de ingenieros de Google. El primero describió el Google File System, un sistema de archivos repartido entre muchas máquinas para aplicaciones que manejan muchos datos [5]. Sus autores dicen que ofrece tolerancia a fallas mientras corre sobre hardware común y económico [5]. Su arquitectura tenía un solo maestro y varios servidores que guardaban los pedazos de cada archivo [5].
El segundo artículo, de Jeffrey Dean y Sanjay Ghemawat, presentó MapReduce en 2004 [6]. En una de sus lecciones finales escribieron que «el ancho de banda de la red es un recurso escaso» [6]. El ancho de banda es la cantidad de datos que la red alcanza a mover por segundo.
Por eso su sistema intentaba programar cada tarea map en una máquina que ya tuviera una copia de los datos que iba a procesar [6]. Si no podía, buscaba una máquina cercana, conectada al mismo equipo de red [6]. Así, en las operaciones grandes que ocupan buena parte del clúster, la mayoría de los datos de entrada se leían del disco local [6]. No consumían red.
Piense en la cosecha de café de una vereda. Se puede subir cada bulto hasta una trilladora en el pueblo, o llevar una trilladora pequeña a cada finca y bajar solo el grano listo. Hadoop eligió la segunda.
En 2010, cuatro ingenieros de Yahoo! publicaron un artículo sobre el sistema de archivos de Hadoop [1]. Sus autores fueron Konstantin Shvachko, Hairong Kuang, Sanjay Radia y Robert Chansler. Así resumieron la apuesta económica: «al distribuir el almacenamiento y el cálculo entre muchos servidores, el recurso puede crecer con la demanda sin dejar de ser económico en cualquier tamaño» [1].
| Fuente | Año y evento | Qué aportó a la idea de Hadoop |
|---|---|---|
| Ghemawat, Gobioff y Leung, The Google File System [5] | 2003, SOSP (simposio de sistemas operativos) | Un sistema de archivos repartido, tolerante a fallas, sobre hardware común y económico |
| Dean y Ghemawat, MapReduce [6] | 2004, OSDI (simposio de diseño de sistemas operativos) | Un modelo de programación que reparte el cálculo y prefiere procesar donde ya está el dato |
| Shvachko, Kuang, Radia y Chansler, The Hadoop Distributed File System [1] | 2010, MSST (simposio de sistemas de almacenamiento masivo) | La arquitectura del sistema de archivos de Hadoop y la experiencia de operarlo en Yahoo! |
¿Cómo funciona Hadoop? Sus tres componentes principales
Hadoop funciona con tres piezas que se reparten el trabajo: una guarda los datos, otra asigna las máquinas y la tercera ejecuta el cálculo. La documentación oficial lista además un cuarto módulo, Hadoop Common, con las utilidades que comparten los otros tres [2].
| Componente | Qué hace | De dónde viene y quién lo mantiene |
|---|---|---|
| HDFS (sistema de archivos distribuido de Hadoop) | Guarda archivos grandes repartidos en bloques entre muchas máquinas, con acceso de alto rendimiento [2] | Nació como infraestructura de Apache Nutch, un proyecto de buscador web [7]; según sus autores de 2010, Yahoo! desarrolló y aportó el 80 % del núcleo de HDFS y MapReduce [1] |
| YARN (el gestor de recursos de Hadoop) | Asigna memoria y procesador del clúster y programa las tareas [2][8] | Separó la gestión de recursos del cálculo; los trabajos de MapReduce de la versión 1 deberían seguir corriendo sobre él sin cambios con solo recompilarlos [8] |
| MapReduce | Procesa en paralelo grandes conjuntos de datos sobre YARN [2] | Sigue el modelo MapReduce que Google describió en 2004 [1][6] |
| Hadoop Common | Reúne las utilidades comunes que usan los demás módulos [2] | Forma parte del mismo proyecto [2] |
Los cuatro módulos los mantiene hoy la comunidad del proyecto Apache Hadoop, dentro de la Fundación Apache [2].
Cada uno de los tres principales tendrá su guía detallada, con su funcionamiento interno. Aquí basta saber qué papel juega cada uno.
La arquitectura maestro-esclavo de Hadoop
Hadoop organiza sus máquinas en una jerarquía: unas pocas coordinan y muchas trabajan. La documentación de HDFS la llama arquitectura maestro-esclavo [7]. La de MapReduce usa otra palabra para el mismo papel: habla de un maestro y de trabajadores [9].
Un contenedor, en el lenguaje de YARN, es una porción de recursos de una máquina, como memoria y procesador, reservada para una tarea [8].
| Capa | Máquina que coordina (maestro) | Máquinas que trabajan | Qué hace cada una |
|---|---|---|---|
| Almacenamiento (HDFS) | NameNode, uno por clúster [7] | DataNodes, por lo general uno por nodo [7] | El NameNode lleva el registro de qué archivos existen y en qué máquinas está cada bloque; los DataNodes guardan los bloques y atienden las lecturas y escrituras [7] |
| Recursos y cálculo (YARN) | ResourceManager, la autoridad que reparte los recursos entre las aplicaciones [8] | NodeManagers, uno por máquina [8][9] | Cada NodeManager vigila los contenedores de su máquina y reporta su uso de procesador, memoria, disco y red [8] |
| Cada aplicación | ApplicationMaster, uno por aplicación [8] | Los contenedores que le asigna YARN [8] | Negocia recursos con el ResourceManager y sigue el avance de sus tareas [8] |
Hay un detalle de diseño que evita que el NameNode se vuelva un embudo. Los datos de los usuarios nunca pasan por él [7]. El NameNode sabe en qué máquinas está cada bloque, y son los DataNodes los que atienden las lecturas y escrituras [7].
La documentación también aclara el reparto físico. En una instalación típica, una máquina dedicada corre solo el NameNode y cada una de las demás corre un DataNode [7]. Y lo habitual es que los nodos que calculan sean los mismos que guardan: así el marco puede enviar cada tarea al nodo donde ya está su dato [9].
Un conteo de palabras para ver la idea (simulación en Python)
El ejemplo clásico para entender MapReduce es contar cuántas veces aparece cada palabra en un texto [6]. Hadoop permite escribir los dos pasos en cualquier lenguaje gracias a Hadoop Streaming, una utilidad que viene con Hadoop [10].
Con Streaming, el paso map y el paso reduce son programas comunes. Leen líneas por la entrada estándar, el canal por donde un programa recibe texto, y escriben por la salida estándar [10]. Por defecto, lo que va antes del primer tabulador de cada línea es la clave y lo que sigue es el valor [10].
El código de abajo es una simulación didáctica, no Hadoop real. Corre en un solo computador, sin instalar nada aparte de Python; lo probé con Python 3.11. Imita el contrato de Streaming para que se vean los tres momentos: map, orden por clave y reduce.
# Simulación didáctica del conteo de palabras al estilo map/reduce.
# NO es Hadoop: todo corre en un solo proceso de Python, en un solo computador.
# Imita a Hadoop Streaming: cada línea es la clave, un tabulador y el valor.
from itertools import groupby

# Tres "bloques" de texto, como si vivieran en tres máquinas distintas
bloques = [
    "café de Santander café de Huila",
    "cacao de Santander",
    "café de Nariño cacao de Tumaco",
]

def mapper(linea):
    # Paso map: por cada palabra emite el par (palabra, 1)
    for palabra in linea.lower().split():
        yield f"{palabra}\t1"

def reducer(lineas_ordenadas):
    # Paso reduce: suma los 1 de cada palabra (llegan juntas porque van ordenadas)
    pares = (linea.split("\t") for linea in lineas_ordenadas)
    for palabra, grupo in groupby(pares, key=lambda par: par[0]):
        yield f"{palabra}\t{sum(int(valor) for _, valor in grupo)}"

# 1. Cada bloque se procesa por separado (en Hadoop, en paralelo y junto al dato)
salidas_map = [par for bloque in bloques for par in mapper(bloque)]

# 2. El marco ordena por clave las salidas de todos los map
ordenadas = sorted(salidas_map)

# 3. El reduce recibe las claves agrupadas y entrega el total
for linea in reducer(ordenadas):
    print(linea)
La salida es una palabra por línea con su total: «café» aparece 3 veces, «cacao» 2 y «santander» 2. En un clúster real, cada bloque estaría en una máquina distinta y su map correría ahí mismo. El orden por clave lo haría el marco, que también reintenta las tareas que fallan [9].
¿Sigue vivo Hadoop en 2026?
Sí, el proyecto sigue vivo: su portada anuncia cinco versiones publicadas entre marzo de 2024 y abril de 2026 [2]. Pero conviene separar dos cosas que suelen mezclarse. Una es el proyecto Apache Hadoop, el software libre. La otra es el ecosistema de productos que lo empaquetan, que la propia Fundación reconoce cuando advierte que muchos terceros distribuyen productos que incluyen Hadoop [4].
El proyecto: versiones recientes y sus fechas
| Versión | Fecha de publicación | Lo que anunció el proyecto |
|---|---|---|
| 3.5.0 | 2 de abril de 2026 | Primera versión estable de la línea 3.5, con 485 correcciones y mejoras desde la 3.4 [2] |
| 3.4.3 | 24 de febrero de 2026 | Versión de la línea 3.4; pide actualizar a quienes usan la 3.4.2 o anteriores [2] |
| 3.4.2 | 29 de agosto de 2025 | Versión de la línea 3.4 [2] |
| 3.4.1 | 18 de octubre de 2024 | Versión de la línea 3.4 [2] |
| 3.4.0 | 17 de marzo de 2024 | Primera versión de la línea 3.4 [2] |
La 3.5.0 trae cambios que muestran hacia dónde mira el proyecto [3]. Es la primera con soporte completo para Java 17, una versión reciente de Java, el lenguaje en que está escrito Hadoop [3][9]. En los servidores, Java 17 pasa a ser obligatorio [3]. También trae una conexión propia con Google Cloud Storage, el servicio de almacenamiento de archivos de Google [3].
La nube: qué dicen Amazon, Google y Microsoft
Amazon, Google y Microsoft ofrecen Hadoop como servicio administrado, es decir, ellos montan y mantienen el clúster y el cliente lo usa. Esto es lo que dice la documentación de cada uno, consultada el 11 de noviembre de 2026.
| Proveedor y servicio | Qué dice su documentación |
|---|---|
| Amazon EMR (antes Amazon Elastic MapReduce) | Es una plataforma de clústeres administrados para correr marcos de big data como Hadoop y Spark (otro motor de cálculo distribuido) [19]. La versión más reciente de su serie 7 incluye Hadoop 3.4.2, identificado como 3.4.2-amzn-2 [13]. Por lo general, los datos de entrada son archivos en el sistema que elija el usuario, como Amazon S3, su almacenamiento de objetos, o HDFS [12] |
| Google: Managed Service for Apache Spark | Es el nombre nuevo del producto antes llamado Dataproc on Compute Engine [14]. Su conector permite correr trabajos de Hadoop o Spark directamente sobre Cloud Storage, sin pasar los datos a HDFS [15] |
| Microsoft: Azure HDInsight | Es un servicio administrado para correr Spark, Hive, Kafka, Hadoop y otros marcos de código abierto [16]. Su tipo de clúster Hadoop ofrece HDFS, YARN y MapReduce para procesar datos por lotes [17] |
Hay un patrón común en los tres. Los clústeres se pueden crear para un trabajo y apagar al terminar, y el dato puede vivir aparte, en un almacenamiento que no depende del clúster [12][14][16]. Google lo dice sin rodeos: cuando se apaga un clúster de Hadoop, a diferencia de HDFS, los datos en Cloud Storage siguen disponibles [15]. Microsoft lo presenta como separar el cálculo del almacenamiento [16].
Esa separación es el gran cambio frente al diseño clásico, en el que los nodos que calculan son los mismos que guardan [9]. Qué cambia al guardar los datos en un lago de objetos en vez de un sistema de archivos se explica en la guía de data lake.
El proyecto no es la distribución: lo que muestra la contratación pública en Colombia
En SECOP II, el sistema público de compras del Estado colombiano, busqué la palabra «hadoop» en los contratos publicados en datos abiertos [18]. La consulta, del 11 de noviembre de 2026, devolvió cinco contratos firmados entre 2018 y 2021 [18].
Los firmaron dos entidades nacionales: Coljuegos, que administra los juegos de suerte y azar, y la central administrativa del sector de inteligencia [18]. Los cinco contratan soporte, mantenimiento, suscripción o la renovación de licencias, y dos nombran la distribución comercial de la empresa Cloudera [18].
Apache Hadoop se descarga sin costo [4]. Lo que esos contratos describen es soporte, mantenimiento, suscripción y licencias, no la descarga del proyecto [18]. Una búsqueda por palabra encuentra solo los contratos que la escriben, así que cinco es un piso, no un censo.
Lo que esta página no afirma
Cuántas organizaciones usan Hadoop hoy, y si su uso sube o baja, es un dato que esta página no publica. Para afirmarlo haría falta una medición abierta, con fecha y alcance declarados, y no hubo una a mano el día de la consulta. Por eso aquí no se habla de cuota de mercado ni de declive.
Lo que sí se puede afirmar con fuentes es más modesto. El proyecto publica versiones con regularidad, Amazon, Google y Microsoft lo siguen ofreciendo, y uno de ellos rebautizó su servicio con el nombre de Spark [2][14][16][19].
¿Cuándo tiene sentido usar Hadoop hoy?
Hadoop tiene sentido cuando los datos son muy grandes, se procesan por lotes y conviene tener los servidores propios. Deja de tenerlo cuando se necesitan respuestas inmediatas o cuando nadie puede administrar y asegurar el clúster.
Estos son criterios de decisión míos, armados con lo que dice la documentación oficial. No son reglas del proyecto.
Tiene sentido cuando:
- Los archivos son grandes. HDFS está afinado para archivos que típicamente pesan de gigabytes a terabytes [7].
- El trabajo es por lotes, es decir, procesos largos que recorren todo el conjunto, y no consultas que deben contestar en segundos. HDFS prioriza mover muchos datos por segundo sobre responder rápido a cada pedido [7].
- Los datos se escriben una vez y se leen muchas. Es el modelo para el que se diseñó HDFS; un archivo ya cerrado solo admite añadir datos al final o recortarlo [7].
- Ya hay servidores propios, o una norma obliga a tener los datos en casa. Hadoop corre sobre Linux, el sistema operativo libre que su documentación nombra para desarrollo y producción, y se ha demostrado en clústeres de 2.000 nodos [11].
No tiene sentido cuando:
- Los datos caben en un computador. Hadoop puede correr en una sola máquina, pero su documentación presenta ese modo como útil para depurar [11]; sin varias máquinas no hay nada que repartir.
- El equipo no puede asegurarlo. La documentación advierte que, sin autenticación con Kerberos, un sistema que verifica quién se conecta, cualquiera con acceso a la red tiene acceso total a los datos [3].
- Los datos son tablas ordenadas para reportes del negocio. Para eso existe el data warehouse, donde los datos llegan limpios y listos para consultar.
- El clúster solo se usa unas horas al mes. Ahí pesa más alquilar el cálculo en la nube y guardar los datos aparte, como describen los proveedores [15].
La advertencia de seguridad merece una línea más. El proyecto avisa que, si alguien despliega un clúster inseguro, los escáneres de puertos, programas que recorren la red buscando servidores abiertos, lo encontrarán inevitablemente [3]. Y le enviarán trabajos de minería de criptomonedas [3].
Lo que Hadoop dejó
Hadoop puso tres ideas de diseño en un programa gratuito. Repartir los datos en bloques con copias, mandar el cálculo al dato y contar desde el principio con que las máquinas fallan [2][7]. Muchas piezas vecinas crecieron a su alrededor; una de ellas, HBase, es una base de datos para tablas muy grandes que el propio proyecto lista entre sus relacionados [2]. Qué tipo de base es y cuándo conviene se explica en la guía de bases de datos.
Las herramientas y el oficio que vinieron después, de los flujos de datos a los almacenes en la nube, son el terreno de la ingeniería de datos. Y el panorama completo de por qué el volumen obligó a cambiar de método está en la guía de big data.
Esto ya es opinión. Hadoop no está muerto, pero dejó de ser la puerta de entrada. Para una entidad colombiana que arranca en 2026, montar un clúster propio rara vez es el primer paso. El valor de aprender Hadoop está en entender por qué funciona: quien entiende el NameNode y el map entiende también lo que la nube le está cobrando.
Preguntas frecuentes
¿Hadoop es gratis? Sí. El proyecto publica su software bajo la licencia Apache 2.0, una licencia de código abierto, y se descarga sin costo [4]. Lo que sí cuesta es lo que se monta alrededor: servidores, personal que lo administre o el soporte de una distribución comercial. En Colombia, por ejemplo, hay entidades públicas que han firmado contratos de soporte y licencias asociados a Hadoop [18].
¿Hay que saber Java para usar Hadoop? No necesariamente. Hadoop está escrito en Java, pero sus aplicaciones de MapReduce no tienen que estarlo [9]. Con Hadoop Streaming se puede usar como paso map o reduce cualquier programa ejecutable, por ejemplo un guion de Python [10]. Para instalarlo y operarlo, eso sí, hay que tener Java en las máquinas [11].
¿Se puede instalar Hadoop en un solo computador? Sí, de dos maneras. En el modo local corre como un único proceso de Java, útil para depurar [11]. En el modo pseudodistribuido cada pieza corre como un proceso aparte en la misma máquina, lo que permite practicar con HDFS sin tener un clúster [11]. El tercer modo, totalmente distribuido, es el que usa varias máquinas [11].
¿Hadoop es una base de datos? No. Hadoop es un marco para guardar archivos y procesarlos en paralelo; no ofrece tablas con consultas inmediatas como una base de datos tradicional. HDFS, su sistema de archivos, está pensado para procesos por lotes y no para el uso interactivo [7]. Para tablas muy grandes, la Fundación Apache tiene un proyecto relacionado, HBase, una base de datos distribuida [2].
¿Qué versión de Hadoop conviene instalar en 2026? Si lo instala por su cuenta, la más reciente es la 3.5.0, que el proyecto presenta como la primera versión estable de su línea [2][3]. Antes de elegirla, revise que sus servidores tengan Java 17, que esta versión exige del lado del servidor [3]. Si un proveedor de nube le administra el clúster, la versión la fija él; Amazon EMR, por ejemplo, trae la 3.4.2 en la versión más reciente de su serie 7 [13].
Referencias
Las citas en otro idioma son traducción propia.
- Shvachko, Konstantin; Kuang, Hairong; Radia, Sanjay; Chansler, Robert (Yahoo!). The Hadoop Distributed File System, 2010 IEEE 26th Symposium on Mass Storage Systems and Technologies (MSST), mayo de 2010, pp. 1-10 — Yahoo! empezó a investigar MapReduce con un sistema de archivos distribuido en 2004; el proyecto Apache Hadoop se fundó en 2006 y a finales de ese año Yahoo! tenía un clúster de 300 nodos para desarrollo; el Web Map tomaba 75 horas con 500 terabytes de datos intermedios; clústeres de 25.000 servidores y 25 petabytes; «By distributing storage and computation across many servers, the resource can grow with demand while remaining economical at every size»; Yahoo! desarrolló y aportó el 80 % del núcleo de Hadoop (HDFS y MapReduce). IEEE: The Hadoop Distributed File System (DOI) · Copia del artículo en el sitio del congreso MSST — Consultada: 2026-11-11.
- The Apache Software Foundation. Apache Hadoop, portada del proyecto — software de código abierto para computación distribuida confiable y escalable; marco para el procesamiento distribuido de grandes conjuntos de datos en clústeres con modelos de programación sencillos; escala de un servidor a miles de máquinas con cálculo y almacenamiento locales; la biblioteca detecta y maneja las fallas en la capa de aplicación; módulos Hadoop Common, HDFS, YARN y MapReduce; noticias de las versiones 3.5.0 (2 de abril de 2026, primera estable de la línea 3.5, 485 correcciones y mejoras), 3.4.3 (24 de febrero de 2026), 3.4.2 (29 de agosto de 2025), 3.4.1 (18 de octubre de 2024) y 3.4.0 (17 de marzo de 2024); HBase entre los proyectos relacionados. Apache Hadoop: portada del proyecto — Consultada: 2026-11-11.
- The Apache Software Foundation. Apache Hadoop 3.5.0, página de inicio de la documentación (publicada el 3 de abril de 2026) — primera versión estable de la línea 3.5; primera con soporte completo de Java 17, obligatorio en el servidor; implementación de sistema de archivos para Google Cloud Storage; advertencia de seguridad sobre clústeres sin autenticación Kerberos y sobre trabajos de minería de criptomonedas en clústeres inseguros. Apache Hadoop: documentación 3.5.0 — Consultada: 2026-11-11.
- The Apache Software Foundation. Apache Hadoop Releases — versiones 3.5.0, 3.4.3, 3.3.6 y 2.10.2 con sus fechas; software con licencia Apache 2.0; muchos terceros distribuyen productos que incluyen Apache Hadoop. Apache Hadoop: página de versiones — Consultada: 2026-11-11.
- Ghemawat, Sanjay; Gobioff, Howard; Leung, Shun-Tak (Google). The Google File System, SOSP 2003 (octubre de 2003) — sistema de archivos distribuido y escalable para aplicaciones con uso intensivo de datos; tolerancia a fallas sobre hardware común y económico; un clúster con un solo maestro y varios servidores de pedazos de archivo. Google Research: The Google File System — Consultada: 2026-11-11.
- Dean, Jeffrey; Ghemawat, Sanjay (Google). MapReduce: Simplified Data Processing on Large Clusters, OSDI 2004 — modelo de programación con funciones map y reduce; ejemplo de conteo de palabras; sección de localidad: el maestro intenta programar cada tarea map en una máquina con una réplica de sus datos o cerca de ella, y en operaciones grandes la mayoría de los datos de entrada se leen localmente sin consumir red; conclusión: «network bandwidth is a scarce resource». Google Research: MapReduce, Simplified Data Processing on Large Clusters — Consultada: 2026-11-11.
- The Apache Software Foundation. HDFS Architecture, documentación de Apache Hadoop 3.5.0 (publicada el 24 de marzo de 2026) — HDFS nació como infraestructura del proyecto Apache Nutch; diseñado para hardware de bajo costo; más para procesamiento por lotes que para uso interactivo, con prioridad al rendimiento sobre la latencia; archivo típico de gigabytes a terabytes; modelo de escribir una vez y leer muchas; arquitectura maestro-esclavo con un NameNode y DataNodes, por lo general uno por nodo; los datos de usuario nunca pasan por el NameNode; despliegue típico con una máquina dedicada al NameNode. Apache Hadoop: HDFS Architecture 3.5.0 — Consultada: 2026-11-11.
- The Apache Software Foundation. Apache Hadoop YARN, documentación de Apache Hadoop 3.5.0 (publicada el 24 de marzo de 2026) — separa la gestión de recursos de la programación y el seguimiento de tareas; ResourceManager global como autoridad que reparte los recursos; NodeManager por máquina, responsable de los contenedores y de reportar su uso de procesador, memoria, disco y red; ApplicationMaster por aplicación; los trabajos de MapReduce de hadoop-1.x corren sobre YARN con solo recompilarlos. Apache Hadoop: YARN Architecture 3.5.0 — Consultada: 2026-11-11.
- The Apache Software Foundation. MapReduce Tutorial, documentación de Apache Hadoop 3.5.0 (publicada el 24 de marzo de 2026) — por lo común los nodos de cálculo y de almacenamiento son los mismos, lo que permite programar las tareas donde ya están los datos; un ResourceManager maestro y un NodeManager trabajador por nodo; el marco ordena las salidas de los map y reejecuta las tareas que fallan; el marco está escrito en Java, pero las aplicaciones no tienen que estarlo. Apache Hadoop: MapReduce Tutorial 3.5.0 — Consultada: 2026-11-11.
- The Apache Software Foundation. Hadoop Streaming, documentación de Apache Hadoop 3.5.0 — utilidad incluida en Hadoop para crear trabajos con cualquier ejecutable o guion como mapper o reducer; leen la entrada estándar línea por línea y escriben en la salida estándar; por defecto, lo anterior al primer tabulador es la clave y el resto es el valor. Apache Hadoop: Hadoop Streaming 3.5.0 — Consultada: 2026-11-11.
- The Apache Software Foundation. Hadoop: Setting up a Single Node Cluster, documentación de Apache Hadoop 3.5.0 — GNU/Linux como plataforma de desarrollo y producción, demostrada en clústeres de 2.000 nodos; Java obligatorio; modos local, pseudodistribuido y totalmente distribuido; el modo local corre como un único proceso de Java y sirve para depurar. Apache Hadoop: Single Node Setup 3.5.0 — Consultada: 2026-11-11.
- Amazon Web Services. Overview of Amazon EMR, Amazon EMR Management Guide — nodos primario, central (core) y de tareas; clústeres que procesan una cantidad fija de datos y terminan al completar el trabajo; por lo general la entrada son archivos en el sistema de archivos elegido, como Amazon S3 o HDFS. AWS: Overview of Amazon EMR — Consultada: 2026-11-11.
- Amazon Web Services. Apache Hadoop, Amazon EMR Release Guide — Hadoop corre en una sola instancia o en miles; la versión emr-7.14.0, la más reciente de la serie 7, incluye Hadoop 3.4.2-amzn-2. AWS: Apache Hadoop en Amazon EMR — Consultada: 2026-11-11.
- Google Cloud. Managed Service for Apache Spark on clusters overview (última actualización: 9 de noviembre de 2026) — «Managed Service for Apache Spark» es el nombre nuevo del producto antes llamado «Dataproc on Compute Engine» (clústeres) y «Google Cloud Serverless for Apache Spark»; clústeres de Spark y Hadoop administrados, que se pueden apagar cuando no se necesitan. Google Cloud: Managed Service for Apache Spark on clusters — Consultada: 2026-11-11.
- Google Cloud. Cloud Storage connector (última actualización: 9 de noviembre de 2026) — biblioteca de código abierto para correr trabajos de Apache Hadoop o Apache Spark directamente sobre datos en Cloud Storage, sin transferirlos antes a HDFS; al apagar un clúster de Hadoop, a diferencia de HDFS, los datos en Cloud Storage siguen accesibles. Google Cloud: Cloud Storage connector — Consultada: 2026-11-11.
- Microsoft. What is Azure HDInsight (fecha de la página: 24 de febrero de 2025) — servicio administrado de analítica de código abierto en la nube para Apache Spark, Apache Hive, LLAP, Apache Kafka, Apache Hadoop y otros; clústeres que se crean bajo demanda; separación del cálculo y el almacenamiento. Microsoft Learn: What is Azure HDInsight — Consultada: 2026-11-11.
- Microsoft. What is Apache Hadoop in Azure HDInsight? (fecha de la página: 28 de febrero de 2025) — el tipo de clúster Hadoop en HDInsight ofrece HDFS, YARN y un modelo sencillo de MapReduce para procesar datos por lotes en paralelo; compatible con Azure Data Lake Storage Gen2. Microsoft Learn: Apache Hadoop en Azure HDInsight — Consultada: 2026-11-11.
- Agencia Nacional de Contratación Pública (Colombia Compra Eficiente), publicado en el Portal de Datos Abiertos de Colombia. SECOP II – Contratos Electrónicos (identificador jbjy-vk9h; licencia Creative Commons Atribución-CompartirIgual 4.0) — la búsqueda de texto «hadoop» devolvió cinco contratos firmados entre 2018 y 2021 por Coljuegos (cuatro) y por la Central Administrativa y Contable Especializada de Inteligencia (uno), todos de soporte, mantenimiento, suscripción o licencias; dos nombran Cloudera. datos.gov.co: SECOP II, Contratos Electrónicos — Consultada: 2026-11-11.
- Amazon Web Services. What is Amazon EMR?, Amazon EMR Management Guide — Amazon EMR, antes llamado Amazon Elastic MapReduce, es una plataforma de clústeres administrados que simplifica correr marcos de big data como Apache Hadoop y Apache Spark en AWS. AWS: What is Amazon EMR? — Consultada: 2026-11-11.
Cómo investigamos esta página
- Pregunta que responde: Qué es Apache Hadoop, qué problema resolvió, cómo se organizan sus piezas y si el proyecto sigue vivo en 2026.
- Fuentes: identificadas 44 → incluidas 19
- Criterios de inclusión: documentación oficial del proyecto y de los proveedores de nube, artículos originales y datos abiertos del Estado; sin blogs, foros ni enciclopedias.
- Fecha de corte de los datos: 2026-11-11