Python para el análisis de datos
Python para análisis de datos es usar el lenguaje Python y sus librerías gratuitas, paquetes de código ya escrito como pandas, NumPy y matplotlib, para cargar, limpiar, explorar y graficar datos con instrucciones que se pueden volver a correr. Aquí verá por qué domina el oficio, el kit para empezar, qué hace cada librería y cuánto Python necesita de verdad.
Última actualización: 2026-10-16
Contenido de esta página
- ¿Qué es Python para análisis de datos?
- ¿Por qué Python domina el análisis de datos?
- El kit mínimo para empezar: Jupyter, pandas, NumPy y matplotlib
- Las 8 librerías de Python para análisis de datos, comparadas
- El flujo de trabajo con Python: cargar, limpiar, explorar y graficar
- ¿Cuánto Python necesita de verdad para analizar datos?
- Mapa de las guías de Python para análisis de datos
- Lo que deja una Navidad de 1989
En diciembre de 1989, Guido van Rossum buscaba un proyecto de programación «de pasatiempo» para la semana de Navidad. Lo contó él mismo en 1996, en el prólogo de un libro sobre su lenguaje [1]. Su oficina, un laboratorio público de investigación en Ámsterdam, iba a cerrar por las fiestas, y él tenía en casa un computador y poco más que hacer [1].
Decidió escribir un intérprete, el programa que lee y ejecuta las instrucciones de un lenguaje, para un lenguaje nuevo que venía pensando [1]. Lo llamó Python por Monty Python’s Flying Circus, un programa de la BBC, la televisión pública británica, del que era aficionado [1][2].
Ese lenguaje no nació para analizar datos. En 2008 empezó el desarrollo de pandas, un paquete de código para manejar tablas en Python. Nació en AQR Capital Management, una gestora de inversiones de Estados Unidos que se define como cuantitativa, es decir, que decide con modelos matemáticos [3][4]. A finales de 2009 pandas ya era código abierto: código que cualquiera puede leer, usar y modificar [3].
Detrás estaba Wes McKinney. En el prefacio de su libro Python for Data Analysis les agradece a sus antiguos colegas de AQR el apoyo a su trabajo en pandas [5]. Ahí mismo cuenta que en enero de 2010 acababa de lanzar la versión 0.1 [5].
Un lenguaje de propósito general, que sirve para casi cualquier tarea, más unas librerías hechas por analistas. Las librerías son paquetes de código listos para usar, y esa suma es lo que hoy se busca como Python para análisis de datos. Y de ahí sale algo que cambia el plan de estudio de quien empieza. No hace falta aprender todo Python.
¿Qué es Python para análisis de datos?
Python para análisis de datos es el trabajo de leer, ordenar, resumir y graficar información escribiendo instrucciones en el lenguaje Python, con ayuda de librerías gratuitas. Frente a una hoja de cálculo, la diferencia está en el rastro. Cada paso queda escrito, y se puede volver a correr cuando llegan datos nuevos o revisar cuando alguien duda del resultado.
Python es un lenguaje interpretado: el computador ejecuta cada instrucción sin el paso previo de compilar, que es traducir todo el programa de antemano al lenguaje de la máquina. La documentación oficial en español lo resume así: «Python es un lenguaje interpretado, lo cual puede ahorrarte mucho tiempo durante el desarrollo» [2]. Y añade: «El intérprete puede usarse interactivamente, lo que facilita experimentar con características del lenguaje» [2].
Para quien analiza datos, esa interactividad es el método de trabajo. Se escribe una línea, se mira el resultado y se decide la siguiente.
A mi juicio, la pieza que convirtió a Python en herramienta de analistas fue la tabla. pandas, la librería de McKinney, trae a Python las filas y columnas que cualquiera conoce de una hoja de cálculo. Su documentación la compara con dos objetos conocidos: la hoja de Excel y la tabla de SQL, el lenguaje con el que se consultan las bases de datos. Dice que sirve para «datos tabulares con columnas de tipos heterogéneos, como en una tabla SQL o una hoja de cálculo de Excel» [6]. Heterogéneos quiere decir que una columna puede tener nombres, otra fechas y otra cifras.
Un ejemplo ilustrativo: la secretaría de Hacienda de un municipio que cada mes arma el mismo informe de recaudo. En una hoja de cálculo, alguien repite a mano los mismos filtros y copias cada mes. Con Python, el informe queda escrito como un programa corto que se vuelve a correr con el archivo nuevo.
Leo ese programa como el acta de una reunión. Quien llegue después sabe qué se hizo con los datos, en qué orden y con qué criterio.
¿Python para análisis de datos o para ciencia de datos?
Python para análisis de datos y Python para ciencia de datos usan el mismo lenguaje y el mismo kit de base. Cambia hasta dónde se llega. El análisis describe y explica lo que muestran los datos; la ciencia de datos agrega modelos que predicen o clasifican.
El proceso de revisar datos hasta sacar una conclusión, con sus etapas y tipos, está en la guía de análisis de datos. Los modelos que aprenden de ejemplos son tema del machine learning. Esta guía se queda con la herramienta: Python y sus librerías.
¿Por qué Python domina el análisis de datos?
Python domina el análisis de datos por tres razones que se refuerzan entre sí. Es gratuito, sirve para casi cualquier tarea de programación y tiene un ecosistema de librerías científicas montado sobre una base común, NumPy. Además, encabeza las mediciones de popularidad: en el ranking de 2025 de IEEE Spectrum, la revista de la asociación internacional de ingenieros eléctricos y electrónicos, volvió a quedar primero [7].
El ranking de esa revista combina búsquedas en Google, preguntas en Stack Exchange (foros de preguntas y respuestas para programadores), menciones en artículos de investigación y actividad en GitHub, un sitio donde se publica código [7]. En la edición de 2025, Python también ocupó el primer lugar en la medición de empleos, donde el año anterior había quedado segundo [7].
La base común se llama NumPy, una librería para hacer cálculos con arreglos, que son tablas de números del mismo tipo que se operan de una sola vez. Charles Harris y sus coautores la describieron así en la revista Nature en 2020: «NumPy es la base sobre la que se construye el ecosistema científico de Python» [8]. Según el mismo artículo, casi todas las librerías de cálculo científico o numérico de Python se apoyan en ella [8]. Entre ellas están pandas y scikit-learn, una librería para entrenar modelos de machine learning [8].
Ese artículo pone a las finanzas y a la economía en la lista de campos donde NumPy cumple un papel esencial en el análisis [8]. Cuenta también que hizo parte del software usado para detectar las ondas gravitacionales y para obtener la primera imagen de un agujero negro [8].
Luego está el costo. Python se distribuye con una licencia de código abierto que permite usarlo y redistribuirlo libremente, incluso con fines comerciales [9]. pandas usa una licencia BSD de 3 cláusulas [6] y NumPy, una licencia BSD [10]. Son dos licencias libres que permiten usar y redistribuir el código. Jupyter, el cuaderno donde se trabaja, se publica también con una licencia BSD modificada [11]. Para una alcaldía o una universidad regional colombiana, eso significa cero pesos en licencias.
Como economista, veo en ese dominio un efecto de red, el fenómeno por el cual un producto vale más mientras más gente lo usa. Cada analista que publica una librería atrae a más analistas, y esos analistas publican más librerías. Es mi lectura, no un dato de las fuentes. Pero explica por qué otros lenguajes técnicamente sólidos no le han quitado el lugar.
¿Cuándo Python no es la mejor herramienta?
Python no es la mejor herramienta en tres situaciones. La primera, cuando un sistema debe responder casi al instante. La segunda, cuando la pregunta es rápida y la tabla cabe sin problema en una hoja de cálculo. La tercera, cuando los datos viven en una base de datos y basta con consultarlos allí. Saber elegir también es parte del oficio de analizar datos.
McKinney lo dice en su propio libro. Por ser interpretado, Python suele ser más lento que los lenguajes compilados, y eso pesa en sistemas que deben responder con muy poca demora [12]. Para un informe mensual, esa diferencia rara vez importa.
Si los datos están en una base de datos, la primera herramienta es SQL, el lenguaje para pedirle datos a esa base. Si no caben en un solo computador, el problema ya es de big data. Y la comparación entre Python y Excel tendrá su propia guía, en preparación.
El kit mínimo para empezar: Jupyter, pandas, NumPy y matplotlib
El kit mínimo de Python para análisis de datos tiene cinco piezas. Son el lenguaje, un cuaderno de Jupyter para escribir código y ver sus resultados, pandas para las tablas, NumPy para el cálculo y matplotlib para los gráficos. Las cinco son gratuitas. Con ellas se puede hacer el flujo completo, desde abrir un archivo hasta guardar un gráfico.
| Pieza del kit | Qué hace | Versión vigente (consultada el 16 de octubre de 2026) | Licencia |
|---|---|---|---|
| Python | El lenguaje y su intérprete | 3.15.0, del 9 de octubre de 2026 [13] | Código abierto, con uso comercial permitido [9] |
| Jupyter | Cuaderno que mezcla código, resultados y texto en un mismo documento | Se distribuye como varias aplicaciones, entre ellas Notebook y JupyterLab [11] | BSD modificada [11] |
| NumPy | Cálculo con arreglos de números | 2.5.4, del 10 de octubre de 2026 [10] | BSD [10] |
| pandas | Tablas con filas y columnas de distinto tipo | 3.0.6, del 17 de septiembre de 2026 [14] | BSD de 3 cláusulas [6] |
| matplotlib | Gráficos | Serie 3.11; la 3.11.0 salió el 11 de junio de 2026 [15] | Propia, basada en la de Python y sin pago de regalías [15] |
Jupyter es el lugar donde se escribe. El proyecto describe su Jupyter Notebook como «la aplicación web original para crear y compartir documentos computacionales» [11]. Un documento computacional, en este caso, es un archivo que guarda juntos el código, sus resultados y las notas de quien lo escribe. Jupyter nació en 2014 de IPython, una consola interactiva para Python, y hoy admite más de 40 lenguajes de programación [11].
NumPy pone la velocidad. Su núcleo es el ndarray, el arreglo de n dimensiones. Cuando se opera con él, cada elemento se procesa con código ya compilado en C, un lenguaje más cercano a la máquina. Así se evita recorrer los datos uno a uno con Python [10].
pandas pone la tabla. Está construida sobre NumPy y pensada para encajar en el resto del cálculo científico [6]. McKinney la presentó en 2010 en las actas de la conferencia científica de Python, SciPy, con el artículo Data Structures for Statistical Computing in Python [16].
matplotlib pone el gráfico. Se define como una librería completa para crear visualizaciones estáticas, animadas e interactivas en Python [15].
Para instalar las librerías se usa pip, el instalador recomendado, que ya viene incluido en los instaladores oficiales de Python [17]. Cómo instalarlas y cómo separar los proyectos en entornos distintos será tema de la guía de instalación de librerías, en preparación.
Hago la cuenta del costo real, porque no es cero. Hace falta un computador, conexión para descargar e instalar, y horas de estudio. Hace falta también algo de inglés técnico. El tutorial oficial de Python tiene traducción al español [2], pero la documentación de pandas, NumPy y matplotlib la consulté en inglés.
Las 8 librerías de Python para análisis de datos, comparadas
Las librerías de Python para análisis de datos se reparten el trabajo por etapas. NumPy y pandas sostienen el cálculo y las tablas. Polars ofrece otra forma de trabajar las tablas. Matplotlib, seaborn y Plotly hacen gráficos, GeoPandas trabaja con mapas y scikit-learn abre la puerta a los modelos. Esta tabla dice qué resuelve cada una y en qué momento entra.
| Librería | Qué resuelve | En qué momento del trabajo entra | Dónde se desarrolla |
|---|---|---|---|
| NumPy | Cálculo rápido con arreglos de números; casi todas las demás se apoyan en ella [8][10] | En todo el flujo, casi siempre por debajo | Guía de NumPy (próximamente) |
| pandas | Tablas con filas y columnas de distinto tipo, como una hoja de cálculo [6] | Al cargar, limpiar y explorar | Guía de pandas (próximamente) |
| Polars | Tablas, como pandas, en una librería pensada para el alto rendimiento [18] | Al cargar y transformar tablas grandes | Dentro de la guía de pandas (próximamente) |
| Matplotlib | Gráficos estáticos, animados e interactivos [15] | Al graficar | Dentro de la guía de gráficos en Python (próximamente) |
| seaborn | Gráficos estadísticos, construida sobre matplotlib [18] | Al explorar y graficar | Dentro de la guía de gráficos en Python (próximamente) |
| Plotly | Gráficos interactivos con calidad de publicación [18] | Al graficar para verlos en pantalla | Dentro de la guía de gráficos en Python (próximamente) |
| GeoPandas | Lleva las tablas de pandas a datos con forma geográfica, como los límites de un municipio [18] | Al cargar y explorar datos con ubicación | Guía de GeoPandas (próximamente) |
| scikit-learn | Herramientas para el análisis predictivo; está construida sobre NumPy, SciPy y matplotlib [18] | Después de explorar, cuando toca predecir o clasificar | Machine learning |
La tabla tiene una lectura práctica. Para empezar bastan las dos primeras y una de gráficos; el resto se suma cuando aparece el problema que resuelve. Es mi consejo de lector, no una regla de las fuentes.
En la fila de scikit-learn aparece SciPy, otra librería de la familia. Reúne algoritmos para optimización, integración, interpolación, ecuaciones algebraicas y diferenciales y estadística, entre otros problemas [19]. Quien analiza datos la usa a veces sin saberlo, porque otras librerías la llaman por dentro.
El flujo de trabajo con Python: cargar, limpiar, explorar y graficar
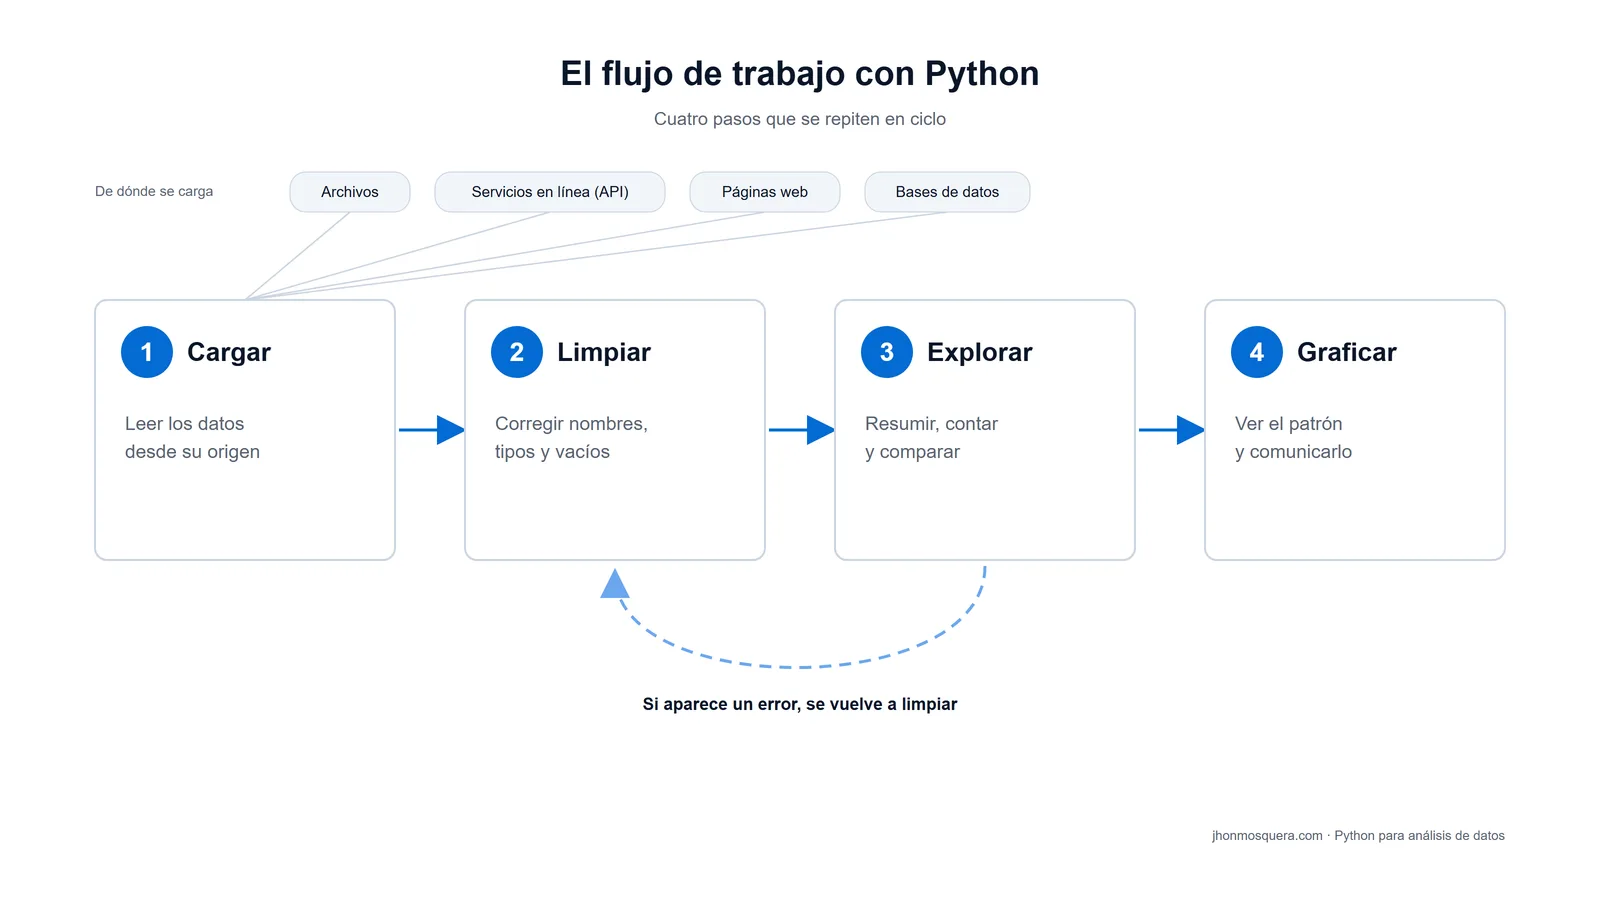
El flujo de trabajo de un análisis de datos con Python tiene cuatro pasos. Primero se cargan los datos desde un archivo, una página web, un servicio en línea o una base de datos. Luego se limpian, se exploran con resúmenes y se grafican. Cuando la exploración destapa un error, se vuelve a limpiar: el flujo es un ciclo, no una línea recta.
El ejemplo que sigue recorre los cuatro pasos con datos inventados. Una cooperativa lechera anota cuántos litros de leche recoge cada mes en tres municipios del área metropolitana de Bucaramanga. El archivo trae los errores de siempre: un nombre escrito con minúscula y un espacio de más, y un mes sin dato.
# Flujo mínimo: cargar, limpiar, explorar y graficar
# Datos inventados: litros de leche acopiados por una cooperativa en dos meses
import io

import matplotlib.pyplot as plt
import pandas as pd

# 1. Cargar. Con un archivo real sería: pd.read_csv("acopio.csv")
texto = io.StringIO("""municipio,mes,litros
Bucaramanga,2026-01,1200
bucaramanga ,2026-02,1350
Floridablanca,2026-01,800
Floridablanca,2026-02,
Girón,2026-01,640
Girón,2026-02,700
""")
acopio = pd.read_csv(texto)

# 2. Limpiar: quitar espacios, unificar mayúsculas y descartar filas sin litros
acopio["municipio"] = acopio["municipio"].str.strip().str.title()
acopio = acopio.dropna(subset=["litros"])

# 3. Explorar: total de litros y número de meses con dato por municipio
resumen = acopio.groupby("municipio")["litros"].agg(["sum", "count"])
resumen = resumen.sort_values("sum")
print(resumen)

# 4. Graficar y guardar la figura
resumen["sum"].plot(kind="barh", title="Litros acopiados por municipio")
plt.xlabel("Litros")
plt.tight_layout()
plt.savefig("acopio_por_municipio.png")
Sin la limpieza, «bucaramanga » con espacio y «Bucaramanga» serían dos municipios distintos para el computador. Con ella, el resumen deja a Floridablanca de última, con 800 litros. Le siguen Girón, con 1.340, y Bucaramanga, con 2.550.
Ahí está la trampa. La columna count muestra que Floridablanca tiene un solo mes con dato y los otros dos tienen dos. Su total más bajo puede deberse al mes que falta y no a que recoja menos leche. El programa no decidió eso: lo decidió quien escribió la línea que descarta los vacíos. Lo bueno es que la decisión quedó escrita y el resumen la dejó a la vista.
Cada paso tiene su guía, en preparación: limpieza de datos con Python, análisis exploratorio de datos con Python y gráficos en Python. Qué tipo de gráfico conviene para cada comparación ya está en la guía de visualización de datos.
¿De dónde salen los datos? Archivos, API, páginas web y bases de datos
Los datos llegan a Python por cuatro puertas: archivos, servicios en línea, páginas web y bases de datos. pandas trae funciones de lectura para casi todas, y cada puerta tiene su propia guía en preparación. Saber cuál usar depende de dónde publica los datos quien los produce, no de una preferencia del analista.
- Archivos. pandas lee archivos CSV (texto con valores separados por comas) y de Excel [20]. También lee JSON, un formato de texto muy usado en la web, y Parquet, un formato que guarda las tablas por columnas [20]. Y abre los archivos de Stata, SAS y SPSS, tres programas de estadística [20]. Eso le sirve a quien llega de esos programas con trabajos ya hechos.
- Servicios en línea (API). Una API es la puerta por la que un programa le pide datos a otro. En Colombia, el portal de datos abiertos del Estado es datos.gov.co, a cargo del Ministerio de Tecnologías de la Información y las Comunicaciones. Su sección de herramientas documenta la API de Socrata para quien desarrolla aplicaciones con esos datos [21]. La guía para consumir una API con Python está en preparación.
- Páginas web. Cuando los datos solo están publicados como página, se extraen con una técnica llamada web scraping, que lee el contenido de la página con un programa. Tendrá también su guía.
- Bases de datos. pandas puede leer el resultado de una consulta SQL directamente en una tabla [20]. Cómo conectar Python con una base de datos será tema de su propia guía; dónde y cómo se guardan los datos está en la guía de bases de datos.
¿Cuánto Python necesita de verdad para analizar datos?
Para analizar datos con Python basta, al comienzo, una parte pequeña del lenguaje: tipos de datos, listas y diccionarios, condicionales, bucles y funciones sencillas. El resto del esfuerzo va a pandas y al criterio para revisar datos. Construir aplicaciones completas es otro oficio, y puede esperar.
El libro de McKinney da una pista sobre esa proporción. De sus 13 capítulos, solo dos, el 2 y el 3, tratan lo básico del lenguaje y sus estructuras de datos propias [12]. Después de una introducción en el capítulo 1, los demás tratan de NumPy, pandas, la carga y limpieza de datos, los gráficos, la agregación, las series de tiempo, los modelos y ejemplos de análisis [12].
Mi propuesta para quien empieza tiene tres niveles:
- Lo indispensable desde la primera semana. Números, textos y valores lógicos; listas y diccionarios; condicionales y bucles. Sin eso no se entiende ni una línea de pandas. Será tema de la guía de Python básico para el análisis de datos.
- Lo que se aprende sobre la marcha. Escribir funciones propias y las formas cortas de recorrer una lista. Aparece en cuanto el mismo paso se repite tres veces. Tendrá su guía de funciones en Python.
- Lo que puede esperar. Las clases y los objetos, el estilo de programación con el que se construyen las librerías por dentro. Un analista los usa todos los días sin necesidad de escribirlos. Irán en la guía de programación orientada a objetos.
Hay algo que pesa más que la sintaxis: entender qué significa un promedio, una dispersión o un dato atípico. Python calcula en segundos lo que se le pida, pero no avisa si la pregunta estaba mal hecha. Eso es estadística, y tendrá su guía.
Mapa de las guías de Python para análisis de datos
Las guías de Python para análisis de datos siguen el orden en que se aprende el oficio. Primero el entorno y lo básico del lenguaje, luego las tablas, después cómo conseguir datos y, al final, cómo limpiarlos, explorarlos y graficarlos. Todas están en preparación; cuando se publiquen, cada nombre llevará su enlace en esta tabla.
| Si lo que busca es… | Guía | Estado |
|---|---|---|
| Instalar Python, pip y entornos separados por proyecto | Instalar librerías de Python | Próximamente |
| Escribir y correr código en un cuaderno | Jupyter Notebook | Próximamente |
| El mínimo del lenguaje para trabajar con tablas | Python básico para el análisis de datos | Próximamente |
| Reutilizar pasos con funciones propias | Funciones en Python | Próximamente |
| Entender las clases y los objetos | Programación orientada a objetos en Python | Próximamente |
| Calcular con arreglos de números | NumPy | Próximamente |
| Manejar tablas con filas y columnas | Pandas | Próximamente |
| Corregir errores, vacíos y duplicados | Limpieza de datos con Python | Próximamente |
| Describir unos datos antes de analizarlos | Análisis exploratorio de datos con Python | Próximamente |
| Elegir la librería para hacer gráficos | Gráficos en Python | Próximamente |
| Bajar datos de un servicio en línea | Consumir una API con Python | Próximamente |
| Extraer datos de una página web | Web scraping con Python | Próximamente |
| Consultar una base de datos desde el código | Conectar Python con una base de datos | Próximamente |
| Trabajar con mapas y datos geográficos | GeoPandas | Próximamente |
| Decidir entre la hoja de cálculo y el código | Python vs Excel para análisis de datos | Próximamente |
Hay temas vecinos con su propio lugar. Los tableros interactivos hechos en Python, como los de Streamlit o Dash, pertenecen a la visualización de datos. PySpark, la versión de Python para procesar datos repartidos entre muchas máquinas, es asunto del big data. Airflow, que programa flujos de datos para que corran solos, está en la ingeniería de datos.
El oficio de analista de datos, con sus habilidades y su ruta de aprendizaje, será tema de la guía de rutas y carreras en datos, en preparación.
Lo que deja una Navidad de 1989
Vuelvo a Van Rossum. Leo su historia así: el lenguaje se volvió herramienta de analistas porque otros le pusieron encima lo que necesitaban, como arreglos, tablas y gráficos. pandas, por ejemplo, empezó en una firma de inversiones, no en un laboratorio de computación.
A mi juicio, esa historia tiene una consecuencia para Colombia. La base de cálculo que ayudó a obtener la primera imagen de un agujero negro es la misma que puede instalar hoy el funcionario de un municipio pequeño, sin pagar una licencia. La brecha ya no está en el software. Está en las horas de estudio, en el inglés técnico y en tener a alguien cerca que enseñe.
Y hay una ganancia que no se mide en pesos. Un análisis escrito en código lo puede volver a correr cualquiera, incluida la persona que desconfía del resultado. Para una entidad pública, eso es rendición de cuentas.
La pregunta para quien empieza no es cuánto Python le falta. ¿Qué informe que hoy hace a mano va a dejar escrito este mes?
Preguntas frecuentes
¿Se puede leer gratis el libro de Wes McKinney sobre Python para análisis de datos? Sí, en inglés. El autor publica la tercera edición en acceso abierto, en formato web, en su propio sitio [12]. El mismo sitio advierte que, en general, su contenido no se puede copiar ni reproducir, y que los ejemplos de código tienen licencia MIT, una licencia libre [12]. Un archivo «gratis» que circule por fuera de ese sitio no es la versión que el autor abrió.
¿Python o R para análisis de datos? Los dos sirven y los dos son gratuitos. R se define como un lenguaje y entorno para el cómputo estadístico y los gráficos [22]. Se distribuye como software libre, bajo la licencia GNU GPL, que exige mantener abiertas las versiones derivadas [22]. Mi recomendación para quien empieza en Colombia es Python, porque el mismo lenguaje le sirve después para automatizar tareas o conectarse a otros sistemas. Si su equipo o su universidad ya trabajan en R, quédese en R: el mejor lenguaje es el que usan las personas que le pueden ayudar.
¿SQL o Python para análisis de datos? No compiten: se encadenan. SQL saca de la base de datos justo las filas y columnas que se necesitan, y Python las limpia, las cruza con otras fuentes y las grafica. En la práctica, muchos análisis empiezan con una consulta en SQL y siguen en un cuaderno de Python. Si solo puede aprender uno este año, elija según dónde viven los datos de su trabajo.
¿Se puede usar Python para analizar datos sin instalar nada? Sí. Google Colab es un servicio de cuadernos de Jupyter que corren en servidores de Google, no requiere configuración y es gratuito [23]. Tiene un límite que conviene conocer: sus recursos no están garantizados ni son ilimitados, y los topes de uso cambian [23]. Sirve para aprender y para ejercicios. Para datos de su trabajo, revise antes si su entidad permite subirlos a un servicio externo.
¿Qué versión de Python conviene instalar? Conviene una versión que todavía reciba correcciones de errores. A la fecha de esta revisión, la guía de desarrolladores de Python pone en esa fase a las dos ramas más nuevas, la 3.15 y la 3.14 [13]. Las tres anteriores solo reciben parches de seguridad [13]. Las librerías también ponen su piso: NumPy 2.5, por ejemplo, dejó de dar soporte a Python 3.11 [10]. Antes de instalar, revise qué versiones admiten las librerías que va a usar.
Referencias
Las citas en otro idioma son traducción propia.
- Guido van Rossum. Foreword for “Programming Python” (1st ed.), Reston, VA, mayo de 1996 — «Over six years ago, in December 1989, I was looking for a “hobby” programming project that would keep me occupied during the week around Christmas»; su oficina, «a government-run research lab in Amsterdam», estaría cerrada; «I had a home computer, and not much else on my hands»; decidió escribir un intérprete para un nuevo lenguaje de scripts, descendiente de ABC; eligió Python como nombre de trabajo y se declara «a big fan of Monty Python’s Flying Circus». Python.org: Foreword for Programming Python — Consultada: 2026-10-16.
- Python Software Foundation. El tutorial de Python, 1. Abriendo el apetito, documentación de Python 3.15.0 en español, y su original 1. Whetting Your Appetite — «Python es un lenguaje interpretado, lo cual puede ahorrarte mucho tiempo durante el desarrollo ya que no es necesario compilar ni enlazar»; «El intérprete puede usarse interactivamente, lo que facilita experimentar con características del lenguaje»; el lenguaje recibe su nombre del programa de la BBC «Monty Python’s Flying Circus». Python docs en español: Abriendo el apetito · Python docs: Whetting Your Appetite — Consultada: 2026-10-16.
- pandas development team. About pandas, sección History of development — «In 2008, pandas development began at AQR Capital Management. By the end of 2009 it had been open sourced»; desde 2015 es un proyecto patrocinado por NumFOCUS; cronología con la primera edición de Python for Data Analysis en 2012. pandas: About pandas — Consultada: 2026-10-16.
- AQR Capital Management. Our Firm — autodescripción como «a quantitative investment management firm»; sede en Greenwich, Connecticut, Estados Unidos. Se cita solo como fuente de su propia descripción. AQR: Our Firm — Consultada: 2026-10-16.
- Wes McKinney. Python for Data Analysis, 3.ª edición, Preface (edición en acceso abierto en el sitio del autor) — agradecimiento a «my former AQR colleagues who’ve cheered me on in my pandas work over the years»; contacto con John Hunter en enero de 2010, «just after releasing pandas 0.1»; «The first edition of this book was published in 2012». Wes McKinney: Python for Data Analysis, Preface — Consultada: 2026-10-16.
- pandas development team. Package overview, documentación de pandas 3.0.6 — pandas es un paquete de Python que ofrece estructuras de datos rápidas, flexibles y expresivas para trabajar con datos «relacionales» o «etiquetados»; adecuado para «Tabular data with heterogeneously-typed columns, as in an SQL table or Excel spreadsheet»; «pandas is built on top of NumPy and is intended to integrate well within a scientific computing environment»; licencia BSD de 3 cláusulas. pandas: Package overview — Consultada: 2026-10-16.
- Stephen Cass. The Top Programming Languages 2025, IEEE Spectrum, 23 de septiembre de 2025 — en el ranking por defecto, «once again Python has the top spot»; en el ranking de empleos, «Python has also taken first place, up from second place last year»; métricas: búsquedas en Google, preguntas en Stack Exchange, menciones en artículos de investigación y actividad en GitHub. Era la edición más reciente publicada a la fecha de consulta. IEEE Spectrum: The Top Programming Languages 2025 — Consultada: 2026-10-16.
- Harris, Charles R. et al. Array programming with NumPy, Nature, vol. 585, n.º 7825, 2020, pp. 357-362 — «NumPy is the foundation upon which the scientific Python ecosystem is constructed»; papel esencial en campos que incluyen «finance and economics»; «NumPy was an important part of the software stack used in the discovery of gravitational waves and in the first imaging of a black hole»; sostiene casi todas las librerías de Python de cálculo científico o numérico, entre ellas pandas y scikit-learn. Nature: Array programming with NumPy, DOI 10.1038/s41586-020-2649-2 · PubMed Central: texto completo abierto — Consultada: 2026-10-16.
- Python Software Foundation. About Python — «Python is developed under an OSI-approved open source license, making it freely usable and distributable, even for commercial use». Python.org: About — Consultada: 2026-10-16.
- NumPy Developers. Portada del proyecto, What is NumPy? (manual de NumPy 2.5) y News — «The fundamental package for scientific computing with Python»; «Distributed under a liberal BSD license»; «At the core of the NumPy package, is the ndarray object»; las operaciones elemento por elemento se ejecutan con código C precompilado; última versión listada: NumPy 2.5.4, 10 de octubre de 2026; NumPy 2.5.0 (21 de junio de 2026) deja de dar soporte a Python 3.11. NumPy: portada · NumPy: What is NumPy? · NumPy: News — Consultada: 2026-10-16.
- Project Jupyter. Portada y About — «The Jupyter Notebook is the original web application for creating and sharing computational documents»; JupyterLab como entorno web interactivo para cuadernos, código y datos; «Jupyter supports over 40 programming languages, including Python, R, Julia, and Scala»; «Project Jupyter is a non-profit, open-source project, born out of the IPython Project in 2014»; publicado bajo «the modified BSD license». Jupyter: portada · Jupyter: About — Consultada: 2026-10-16.
- Wes McKinney. Python for Data Analysis, 3.ª edición (acceso abierto en el sitio del autor): portada del libro y capítulo 1. Preliminaries — disponible como versión HTML de acceso abierto; «In general, the content from this website may not be copied or reproduced»; «The code examples are MIT-licensed»; 13 capítulos, de los cuales el 2 (Python Language Basics, IPython, and Jupyter Notebooks) y el 3 (Built-In Data Structures, Functions, and Files) tratan el lenguaje, y el 1 es introductorio y los demás NumPy, pandas, carga de datos, limpieza, transformación, gráficos, agregación, series de tiempo, modelos y ejemplos; en el capítulo 1, sección Why Not Python?, Python como lenguaje interpretado suele ser más lento que los compilados, lo que pesa en aplicaciones de muy baja latencia. Wes McKinney: Python for Data Analysis, 3E · Wes McKinney: capítulo 1, Preliminaries — Consultada: 2026-10-16.
- Python Software Foundation. Download Python y Python Developer’s Guide: Status of Python versions — Python 3.15.0, publicada el 9 de octubre de 2026, y 3.14.8, del 30 de septiembre de 2026; ramas 3.15 y 3.14 en estado bugfix (reciben correcciones); 3.13, 3.12 y 3.11 en estado security (solo parches de seguridad). Python.org: Downloads · Python Developer’s Guide: Status of Python versions — Consultada: 2026-10-16.
- pandas development team. Portada del proyecto — «Latest version: 3.0.6», fecha de publicación 17 de septiembre de 2026; versión anterior de la rama 2: 2.3.3 (29 de septiembre de 2025). pandas: portada — Consultada: 2026-10-16.
- Matplotlib Development Team. Portada y License — «Matplotlib is a comprehensive library for creating static, animated, and interactive visualizations in Python»; última versión anunciada: Matplotlib 3.11.0, 11 de junio de 2026; «Matplotlib only uses BSD compatible code, and its license is based on the PSF license»; la licencia concede «a nonexclusive, royalty-free, world-wide license». Matplotlib: portada · Matplotlib: License — Consultada: 2026-10-16.
- Wes McKinney. Data Structures for Statistical Computing in Python, Proceedings of the 9th Python in Science Conference (SciPy 2010), editores Stéfan van der Walt y Jarrod Millman, pp. 56-61. Se cita por sus datos bibliográficos, tal como los publica la página de citación de pandas: el texto del artículo no se pudo abrir en la fecha de consulta (acceso bloqueado). DOI 10.25080/Majora-92bf1922-00a · pandas: Citing and logo — Consultada: 2026-10-16.
- Python Software Foundation. Installing Python Modules, documentación de Python 3.15.0 — «pip is the preferred installer program. It is included by default with the Python binary installers». Python docs: Installing Python Modules — Consultada: 2026-10-16.
- Documentación oficial de Polars, seaborn, Plotly, GeoPandas y scikit-learn — Polars: «a high-performance DataFrame library for Python and Rust», licencia MIT; seaborn: «a Python data visualization library based on matplotlib», «It provides a high-level interface for drawing attractive and informative statistical graphics» (v0.13.2); Plotly: «Plotly’s Python graphing library makes interactive, publication-quality graphs», «free and open source» (v7.1.0); GeoPandas: «GeoPandas extends the datatypes used by pandas to allow spatial operations on geometric types»; scikit-learn: «Simple and efficient tools for predictive data analysis», «Built on NumPy, SciPy, and matplotlib», licencia BSD (versión 1.9.1, septiembre de 2026). Polars: portada · seaborn: portada · Plotly: Python graphing library · GeoPandas: documentación · scikit-learn: portada — Consultada: 2026-10-16.
- SciPy developers. Portada del proyecto — «SciPy provides algorithms for optimization, integration, interpolation, eigenvalue problems, algebraic equations», ecuaciones diferenciales, estadística y otros problemas; versión anunciada: SciPy 1.18.1 (21 de agosto de 2026). SciPy: portada — Consultada: 2026-10-16.
- pandas development team. IO tools (text, CSV, HDF5, …), documentación de pandas 3.0.6 — «The pandas I/O API is a set of top level reader functions accessed like pandas.read_csv() that generally return a pandas object»; lectores para CSV, JSON, HTML, Excel, Parquet, Stata, SAS, SPSS y SQL (read_sql), entre otros. pandas: IO tools — Consultada: 2026-10-16.
- Ministerio de Tecnologías de la Información y las Comunicaciones. Datos Abiertos Colombia: Herramientas — sección de videos, guías, manuales y tutoriales del portal; apartado «Desarrollar usando los datos» sobre «la API de Socrata utilizada para el desarrollo de aplicaciones». Datos Abiertos Colombia: Herramientas — Consultada: 2026-10-16.
- The R Foundation. What is R? — «R is a language and environment for statistical computing and graphics»; disponible como software libre bajo la licencia GNU GPL de la Free Software Foundation. R Project: What is R? — Consultada: 2026-10-16.
- Google Research. Colaboratory: Frequently Asked Questions — Colab es «a hosted Jupyter Notebook service that requires no setup to use»; «Colab is free of charge to use»; «Colab resources are not guaranteed and not unlimited, and usage limits sometimes fluctuate»; está basado en el proyecto de código abierto Jupyter. Google Research: Colaboratory FAQ — Consultada: 2026-10-16.
Cómo investigamos esta página
- Pregunta que responde: Qué es usar Python para analizar datos, por qué domina el oficio, cuál es el kit mínimo y cuánto Python hace falta de verdad.
- Fuentes: identificadas 44 → incluidas 35
- Criterios de inclusión: documentación oficial de Python y de cada librería, textos de primera mano de Guido van Rossum y Wes McKinney, un artículo de Nature con DOI y el ranking de IEEE Spectrum; nada de enciclopedias ni sitios de tutoriales.
- Fecha de corte de los datos: 2026-10-16