
Redes neuronales: la neurona, las capas y cómo aprenden
Una red neuronal artificial es un modelo de aprendizaje automático hecho de unidades simples conectadas en capas. Cada unidad multiplica sus entradas por unos pesos, suma un ajuste y decide cuánto responder. La red aprende al corregir esos pesos, ejemplo tras ejemplo, para equivocarse cada vez menos.
Última actualización: 2026-11-11
Contenido de esta página
- ¿Qué es una red neuronal artificial?
- ¿Cómo funciona una neurona artificial?
- Capas de una red neuronal: entrada, ocultas y salida
- ¿Cómo aprende una red neuronal?
- Una red neuronal en Python con NumPy, paso a paso
- Hiperparámetros de una red neuronal: épocas, tamaño de lote y tasa de aprendizaje
- Tipos de redes neuronales
- Lo que un peso no sabe de sí mismo
Historia real, contada por la Universidad Cornell. En julio de 1958, la Oficina de Investigación Naval de Estados Unidos presentó un invento notable [1]. Era un computador 704 de IBM, la empresa estadounidense de computadores, que pesaba cinco toneladas y ocupaba un cuarto [1]. La máquina recibió una serie de tarjetas perforadas [1]. Unas llevaban una marca a la izquierda y otras, a la derecha.
Después de 50 intentos, el computador aprendió por su cuenta a distinguirlas [1].
Era la demostración del perceptrón, la máquina que había ideado Frank Rosenblatt, psicólogo investigador del Laboratorio Aeronáutico de Cornell [1]. Ese mismo año, Rosenblatt publicó su teoría en la revista Psychological Review [2]. Allí tomó partido por la posición que llamó «conexionista» [2]. Según esa posición, lo aprendido no se guarda como una copia de lo que se vio, sino en la forma en que se conectan las partes del sistema [2]. En sus palabras, «la información está contenida en conexiones o asociaciones» [2].
Esa es la idea que sigue viva en toda red neuronal artificial. Se trata de un programa hecho de muchas unidades de cálculo conectadas, y lo que aprende queda guardado en los números de esas conexiones. Esta guía usa las tarjetas de 1958 como ejemplo de principio a fin, con números de juguete que yo mismo calculé.
¿Qué es una red neuronal artificial?
Una red neuronal artificial es un modelo de machine learning, es decir, una fórmula que se ajusta con ejemplos en lugar de escribirse a mano. Está hecha de unidades simples, llamadas neuronas artificiales, que se organizan en capas. Cada neurona recibe números, los combina y pasa un resultado a la siguiente capa [3].
El nombre viene de la biología, pero el parentesco es lejano. El manual Deep Learning de Ian Goodfellow, Yoshua Bengio y Aaron Courville explica que estas redes se llaman neuronales porque se inspiran, de forma vaga, en la neurociencia [3]. Una neurona artificial es una operación aritmética, no una célula.
Cuando una red apila muchas capas ocultas, el oficio cambia de nombre y se habla de aprendizaje profundo. Por qué esa profundidad marca la diferencia es el tema de la guía de deep learning.
Aquí la pregunta es otra, más de taller: cómo funciona una red por dentro.
¿Cómo funciona una neurona artificial?
Una neurona artificial hace tres cosas en orden. Multiplica cada entrada por un peso, suma los resultados y les añade un sesgo; luego pasa ese total por una función de activación, que decide cuánto responde la neurona [3]. El manual de Goodfellow resume así a la mayoría de neuronas ocultas: reciben entradas, calculan esa suma con pesos y sesgo, y aplican una función no lineal [3].
Las cuatro piezas, con un ejemplo de juguete para una tarjeta con la marca a la izquierda:
| Pieza | Qué es | En el ejemplo |
|---|---|---|
| Entradas | Los datos que llegan a la neurona, convertidos en números | Marca a la izquierda = 1; marca a la derecha = 0 |
| Pesos | Un número por entrada que dice cuánto influye en la respuesta | 0,5 para la izquierda; −0,3 para la derecha |
| Sesgo (bias, en inglés) | Un número extra que corre el punto de partida, aunque todas las entradas valgan cero | 0,1 |
| Función de activación | La regla que convierte la suma en la respuesta final | Sigmoide: aprieta cualquier número entre 0 y 1 |
La cuenta es corta y cabe en dos renglones:
| Paso | Cuenta | Resultado |
|---|---|---|
| Suma ponderada | 0,5 × 1 + (−0,3) × 0 + 0,1 | 0,6 |
| Activación (sigmoide) | sigmoide(0,6) | 0,6457 |
Ese resultado se puede leer como «64,6 % de confianza en que la marca está a la izquierda». La tarjeta sí tiene la marca a la izquierda, así que la neurona acierta, aunque con poca seguridad.
¿Para qué sirve la función de activación?
La función de activación existe para que la red pueda aprender relaciones que no son una línea recta. Sin ella, apilar capas no sirve: dos operaciones lineales seguidas equivalen a una sola, y el manual de Goodfellow lo muestra con una cuenta de dos líneas [3]. Su conclusión es directa: para describir los rasgos de los datos hay que usar una función no lineal [3].
Las dos más conocidas se entienden sin fórmulas:
- Sigmoide. Convierte cualquier número en un valor entre 0 y 1. Sirve en la salida cuando la respuesta es un sí o un no.
- ReLU (unidad lineal rectificada, en inglés rectified linear unit). Deja pasar los números positivos tal como vienen y convierte los negativos en cero. En las redes modernas es la recomendación por defecto para las capas ocultas [3].
Un detalle sirve de puente con la estadística. Si a una neurona se le quita la función de activación, lo que queda es una suma de entradas por pesos más un número fijo. El manual de Goodfellow describe la regresión lineal justo así, con un vector de pesos y un sesgo [3].
El perceptrón de Rosenblatt: la neurona de 1958
El perceptrón es la neurona de 1958 hecha máquina. Según la crónica de Cornell, era una red neuronal de una sola capa que clasificaba lo que recibía en dos categorías posibles [1]. Si se equivocaba, se ajustaba a sí misma para acertar mejor la vez siguiente [1].
Su límite llegó pronto. Críticos como Marvin Minsky señalaron fallas de los modelos lineales, entre ellas que no podían aprender la función XOR [3]. XOR es la regla del «o exclusivo»: la respuesta es sí cuando hay exactamente una marca, a la izquierda o a la derecha, y no cuando hay dos o ninguna. El manual de Goodfellow cuenta que esa crítica desató un rechazo contra todo el enfoque de redes neuronales [3]. Salir del atasco exigía dos cosas: redes con más capas y una manera de calcular cómo corregirlas [3].
Capas de una red neuronal: entrada, ocultas y salida
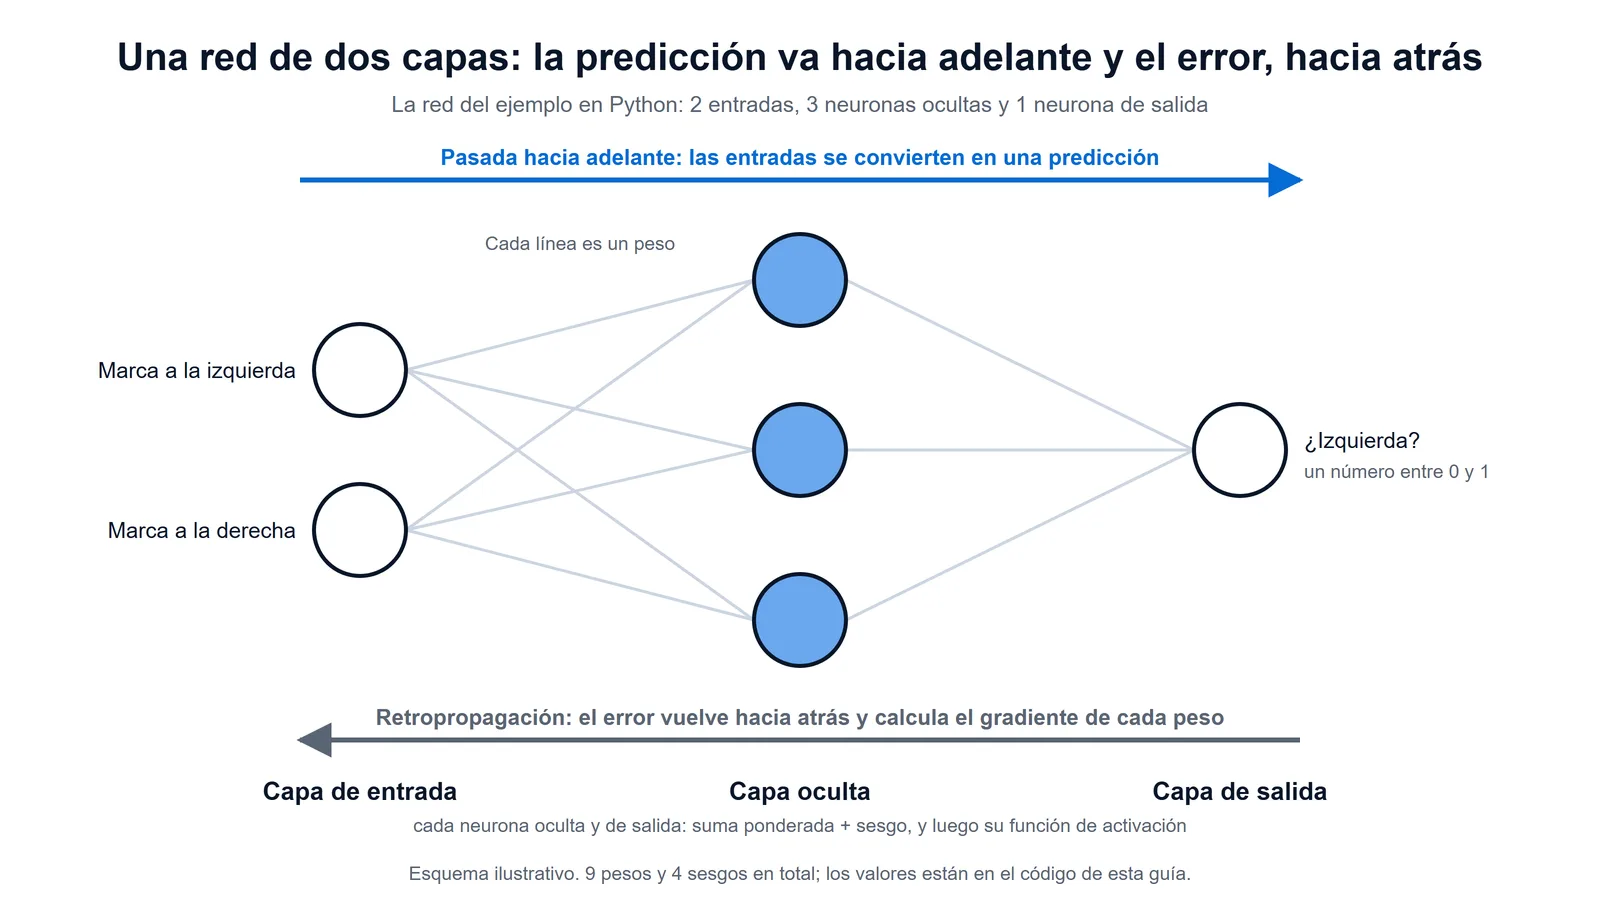
Una red neuronal se arma encadenando capas de neuronas. La capa de entrada recibe los datos, las capas ocultas los transforman y la capa de salida entrega la respuesta. Si cada neurona de una capa recibe a todas las de la capa anterior, la capa se llama densa. TensorFlow es una librería libre para redes neuronales. Su documentación presenta la capa densa como «la capa habitual de una red neuronal densamente conectada» [4]. Calcula justo lo de la tabla de arriba: entradas por pesos, más un sesgo, y la activación [4].
El manual de Goodfellow explica de dónde sale el nombre «ocultas» [3]. Los datos de entrenamiento dicen qué debe producir la capa de salida, pero no qué debe hacer cada capa intermedia [3]. Esas capas no se ven en los datos, y por eso se llaman ocultas [3]. El número de neuronas de una capa se llama su ancho [3].
A estas redes, en las que la información avanza en un solo sentido, el manual las llama redes prealimentadas (feedforward, en inglés). También las nombra con otra etiqueta muy usada: «Las redes prealimentadas profundas, también llamadas redes neuronales prealimentadas o perceptrones multicapa (MLP), son los modelos por excelencia del aprendizaje profundo» [3]. MLP es la sigla en inglés de multilayer perceptron.
¿Qué calcula una pasada hacia adelante?
Una pasada hacia adelante es el recorrido de los datos desde la entrada hasta la salida. Cada capa toma los números de la capa anterior, hace sus sumas ponderadas, aplica su activación y entrega el resultado a la siguiente [3]. Al final sale una predicción. El manual de Goodfellow la llama propagación hacia adelante y añade que, durante el entrenamiento, el recorrido sigue hasta producir un solo número: el costo, o pérdida [3].
En la red del ejemplo en Python, más abajo, hay 2 entradas, 3 neuronas ocultas y 1 de salida. Eso suma 9 pesos y 4 sesgos.
¿Cómo aprende una red neuronal?
Una red neuronal aprende repitiendo un ciclo de cuatro pasos. Hace una predicción y mide cuánto se equivocó. Luego calcula hacia dónde mover cada peso para equivocarse menos y los mueve un poquito en esa dirección. Ese ciclo se repite muchas veces con los ejemplos de entrenamiento [3] [5].
- Predecir. Una pasada hacia adelante produce la respuesta de la red.
- Medir el error. La función de pérdida compara la respuesta con la correcta.
- Repartir la culpa. La retropropagación calcula cuánto contribuyó cada peso al error.
- Corregir. El descenso del gradiente mueve cada peso en la dirección que baja el error.
La función de pérdida: cuánto se equivocó la red
La función de pérdida es la regla que convierte el error de la red en un solo número. Mide qué tan lejos quedó el resultado del valor correcto [5]. Según el tutorial oficial de PyTorch, una librería libre de Python para redes neuronales, ese número es justo lo que el entrenamiento busca hacer más pequeño [5].
En el ejemplo, la respuesta correcta era 1 y la neurona dijo 0,6457. Con el error cuadrático, que eleva al cuadrado la diferencia, la pérdida es (1 − 0,6457)² = 0,1256. El tutorial de PyTorch nombra ese tipo de pérdida para problemas de regresión, que predicen números, y otras distintas para clasificar [5]. Aquí se usa por ser la más fácil de seguir a mano.
Descenso del gradiente: bajar la loma sin ver el valle
El descenso del gradiente es el método que corrige los pesos. Para cada peso se calcula el gradiente, que es la pendiente de la pérdida: cuánto sube o baja el error si ese peso crece un poquito. Luego el peso se mueve en contra de esa pendiente, cuesta abajo [3].
Piense en alguien que baja de un cerro de noche, con una linterna que solo alumbra el paso siguiente. No ve el valle. Solo siente hacia dónde se inclina el suelo y da un paso hacia abajo.
El tamaño de ese paso lo fija la tasa de aprendizaje. La documentación de Google para desarrolladores lo explica así: el modelo multiplica el gradiente por la tasa de aprendizaje para decidir cuánto cambia cada parámetro [7]. Con un gradiente de 2,5 y una tasa de 0,01, el parámetro cambia 0,025 [7]. El método no es nuevo: el manual de Goodfellow ubica su origen en el siglo XIX, con un trabajo de Cauchy de 1847 [3]. Buscar los valores que hacen mínimo un error es también el oficio de la estadística cuando ajusta un modelo a unos datos.
¿Qué es la retropropagación? Explicada sin cálculo pesado
La retropropagación es el procedimiento que calcula el gradiente de cada peso en una red de varias capas. Empieza por el error de la salida y lo devuelve capa por capa hacia la entrada. En cada capa reparte la responsabilidad entre los pesos que intervinieron [3] [6].
La herramienta matemática se llama regla de la cadena, y cabe en una frase. Si un peso mueve un número intermedio y ese número mueve la pérdida, el efecto del peso es el producto de los dos efectos.
En la neurona del ejemplo, con una tasa de aprendizaje de 0,5, la cuenta completa es esta:
| Paso | Cuenta | Resultado |
|---|---|---|
| Cuánto cambia la pérdida si sube la salida | −2 × (1 − 0,6457) | −0,7087 |
| Cuánto cambia la salida si sube la suma ponderada | 0,6457 × (1 − 0,6457) | 0,2288 |
| Regla de la cadena: el producto de los dos efectos | −0,7087 × 0,2288 | −0,1621 |
| Nuevo primer peso | 0,5 − 0,5 × (−0,1621) × 1 | 0,5811 |
| Nuevo sesgo | 0,1 − 0,5 × (−0,1621) | 0,1811 |
| Nueva salida | sigmoide(0,5811 + 0,1811) | 0,6818 |
El segundo peso no cambia, porque su entrada valía cero. Con los pesos nuevos, la pérdida baja de 0,1256 a 0,1012. Las cuentas salen de un programa que ejecuté con todos los decimales; por eso alguna difiere en la última cifra de la que haría usted con números redondeados.
Una vuelta, un error más pequeño. Eso es aprender.
David Rumelhart, Geoffrey Hinton y Ronald Williams presentaron este procedimiento en la revista Nature en 1986 [6]. Según el resumen del artículo, el método «ajusta repetidamente los pesos de las conexiones de la red» para reducir la diferencia entre la salida real y la deseada [6]. El manual de Goodfellow aclara un malentendido frecuente: la retropropagación no es todo el aprendizaje, sino solo la manera de calcular el gradiente [3]. Quien mueve los pesos es otro algoritmo, como el descenso del gradiente [3]. La idea tampoco nació en un solo lugar: Paul Werbos propuso en 1981 aplicarla a redes neuronales, y varios grupos la redescubrieron por su cuenta a mediados de esa década [3].
Una red neuronal en Python con NumPy, paso a paso
Este código arma la red de dos capas del esquema: una capa oculta de 3 neuronas con ReLU y una neurona de salida con sigmoide. Hace una pasada hacia adelante, calcula la retropropagación y da un solo paso de descenso del gradiente. Lo ejecuté con Python 3.11.15 y NumPy 2.4.6, una librería libre para cálculo con matrices [8] [9].
# Red de dos capas con NumPy: pasada hacia adelante, retropropagación y un paso
import numpy as np

# Dos tarjetas: [marca izquierda, marca derecha] y su respuesta (1 = izquierda)
X = np.array([[1.0, 0.0],
              [0.0, 1.0]])
y = np.array([[1.0],
              [0.0]])

# Pesos y sesgos iniciales fijos, para que el resultado se pueda repetir
W1 = np.array([[0.2, -0.4, 0.6],
               [0.5, 0.3, -0.1]])   # capa oculta: 2 entradas -> 3 neuronas
b1 = np.array([0.0, 0.1, 0.0])
W2 = np.array([[0.7],
               [-0.2],
               [0.4]])              # capa de salida: 3 neuronas -> 1
b2 = np.array([0.0])
tasa = 0.5                          # tasa de aprendizaje

def relu(z):
    return np.maximum(0, z)

def sigmoide(z):
    return 1 / (1 + np.exp(-z))

def adelante(X):
    z1 = X @ W1 + b1        # suma ponderada de la capa oculta
    a1 = relu(z1)           # activación de la capa oculta
    z2 = a1 @ W2 + b2       # suma ponderada de la salida
    return z1, a1, sigmoide(z2)

# 1. Pasada hacia adelante y pérdida (error cuadrático medio)
z1, a1, salida = adelante(X)
perdida = np.mean((salida - y) ** 2)
print("salida antes:", salida.ravel().round(4), "| pérdida:", round(perdida, 4))

# 2. Retropropagación: la regla de la cadena, de la salida hacia atrás
d_salida = 2 * (salida - y) / len(X)        # pérdida respecto a la salida
d_z2 = d_salida * salida * (1 - salida)     # atraviesa la sigmoide
d_W2 = a1.T @ d_z2
d_b2 = d_z2.sum(axis=0)
d_a1 = d_z2 @ W2.T                          # el error vuelve a la capa oculta
d_z1 = d_a1 * (z1 > 0)                      # atraviesa la ReLU
d_W1 = X.T @ d_z1
d_b1 = d_z1.sum(axis=0)

# 3. Un paso de descenso del gradiente: cada peso se mueve contra su gradiente
W1 -= tasa * d_W1
b1 -= tasa * d_b1
W2 -= tasa * d_W2
b2 -= tasa * d_b2

_, _, salida = adelante(X)
print("salida después:", salida.ravel().round(4),
      "| pérdida:", round(np.mean((salida - y) ** 2), 4))
La salida real del programa es esta:
salida antes: [0.5939 0.5671] | pérdida: 0.2433
salida después: [0.5992 0.5441] | pérdida: 0.2283
Tras un solo paso, la pérdida bajó de 0,2433 a 0,2283. La red subió un poco su confianza en la primera tarjeta y bajó la de la segunda. Todavía se equivoca con la segunda: le da 0,5441, más de la mitad, cuando la respuesta correcta es 0.
Repetí el mismo paso para ver la tendencia. Con 100 pasos, la pérdida queda en 0,0024 y la red ya separa las dos tarjetas: 0,9551 para la primera y 0,0524 para la segunda. Si quiere correrlo usted mismo, le sirve un cuaderno de Jupyter, y esa guía explica cómo instalarlo. Los fundamentos del lenguaje están en la guía de Python para análisis de datos.
En el trabajo diario, las librerías calculan la retropropagación por usted: en PyTorch basta una llamada para que deposite el gradiente de la pérdida en cada parámetro [5]. Escribirla una vez, sin embargo, enseña lo que ninguna librería muestra.
Hiperparámetros de una red neuronal: épocas, tamaño de lote y tasa de aprendizaje
Los hiperparámetros son los valores que la persona fija antes de entrenar; los parámetros, como los pesos y los sesgos, los calcula el modelo mientras aprende [7]. El tutorial de PyTorch define tres hiperparámetros básicos y advierte que valores distintos pueden cambiar el entrenamiento y la velocidad con que el modelo converge, es decir, llega a un punto estable [5].
| Hiperparámetro | Qué controla | Valor en el tutorial de PyTorch | Qué advierte la documentación |
|---|---|---|---|
| Número de épocas | Cuántas veces se recorre el conjunto de datos completo [5] | 5 en la definición; la implementación completa usa 10 [5] | Cada época tiene una vuelta de entrenamiento y otra de validación, para revisar si el modelo mejora [5] |
| Tamaño de lote | Cuántos ejemplos pasan por la red antes de actualizar los parámetros [5] | 64 [5] | Valores distintos pueden cambiar el entrenamiento y su convergencia [5] |
| Tasa de aprendizaje | Cuánto se actualizan los parámetros en cada lote o época [5] | 0,001 [5] | Muy baja: aprende despacio y tarda mucho en converger. Muy alta: puede comportarse de forma impredecible o rebotar sin converger [5] [7] |
La documentación de Google describe los dos extremos [7]. Con una tasa demasiado alta, cada vuelta hace que la pérdida rebote o crezca sin parar [7]. Con una demasiado baja, la pérdida apenas mejora en cada vuelta [7].
En el ejemplo de Python, el lote era el conjunto completo de dos tarjetas. Por eso cada paso equivalía a una época.
Tipos de redes neuronales
Los tipos de redes neuronales comparten la neurona de esta guía y se distinguen por cómo se conectan sus neuronas y por dónde viaja la información. La tabla resume los más citados, con una línea por tipo. Todos aprenden con la misma lógica de esta guía: pérdida, gradiente y ajuste de pesos.
| Tipo | Para qué datos | La idea en una línea |
|---|---|---|
| Perceptrón | Casos que se separan en dos categorías | Una sola capa que clasifica en dos grupos y se corrige cuando falla [1] |
| Perceptrón multicapa (red prealimentada) | Cualquier tarea de convertir unas entradas en una respuesta, como clasificar [3] | Capas ocultas densas; la información avanza en un solo sentido, sin volver atrás [3] |
| Red convolucional | Datos con forma de cuadrícula, como las imágenes (cuadrícula de píxeles) o las series de tiempo [10] | Usa en al menos una capa una operación llamada convolución, en lugar de la multiplicación de matrices general [10] |
| Red recurrente | Secuencias, como un texto palabra por palabra [3] [11] | Añade conexiones de retroalimentación: parte de la salida vuelve a entrar [3] [11] |
| Autocodificador (autoencoder) | Datos que se quieren representar con un código interno [12] | Aprende a copiar su entrada en su salida, pasando por un código interno, sin poder copiar perfecto [12] |
| Transformer | Secuencias; se probó primero en traducción automática [13] | Se basa solo en mecanismos de atención, sin recurrencia ni convoluciones [13] |
La atención, en el último renglón, es una suma ponderada en la que el modelo calcula cuánto peso darle a cada parte de la entrada [13]. Para qué nació cada arquitectura y por qué la profundidad las hizo despegar está en el mapa de arquitecturas del deep learning.
Lo que un peso no sabe de sí mismo
Volvamos a las tarjetas de 1958. Según la teoría de Rosenblatt, lo aprendido vivía en las conexiones [2]. Casi siete décadas después, la red de este ejemplo guarda lo que aprende en el mismo lugar: 13 números, en lugar de un computador del tamaño de un cuarto.
Hay algo incómodo en esa idea, y lo digo como opinión: ningún peso, por separado, sabe por qué vale lo que vale. El 0,5811 del ejemplo no significa «izquierda». Significa algo solo en conjunto con los demás. Por eso una red puede acertar sin que nadie, ni quien la entrenó, pueda leer su razonamiento como se lee una regla.
Mi recomendación es concreta. Antes de usar una librería que hace todo esto sola, corra a mano una neurona y un paso de retropropagación. Se hace con un computador común y herramientas gratuitas, en una tarde. Quien entiende ese paso puede preguntar por qué falló un modelo. Quien no, solo puede creerle.
Preguntas frecuentes
¿Qué diferencia hay entre una red neuronal y el deep learning? El deep learning, o aprendizaje profundo, es el uso de redes neuronales con muchas capas. El manual de Goodfellow explica que el nombre salió de esa terminología: la cantidad de capas encadenadas da la profundidad del modelo [3]. Toda red de deep learning es una red neuronal; cuántas capas hacen falta y por qué importan se cuenta en la guía de deep learning.
¿Una red neuronal artificial funciona como el cerebro humano? No en el sentido literal. Rosenblatt sí partió del cerebro: tituló su artículo de 1958 como un modelo probabilístico del almacenamiento y la organización de la información en el cerebro [2]. Las redes de hoy conservan esa herencia en el nombre, pero son programas que hacen cuentas. El parecido con una neurona de verdad se queda en la inspiración [3].
¿Cuántas capas y neuronas necesita una red neuronal? Depende del problema, y no hay una cifra universal. Hay un resultado teórico, el teorema de aproximación universal [3]. Dice que una red con una capa de salida lineal y al menos una capa oculta con una activación como la sigmoide puede aproximar cualquier función continua en un rango acotado [3]. La condición es que tenga suficientes neuronas ocultas [3]. Pero, como advierte el manual de Goodfellow, el teorema no dice qué tan grande será esa red [3]. En el peor caso puede requerir un número enorme de neuronas [3].
¿Qué diferencia hay entre parámetros e hiperparámetros? Una forma corta de recordarlo: los parámetros los aprende la red y los hiperparámetros los escoge usted [7]. Google pone como ejemplos de hiperparámetros la tasa de aprendizaje, el tamaño de lote y las épocas [7]. En el código de esta guía, W1, W2, b1 y b2 guardan los 13 parámetros. La variable tasa es un hiperparámetro, igual que el número de pasos.
¿Por qué la red empieza con pesos que dan respuestas malas? Porque al inicio no sabe nada del problema y alguien tiene que darle valores de partida. En el ejemplo los fijé a mano para que cualquiera pueda repetir la cuenta. El tutorial de PyTorch advierte que una red sin entrenar probablemente no dará la respuesta correcta [5]. El entrenamiento existe para corregir ese punto de partida.
Referencias
Las citas en otro idioma son traducción propia.
- Lefkowitz, Melanie. Professor’s perceptron paved the way for AI – 60 years too soon, Cornell Chronicle, Universidad Cornell, 25 de septiembre de 2019 — en julio de 1958 la Office of Naval Research presentó el invento: un IBM 704 de 5 toneladas y del tamaño de un cuarto recibió tarjetas perforadas y, tras 50 intentos, aprendió por sí solo a distinguir tarjetas marcadas a la izquierda de tarjetas marcadas a la derecha; Rosenblatt era psicólogo investigador e ingeniero de proyecto del Cornell Aeronautical Laboratory; el perceptrón es una red neuronal de una sola capa que clasifica en dos categorías y se ajusta cuando se equivoca. Cornell Chronicle: el perceptrón de Rosenblatt — Consultada: 2026-11-11.
- Rosenblatt, Frank. The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain, Psychological Review, vol. 65, n.º 6, 1958, pp. 386-408 — la teoría adopta la posición «empirista, o conexionista»; «the information is contained in connections or associations rather than topographic representations» (p. 387); el perceptrón como sistema nervioso hipotético, o máquina. Leído en la copia del curso COGS 501 de la Universidad de Pensilvania. APA: DOI 10.1037/h0042519 · Universidad de Pensilvania: copia del artículo — Consultada: 2026-11-11.
- Goodfellow, Ian; Bengio, Yoshua; Courville, Aaron. Deep Learning, MIT Press, 2016, capítulo 6, «Deep Feedforward Networks» — definición de redes prealimentadas o perceptrones multicapa como «the quintessential deep learning models»; capas, capas ocultas, ancho y profundidad; nombre «neural» por inspiración vaga en la neurociencia; transformación con pesos y sesgos seguida de una función de activación; necesidad de una función no lineal; ReLU como recomendación por defecto; propagación hacia adelante; la retropropagación calcula el gradiente y otro algoritmo, como el descenso del gradiente estocástico, aprende con él; teorema de aproximación universal; notas históricas (Minsky y la función XOR, Werbos 1981, redescubrimientos de LeCun 1985, Parker 1985 y Rumelhart et al. 1986). Deep Learning Book: capítulo 6 — Consultada: 2026-11-11.
- TensorFlow. tf.keras.layers.Dense, documentación de la API de TensorFlow 2.21.0 (última actualización el 31 de octubre de 2026) — «Just your regular densely-connected NN layer»; la capa calcula output = activation(dot(input, kernel) + bias), con una matriz de pesos y un vector de sesgos. TensorFlow: tf.keras.layers.Dense — Consultada: 2026-11-11.
- PyTorch. Optimizing Model Parameters, PyTorch Tutorials, documentación 2.15.0 (creado el 9 de febrero de 2021; última actualización el 31 de julio de 2026) — hiperparámetros: número de épocas (veces que se recorre el conjunto de datos), tamaño de lote (muestras que se propagan antes de actualizar los parámetros) y tasa de aprendizaje («Smaller values yield slow learning speed, while large values may result in unpredictable behavior during training»); valores de ejemplo 1e-3, 64 y 5; cada época tiene un ciclo de entrenamiento y otro de validación o prueba; la función de pérdida mide la diferencia con el valor objetivo y se minimiza; MSELoss para regresión y NLLLoss para clasificación; una red sin entrenar probablemente no dará la respuesta correcta; loss.backward() deposita los gradientes. PyTorch: Optimizing Model Parameters — Consultada: 2026-11-11.
- Rumelhart, David E.; Hinton, Geoffrey E.; Williams, Ronald J. Learning representations by back-propagating errors, Nature, vol. 323, pp. 533-536, octubre de 1986 — resumen: el procedimiento «repeatedly adjusts the weights of the connections in the network» para minimizar la diferencia entre la salida real y la deseada; las unidades ocultas llegan a representar rasgos importantes de la tarea. Nature: DOI 10.1038/323533a0 — Consultada: 2026-11-11.
- Google for Developers. Machine Learning Crash Course, Linear regression: Hyperparameters (última actualización el 3 de diciembre de 2025) — los hiperparámetros los controla la persona y los parámetros, como pesos y sesgo, los calcula el modelo; una tasa de aprendizaje muy baja tarda mucho en converger y una muy alta nunca converge y rebota; el modelo multiplica el gradiente por la tasa de aprendizaje (gradiente 2,5 y tasa 0,01 cambian el parámetro en 0,025). Google for Developers: Hyperparameters — Consultada: 2026-11-11.
- Python Software Foundation. Python 3.11.15 — versión de seguridad de la serie 3.11, publicada el 3 de marzo de 2026. Python.org: Python 3.11.15 — Consultada: 2026-11-11.
- NumPy. News, listado de versiones publicadas — incluye NumPy 2.4.6 (la serie vigente al consultar es la 2.5). NumPy: noticias y versiones — Consultada: 2026-11-11.
- Goodfellow, Ian; Bengio, Yoshua; Courville, Aaron. Deep Learning, MIT Press, 2016, capítulo 9, «Convolutional Networks» — las redes convolucionales son un tipo especializado de red para datos con una topología de cuadrícula conocida, como series de tiempo (1-D) e imágenes (2-D de píxeles); emplean la operación llamada convolución. Deep Learning Book: capítulo 9 — Consultada: 2026-11-11.
- Goodfellow, Ian; Bengio, Yoshua; Courville, Aaron. Deep Learning, MIT Press, 2016, capítulo 10, «Sequence Modeling: Recurrent and Recursive Nets» — las redes recurrentes son una familia de redes neuronales para procesar datos secuenciales. Deep Learning Book: capítulo 10 — Consultada: 2026-11-11.
- Goodfellow, Ian; Bengio, Yoshua; Courville, Aaron. Deep Learning, MIT Press, 2016, capítulo 14, «Autoencoders» — un autocodificador es una red entrenada para intentar copiar su entrada en su salida, con una capa oculta que describe un código; se diseña para que no pueda copiar perfectamente. Deep Learning Book: capítulo 14 — Consultada: 2026-11-11.
- Vaswani, Ashish; Shazeer, Noam; Parmar, Niki; Uszkoreit, Jakob; Jones, Llion; Gomez, Aidan N.; Kaiser, Lukasz; Polosukhin, Illia. Attention Is All You Need, arXiv 1706.03762 (enviado el 12 de junio de 2017; versión 7 del 2 de agosto de 2023) — propone el transformer, «based solely on attention mechanisms, dispensing with recurrence and convolutions entirely», probado en dos tareas de traducción automática; la salida de la atención es una suma ponderada de valores. arXiv: Attention Is All You Need — Consultada: 2026-11-11.
Cómo investigamos esta página
- Pregunta que responde: Qué es una red neuronal artificial y cómo aprende: la neurona, las capas, la pérdida, el descenso del gradiente y la retropropagación.
- Fuentes: identificadas 17 → incluidas 13
- Criterios de inclusión: artículos originales del perceptrón, la retropropagación y el transformer, el manual de Goodfellow et al. y documentación oficial de PyTorch, TensorFlow, Google, Python y NumPy; ninguna enciclopedia, blog ni curso.
- Fecha de corte de los datos: 2026-11-11