
Regresión lineal
La regresión lineal es un método que resume con una línea recta cómo cambia una variable cuando cambia otra. La recta tiene dos números: la pendiente, que dice cuánto sube o baja el resultado por cada unidad extra, y el intercepto, su punto de partida. Sirve para predecir y para describir relaciones, no para probar causas.
Última actualización: 2026-11-07
Contenido de esta página
- ¿Qué es la regresión lineal?
- Un ejemplo real: altitud y temperatura en Santander
- ¿Cómo se interpretan la pendiente y el intercepto?
- ¿Qué es el R² y cuándo es bueno?
- ¿Para qué sirve la regresión lineal? Predecir o explicar
- Los tres errores más comunes al leer una regresión lineal
- Lo que esta guía no cubre
- La recta no es el territorio
En 1886, el científico inglés Francis Galton publicó un artículo de título raro: Regression towards Mediocrity in Hereditary Stature, algo así como «regresión hacia lo mediano en la estatura hereditaria» [1]. Había reunido las estaturas de 930 hijos adultos y de sus padres, 205 parejas en total [1]. Para comparar hombres y mujeres en la misma escala, multiplicó cada estatura femenina por 1,08 [1].
Antes había hecho la prueba con semillas. Los hijos de semillas grandes salían más pequeños que sus padres, y los de semillas muy pequeñas, más grandes [1]. Con las familias encontró la misma tendencia y le puso un número.
Ese número fue dos tercios. Según Galton, cuánto se aleja un hijo de la estatura promedio es, en promedio, dos tercios de lo que se alejan sus padres [1]. Si los padres pasaban del promedio por tres pulgadas, lo esperable era que el hijo lo pasara por unas dos.
Ese «dos tercios» es una pendiente: dice cuánto cambia una cosa, en promedio, cuando otra cambia una unidad. Galton llamó a esa vuelta hacia el promedio «ley de regresión» [1]. Es la misma palabra con la que hoy se nombra el método, que se usa para mucho más que estaturas. La lectura, en cambio, sigue siendo la de 1886.
¿Qué es la regresión lineal?
Una regresión lineal toma pares de datos, como altitud y temperatura, y traza entre ellos la línea recta que mejor los acompaña. Esa línea permite dos cosas: estimar una variable a partir de la otra, y medir cuánto cambia en promedio la una cuando cambia la otra. Cuando hay una sola variable que explica, se llama regresión lineal simple.
Las dos variables tienen nombre propio. La que se quiere entender o estimar es la variable respuesta, la que va en el eje vertical. La que se usa para explicarla es la variable explicativa, también llamada predictor. En el caso de Galton, la respuesta era la estatura del hijo y el predictor, la de los padres.
El libro An Introduction to Statistical Learning, de James, Witten, Hastie y Tibshirani, es un manual que sus autores ofrecen para descargar en PDF desde su sitio. Allí la regresión lineal simple aparece como un enfoque muy directo para predecir una respuesta numérica a partir de un solo predictor [2]. El mismo libro advierte que supone una relación que es solo aproximadamente lineal [2]. Esa palabra, aproximadamente, es la mitad de la lectura.
La fórmula de la recta de regresión
La fórmula de la recta de regresión es la de cualquier línea recta, con dos números que salen de los datos:
valor predicho = intercepto + pendiente × variable explicativa
En los libros se escribe ŷ = b₀ + b₁x. El gorrito sobre la y indica que es un valor estimado, no uno observado [2]. El intercepto, b₀, es el valor que da la recta cuando x vale cero. La pendiente, b₁, es cuánto cambia el valor predicho cuando x aumenta en una unidad.
Ningún dato cae exactamente sobre la recta. La distancia vertical entre cada dato y la recta se llama residuo: el valor observado menos el valor predicho [2][3]. Si el residuo es positivo, la recta se quedó corta con ese caso; si es negativo, se pasó [3]. Cómo se escoge la recta entre todas las posibles es un tema propio, el método de mínimos cuadrados. Aquí basta saber que elige la recta que hace más pequeña la suma de los residuos al cuadrado [2].
Un ejemplo real: altitud y temperatura en Santander
Para el ejemplo colombiano tomé datos del IDEAM (Instituto de Hidrología, Meteorología y Estudios Ambientales), la entidad pública de cuya red meteorológica salen. Son sus normales climatológicas: cada una es el promedio de 30 años de mediciones de una estación [4]. Usé la temperatura media anual del periodo 1991-2020 de las 24 estaciones de Santander que trae la tabla [4].
Cualquiera que haya bajado de Bucaramanga hacia el río Magdalena conoce la pregunta en la piel: ¿cuánto calor se gana por cada metro que se baja? Las estaciones van de 114 a 3.214 metros sobre el nivel del mar [4]. Ese rango importa, como se verá en los errores.
El cálculo cabe en pocas líneas de Python con la biblioteca estándar. La función statistics.linear_regression devuelve la pendiente y el intercepto, y está disponible desde la versión 3.10 [5]:
# Regresión lineal simple con la biblioteca estándar de Python (3.10 o posterior)
import statistics

# Altitud (m) y temperatura media anual 1991-2020 (°C) de 24 estaciones del IDEAM en Santander
altitud = [114, 126, 138, 168, 198, 328, 805, 935, 940, 975, 1082, 1090,
           1189, 1350, 1400, 1673, 1690, 1725, 1810, 1900, 2170, 2698, 2841, 3214]
temperatura = [27.4, 28.1, 29.0, 28.8, 27.5, 27.9, 24.5, 22.7, 26.2, 24.8, 25.8, 24.0,
               21.6, 21.9, 21.4, 19.2, 19.4, 18.8, 19.0, 18.1, 16.5, 13.6, 13.8, 9.0]

pendiente, intercepto = statistics.linear_regression(altitud, temperatura)

# Residuo = temperatura observada menos la que predice la recta
predichas = [intercepto + pendiente * x for x in altitud]
residuos = [y - p for y, p in zip(temperatura, predichas)]

# R² = 1 - (variación que queda en los residuos / variación total)
media = statistics.fmean(temperatura)
variacion_total = sum((y - media) ** 2 for y in temperatura)
variacion_residual = sum(e ** 2 for e in residuos)
r2 = 1 - variacion_residual / variacion_total

print(f"Pendiente: {pendiente * 100:.2f} °C por cada 100 m")
print(f"Intercepto: {intercepto:.1f} °C")
print(f"R²: {r2:.2f}")
print(f"Predicción a 1.500 m: {intercepto + pendiente * 1500:.1f} °C")
Al ejecutarlo, el programa imprime:
Pendiente: -0.59 °C por cada 100 m
Intercepto: 29.6 °C
R²: 0.96
Predicción a 1.500 m: 20.7 °C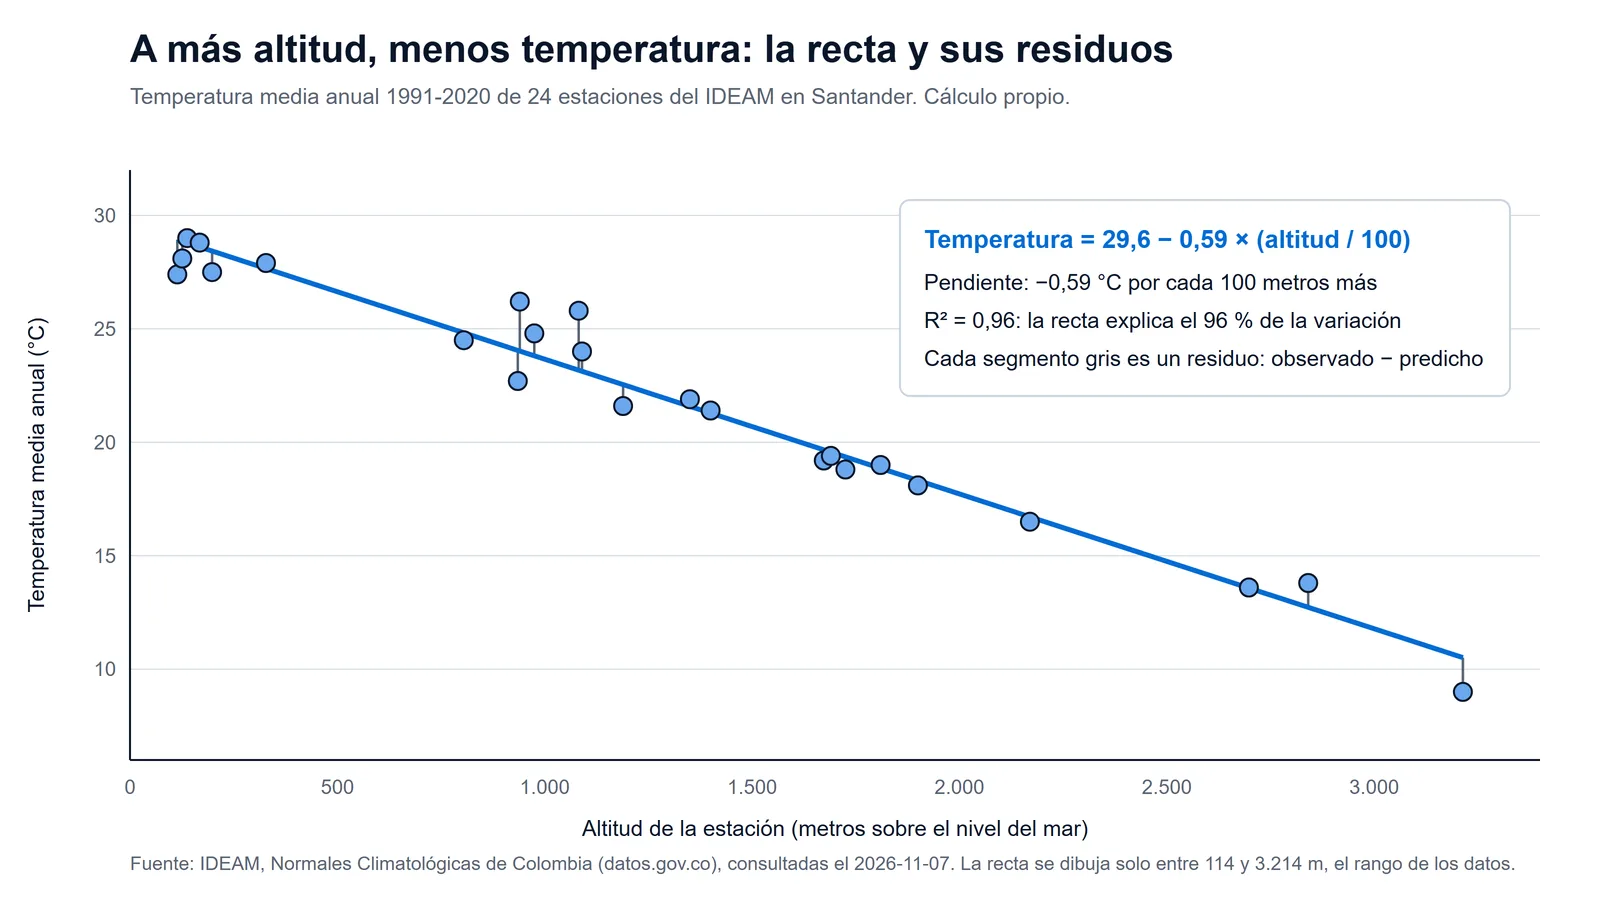
¿Cómo se interpretan la pendiente y el intercepto?
La pendiente y el intercepto se interpretan en las unidades de los datos, nunca como números sueltos. En el ejemplo, la pendiente dice que la temperatura media baja 0,59 grados por cada 100 metros más de altitud. El intercepto dice que, si la recta valiera hasta el nivel del mar, allí marcaría 29,6 grados.
OpenIntro Statistics, un libro de texto abierto, lo formula así: la pendiente describe la diferencia estimada en la respuesta si el caso tuviera una unidad más en la variable explicativa [3]. Del intercepto dice que es el resultado promedio cuando x vale cero, siempre que el modelo valga hasta ese punto, «lo que en muchas aplicaciones no ocurre» [3].
Esta tabla traduce lo que entrega la regresión del ejemplo:
| Lo que entrega la regresión | Valor en el ejemplo | Cómo se lee en palabras |
|---|---|---|
| Pendiente | −0,00594 °C por metro | Por cada 100 m más de altitud, la temperatura media es 0,59 °C menor |
| Intercepto | 29,6 °C | Lo que marcaría la recta a 0 m; ninguna estación de los datos está tan abajo |
| R² | 0,96 | La altitud deja explicado el 96 % de la variación de la temperatura entre estaciones |
| Error estándar residual | 1,05 °C | En promedio, una estación se aparta de la recta alrededor de un grado |
| Predicción a 1.500 m | 20,7 °C | Valor estimado para una altitud que está dentro del rango de los datos |
Fíjese en el signo. Una pendiente negativa no es un error de cálculo: dice que una variable baja cuando la otra sube. Y fíjese en la unidad. Decir «la pendiente es −0,00594» no le sirve a nadie; decir «se pierden casi seis décimas de grado cada 100 metros» se puede contrastar con lo que muestran las estaciones de más y de menos altitud.
El intercepto merece más cuidado. La estación más baja de la tabla está a 114 metros, cerca del cero, así que el valor de 29,6 grados no queda lejos de lo observado. Aun así, es un punto que la recta calcula y que ningún termómetro de estos datos midió.
¿Qué es el R² y cuándo es bueno?
El R², o coeficiente de determinación, es la proporción de la variación de la respuesta que la recta logra explicar. Va de 0 a 1. Un R² de 0,96 quiere decir que la recta deja sin explicar cerca del 4 % de las diferencias de temperatura entre las 24 estaciones.
Se calcula comparando dos variaciones. La total mide cuánto se alejan los datos de su propio promedio, antes de usar la recta. La residual mide cuánto se alejan de la recta. El R² es uno menos la segunda dividida entre la primera [2]. En la regresión lineal simple, además, el R² coincide con el cuadrado de la correlación, la medida de qué tanto se mueven juntas las dos variables [2].
El R² no se compara entre temas distintos. An Introduction to Statistical Learning pone dos extremos [2]. En algunos problemas de física, donde se sabe que los datos vienen de un modelo lineal con poco error, se esperaría un R² muy cercano a 1. En biología, psicología o mercadeo, el mismo libro dice que, en aplicaciones típicas, un R² muy por debajo de 0,1 «podría ser más realista» [2].
El otro número que conviene mirar está en las unidades de la respuesta. El error estándar residual estima, a grandes rasgos, cuánto se aparta, en promedio, un dato de la recta [2]. En el ejemplo da 1,05 °C. Para planear un cultivo, un grado puede importar más que el 0,96 del R².
¿Para qué sirve la regresión lineal? Predecir o explicar
La regresión lineal sirve para dos trabajos distintos: predecir un valor que no se ha medido y describir cómo se asocian dos variables. La misma recta hace los dos, pero la pregunta cambia lo que se exige de ella. Confundir los dos trabajos es el origen de muchas lecturas equivocadas.
Al predecir, lo que importa es acertar. An Introduction to Statistical Learning explica que, en ese caso, el modelo puede tratarse como una caja negra mientras sus predicciones sean buenas [2]. Al explicar, hace falta conocer la forma exacta del modelo, porque la pregunta es qué relación hay entre la respuesta y cada predictor [2]. El libro da un ejemplo de lectura con su conjunto de datos de publicidad. Allí, mil dólares adicionales en anuncios de televisión se asocian, según los autores, con «vender aproximadamente 47,5 unidades adicionales del producto» [2].
| Predecir | Explicar | |
|---|---|---|
| Pregunta | ¿Qué valor tendrá este caso? | ¿Cómo se relacionan las variables? |
| Número que más importa | El error de la predicción | La pendiente y su incertidumbre |
| Ejemplo con los datos de Santander | ¿Qué temperatura media tendría una finca a 1.500 m? | ¿Cuánto baja la temperatura por cada 100 m? |
| Riesgo típico | Usar la recta fuera del rango de los datos | Leer la pendiente como una causa |
Esa última fila adelanta lo que sigue. Los dos riesgos típicos, y un tercero que se esconde detrás del R², son los errores que más se repiten.
Los tres errores más comunes al leer una regresión lineal
Error 1: extrapolar fuera de los datos
Extrapolar es usar la recta en valores de la variable explicativa que no aparecen en los datos. OpenIntro Statistics lo dice sin rodeos: quien extrapola hace «una apuesta poco confiable» a que la relación aproximadamente lineal valga donde no se ha analizado [3].
Con los datos de Santander, la recta predice −0,1 °C de temperatura media para un punto a 5.000 metros. Puede que acierte o puede que no: entre las 24 estaciones no hay ninguna por encima de 3.214 metros, así que los datos no tienen cómo saberlo. La recta no sabe que se acabaron los datos; simplemente sigue.
La propia documentación de Python trae un ejemplo de este riesgo. Con las fechas de estreno de las películas de Monty Python, la recta estima cuántas se habrían hecho hasta 2019 «suponiendo que hubieran mantenido el ritmo» [5]. La advertencia va en la misma frase del ejemplo, y ahí es donde debe ir.
Error 2: leer la pendiente como una causa
Una pendiente mide una asociación, no prueba que una variable mueva a la otra. OpenIntro Statistics lo muestra con los datos de ayudas económicas de una universidad estadounidense [3]. Allí, más ingreso familiar se asocia con menos ayuda. Pero como los datos son observacionales, es decir, recogidos sin un experimento, no se puede afirmar que subir el ingreso de una familia vaya a reducir la ayuda [3].
En el caso de la altitud puede haber buenas razones, ajenas a estos datos, para creer en la relación. Pero esas razones no las aporta la recta. La recta funcionaría igual de bien con dos variables que solo coinciden.
Cuando la pregunta es causal y no hay un experimento, hacen falta métodos que no caben en una recta simple. Las variables instrumentales y otros diseños que se usan para medir efectos de políticas públicas quedan por fuera de esta guía.
Error 3: mirar el R² e ignorar los residuos
Un R² alto no garantiza que la recta sea buena. El NIST, el instituto de normas y tecnología de Estados Unidos, publica un manual de estadística para ingenieros. Allí lo resume así: «un valor alto de R² no garantiza que el modelo se ajuste bien a los datos» [6]. Para el NIST, en la mayoría de los modelos de procesos la herramienta principal de validación es mirar los residuos en gráficos [6].
Los residuos del ejemplo cuentan cosas que el R² no dice. Landázuri y El Palmar están casi a la misma altitud, con solo cinco metros de diferencia [4]. Sin embargo, la primera queda por debajo de la recta y la segunda, bien por encima. Entre las dos hay 3,5 grados de diferencia a casi la misma altura.
| Estación | Altitud (m) | Observada (°C) | Predicha por la recta (°C) | Residuo (°C) |
|---|---|---|---|---|
| Landázuri | 935 | 22,7 | 24,1 | −1,4 |
| El Palmar | 940 | 26,2 | 24,0 | +2,2 |
| Capitanejo | 1.082 | 25,8 | 23,2 | +2,6 |
| Aeropuerto Palonegro (Lebrija) | 1.189 | 21,6 | 22,5 | −0,9 |
| Berlín Automática (Tona) | 3.214 | 9,0 | 10,5 | −1,5 |
Los datos no dicen por qué Capitanejo es 2,6 grados más caliente de lo que predice su altitud. Lo que sí muestran es que algo distinto de la altitud pesa en esas estaciones. Ese «algo» es justo lo que la recta deja en los residuos.
Hay una segunda señal, más sutil. Las nueve estaciones entre 500 y 1.500 metros tienen, en promedio, residuos positivos de medio grado. Las de los otros tramos quedan, en promedio, por debajo de la recta. Con 24 datos es una pista y no una prueba. Pero es el tipo de patrón que el NIST pide buscar: si los residuos muestran una estructura, la forma del modelo puede mejorarse [7].
Lo que esta guía no cubre
Esta guía se queda en la recta con una sola variable explicativa y en cómo leerla. Cuando entran varias variables a la vez, el modelo pasa a ser una regresión lineal múltiple, con su propia lectura. Las condiciones que deben cumplir los datos para confiar en la recta, y cómo revisarlas, también son otro tema.
Si el objetivo es clasificar casos en grupos o predecir con muchos datos y modelos más flexibles, el trabajo entra en el terreno del machine learning, o aprendizaje automático. Para hacer regresiones con bibliotecas como scikit-learn o statsmodels, el punto de partida es Python para análisis de datos. Y el gráfico de puntos que suele acompañar a una regresión tiene su lugar en la guía de tipos de gráficos. El mapa completo de técnicas, de la estadística descriptiva a los modelos, está en la guía de estadística para ciencia de datos.
La recta no es el territorio
Vuelvo a Galton. Su «dos tercios» era una buena descripción de 930 hijos y sus padres [1]. Nunca fue una promesa sobre cada familia ni una explicación de por qué pasaba.
Con los datos de Santander ocurre algo parecido. La recta de 0,59 grados por cada 100 metros es útil para una finca nueva en Zapatoca o en Gámbita, que caen dentro del rango. Es una apuesta para un punto a 4.000 metros, donde no hay ni una estación en los datos. Y es callada sobre Capitanejo, que se sale de la línea por razones que la recta no sabe nombrar.
Por eso, si me toca elegir, prefiero un análisis con un R² modesto y los residuos a la vista que uno con un 0,96 y nada más. El primero dice dónde se equivoca. El segundo invita a creerle en todas partes.
Y eso no es un detalle técnico. Un alcalde, una cooperativa cafetera o una oficina de planeación deciden con estas rectas dónde sembrar, qué riesgo asumir o a quién atender primero. La pregunta que vale la pena hacerle a cualquier regresión que llegue a su escritorio es corta: ¿dónde están los datos que la recta no explica?
Preguntas frecuentes
¿Qué tiene que ver Francis Galton con la regresión lineal? Galton usó la palabra regresión en 1886 para nombrar una tendencia que vio en las familias: los hijos se apartaban del promedio de estatura menos que sus padres [1]. Su regla de los dos tercios relaciona dos medidas con una proporción fija, que es exactamente lo que hace una pendiente. Hoy esa misma lectura se aplica a variables que no tienen nada que ver con la herencia.
¿Qué significa una pendiente cercana a cero? Que, dentro del rango de los datos, la variable explicativa casi no cambia el valor predicho de la respuesta. No significa que no haya ninguna relación: puede haber una relación curva que una recta no capta. Por eso conviene mirar los residuos antes de concluir que dos variables no tienen que ver [3][6].
¿Qué valor de R² se considera bueno? Depende del campo. En un experimento de laboratorio con una ley física detrás se espera un valor muy alto. En psicología o mercadeo, un valor muy bajo puede ser lo realista [2]. Más útil que perseguir un umbral es preguntarse si el error de predicción, en las unidades del problema, es tolerable para la decisión que se va a tomar.
¿Siempre tiene sentido interpretar el intercepto? No. Si en los datos no hay casos con la variable explicativa cerca de cero, el intercepto es una extensión de la recta y puede no tener ningún significado práctico [3]. Una regresión de salario según años de experiencia, por ejemplo, solo puede leer su intercepto si la muestra incluye personas que apenas empiezan.
¿Qué necesito para hacer una regresión lineal en el computador? Basta Python 3.10 o una versión posterior: el módulo statistics de su biblioteca estándar trae la función linear_regression, que devuelve pendiente e intercepto sin instalar nada [5]. Para obtener además errores estándar, intervalos y diagnósticos se usan bibliotecas especializadas, que se explican en la guía de Python para análisis de datos.
Referencias
Las citas en otro idioma son traducción propia.
- Francis Galton. Regression Towards Mediocrity in Hereditary Stature, The Journal of the Anthropological Institute of Great Britain and Ireland, vol. 15, 1886, desde la p. 246 — datos: «the heights of 930 adult children and of their respective parentages, 205 in number»; estaturas femeninas multiplicadas por 1,08; en los experimentos con semillas, la descendencia resultaba «smaller than the parents, if the parents were large; to be larger than the parents, if the parents were very small»; la ley: «the height-deviate of the offspring is, on the average, two-thirds of the height-deviate of its mid-parentage»; «We have only to consider the mid-parentage and not to trouble ourselves about the parents separately». Texto leído en la copia escaneada del artículo publicada en galton.org (extracción con pdftotext). DOI 10.2307/2841583 · Galton.org: copia del artículo de 1886 — Consultada: 2026-11-07.
- Gareth James, Daniela Witten, Trevor Hastie y Robert Tibshirani. An Introduction to Statistical Learning with Applications in R, segunda edición, Springer, impresión corregida del 21 de junio de 2023 — §2.1.1: en la predicción, el modelo «is often treated as a black box», mientras dé predicciones precisas; en la inferencia, «we need to know its exact form»; §3.1: la regresión lineal simple es «a very straightforward approach for predicting a quantitative response Y on the basis of a single predictor variable X. It assumes that there is approximately a linear relationship»; el sombrero indica un valor estimado; residuo: «the difference between the ith observed response value and the ith response value that is predicted»; mínimos cuadrados: escoge los coeficientes que minimizan la suma de los residuos al cuadrado; ejemplo: «an additional $1,000 spent on TV advertising is associated with selling approximately 47.5 additional units of the product»; §3.1.3: el error estándar residual es «roughly speaking, it is the average amount that the response will deviate from the true regression line»; R² = 1 − RSS/TSS, «the proportion of variability in Y that can be explained using X»; en física se esperaría un R² «extremely close to 1» y, en biología, psicología o mercadeo, «an R2 value well below 0.1 might be more realistic!»; en regresión lineal simple, «R2 = r2». PDF gratuito enlazado desde el sitio oficial del libro. Sitio oficial de An Introduction to Statistical Learning · DOI 10.1007/978-1-0716-1418-1 — Consultada: 2026-11-07.
- David Diez, Mine Çetinkaya-Rundel y Christopher D. Barr. OpenIntro Statistics, cuarta edición (2019, actualizada el 21 de octubre de 2022), capítulo 8 — residuo como diferencia entre lo observado y lo esperado; si el modelo subestima una observación, el residuo es positivo, y si la sobrestima, negativo; §8.2.5: «The slope describes the estimated difference in the y variable if the explanatory variable x for a case happened to be one unit larger. The intercept describes the average outcome of y if x = 0 and the linear model is valid all the way to x = 0, which in many applications is not the case»; en los datos de ayuda financiera de Elmhurst College, «we cannot interpret a causal connection between the variables because these data are observational»; el intercepto puede tener poco o ningún valor práctico si no hay observaciones con x cerca de cero; §8.2.6: «If we extrapolate, we are making an unreliable bet that the approximate linear relationship will be valid in places where it has not been analyzed». OpenIntro: OpenIntro Statistics — Consultada: 2026-11-07.
- Instituto de Hidrología, Meteorología y Estudios Ambientales (IDEAM). Normales Climatológicas de Colombia, conjunto de datos en datos.gov.co (licencia CC BY-SA 4.0; filas actualizadas el 13 de octubre de 2026) — «medias mensuales y la media anual de los datos climatológicos, calculadas para períodos de 30 años (1991-2020, 1981-2010, 1971-2000 y 1961-1990)»; filtro usado: periodo 1991-2020, parámetro «TEMPERATURA MEDIA», departamento Santander: 24 estaciones, altitudes de 114 m (El Centro, Barrancabermeja) a 3.214 m (Berlín Automática, Tona); Landázuri 935 m y 22,7 °C; El Palmar 940 m y 26,2 °C; Capitanejo 1.082 m y 25,8 °C. Archivo descargado con la API del portal (md5 2f453761c681fb31e9868dd37f634b27). Datos Abiertos Colombia: Normales Climatológicas de Colombia, IDEAM — Consultada: 2026-11-07.
- Python Software Foundation. statistics — Mathematical statistics functions, documentación de Python 3.15.2 — statistics.linear_regression: «Return the slope and intercept of simple linear regression parameters estimated using ordinary least squares»; ejemplo con las películas de Monty Python para estimar el total hasta 2019 «assuming that they had kept the pace»; «Added in version 3.10». Documentación de Python: módulo statistics — Consultada: 2026-11-07.
- NIST/SEMATECH. e-Handbook of Statistical Methods, §4.4.4 «How can I tell if a model fits my data?» — «Unfortunately, a high R² value does not guarantee that the model fits the data well»; «the primary tool for most process modeling applications is graphical residual analysis». NIST: e-Handbook, §4.4.4 — Consultada: 2026-11-07.
- NIST/SEMATECH. e-Handbook of Statistical Methods, §4.4.4.1 «How can I assess the sufficiency of the functional part of the model?» — «Plots in which the residuals do not exhibit any systematic structure indicate that the model fits the data well»; los que muestran estructura sistemática «indicate that the form of the function can be improved in some way»; «just as the R² statistic cannot justify a particular model on its own, no single residual plot can completely justify the adoption of a particular model either». NIST: e-Handbook, §4.4.4.1 — Consultada: 2026-11-07.
Cómo investigamos esta página
- Pregunta que responde: Qué es la regresión lineal simple y cómo se leen su pendiente, su intercepto y su R², con sus tres errores más comunes.
- Fuentes: identificadas 10 → incluidas 7
- Criterios de inclusión: libros abiertos de estadística, manual del NIST, documentación oficial de Python, el artículo original de Galton y datos abiertos del IDEAM; ninguna enciclopedia, blog ni curso.
- Fecha de corte de los datos: 2026-11-07