Estadística para ciencia de datos
La estadística para ciencia de datos es el conjunto de métodos para resumir datos, medir la incertidumbre y pasar de una muestra a conclusiones sobre toda una población. Aquí verá qué parte usa de verdad el oficio, el mapa de cuatro bloques, qué técnica responde cada pregunta y en qué orden estudiarla.
Última actualización: 2026-10-16
Contenido de esta página
- ¿Qué es la estadística para ciencia de datos?
- ¿Qué estadística necesita un científico de datos?
- El mapa de la estadística: descriptiva, probabilidad, inferencia y modelos
- ¿Qué técnica estadística responde cada pregunta?
- Un ejemplo real: el desempleo del DANE también trae margen de error
- ¿Dónde termina la estadística y empieza la econometría?
- Ruta para aprender estadística para ciencia de datos
- Mapa de las guías de estadística para ciencia de datos
- Lo que no le importaba al maestro cervecero
En marzo de 1908, la revista científica Biometrika publicó un artículo firmado por un tal «Student» [1]. Se titulaba The Probable Error of a Mean, algo así como «el error probable de una media». Detrás del seudónimo estaba William Sealy Gosset, maestro cervecero y científico experimental de la cervecería Guinness, en Dublín [2]. Su empleador exigía que su identidad quedara oculta para los competidores [2].
Gosset tenía un problema de fábrica, no de pizarra. Su artículo lo explica: hay experimentos que no se pueden repetir muchas veces, y entre ellos pone a la mayoría de los ensayos agrícolas [1]. En esos casos toca juzgar la certeza de un resultado con una muestra muy pequeña, es decir, con muy pocos casos observados [1].
El último ejemplo del artículo cabe en una mesa. Compara semilla de cebada secada al horno con semilla sin secar, en once ensayos de 1899 y 1900 [1]. La semilla secada dio en promedio más grano y más paja, pero de calidad casi siempre inferior [1]. Con sus cálculos, Gosset estimó probabilidades de unas 14 contra 1 de que la semilla secada rindiera más [1].
Sus tablas permitían juzgar si una serie de ensayos, por corta que fuera, ya daba la precisión exigida o si había que seguir investigando [1].
¿Cuánto le creo a lo que dicen unos pocos datos? Esa es la pregunta de fondo de la estadística para ciencia de datos. Más de un siglo después, se la hace el analista que revisa las ventas de una tienda. Se la hace también el DANE, la entidad que produce las cifras oficiales de Colombia, cada vez que publica el desempleo.
¿Qué es la estadística para ciencia de datos?
La estadística para ciencia de datos es la parte del oficio que dice cuánto confiar en un resultado. Resume lo que muestran los datos, mide el azar y permite pasar de los casos observados a conclusiones sobre todos los demás. Sin ella, un científico de datos produce cifras; con ella, produce cifras con su margen de duda.
El libro abierto OpenIntro Statistics la define como el estudio de cómo recoger y analizar datos, y cómo sacar conclusiones de ellos, de la mejor manera [3]. Esa definición tiene tres verbos, y los tres importan. Recoger mal no se arregla analizando bien.
En Colombia hay un ejemplo de todos los meses. La Gran Encuesta Integrada de Hogares (GEIH) es la encuesta del DANE (Departamento Administrativo Nacional de Estadística) que mide el empleo. Para revisar sus resultados, su metodología describe dos tipos de análisis [4]. El descriptivo observa la muestra con tablas, gráficos y medidas de tendencia y dispersión [4]. Del inferencial dice: «Tiene como objetivo realizar la estimación de la muestra a la población objetivo» [4].
Esa frase resume media guía. La otra mitad son los modelos que relacionan variables y la probabilidad, que sostiene a todo lo demás.
¿Estadística o ciencia de datos? Quién hace qué
La estadística es una de las disciplinas que forman la ciencia de datos, junto con la programación y el conocimiento del tema que se estudia. La ciencia de datos recorre el ciclo completo, desde la pregunta hasta la decisión. La estadística aporta el criterio para saber cuándo un patrón es real y cuándo es ruido.
El proceso de revisar datos hasta sacar una conclusión, con sus etapas, tiene su propia guía: análisis de datos. Allí la estadística aparece como una etapa. Aquí se abre esa etapa para ver qué lleva dentro.
¿Qué estadística necesita un científico de datos?
Un científico de datos necesita cuatro bloques de estadística, y en este orden: describir datos, razonar con probabilidades, sacar conclusiones de una muestra y construir modelos que relacionan variables. Al empezar no necesita las demostraciones de un estadístico profesional. Sí necesita entender qué supone cada técnica y cuándo deja de valer.
Ese orden no es una ocurrencia mía. OpenIntro Statistics es un libro de introducción que se usa, según su propia editorial, desde institutos técnicos hasta universidades de élite [3]. Avanza así: datos, resumen de datos, probabilidad, distribuciones, fundamentos de la inferencia y, al final, regresión [3]. El curso de probabilidad y estadística del MIT (Instituto Tecnológico de Massachusetts), publicado gratis en su portal OpenCourseWare, sigue un arco parecido. Empieza por la probabilidad y termina en pruebas de significancia, intervalos de confianza y regresión lineal [5].
Lo que veo en el día a día del oficio es menos vistoso de lo que prometen los cursos. La mayor parte del tiempo se va en el primer bloque: contar, promediar, comparar grupos, encontrar datos raros. Los modelos llegan después, y llegan mejor cuando el primer bloque se hizo con cuidado.
Hay algo que pesa más que cualquier fórmula: saber de dónde salieron los datos. OpenIntro lo muestra con un caso. Si solo el 30 % de las personas elegidas al azar para una encuesta responde, no está claro que los resultados representen a toda la población [3]. Ninguna técnica posterior corrige eso por sí sola.
El mapa de la estadística: descriptiva, probabilidad, inferencia y modelos
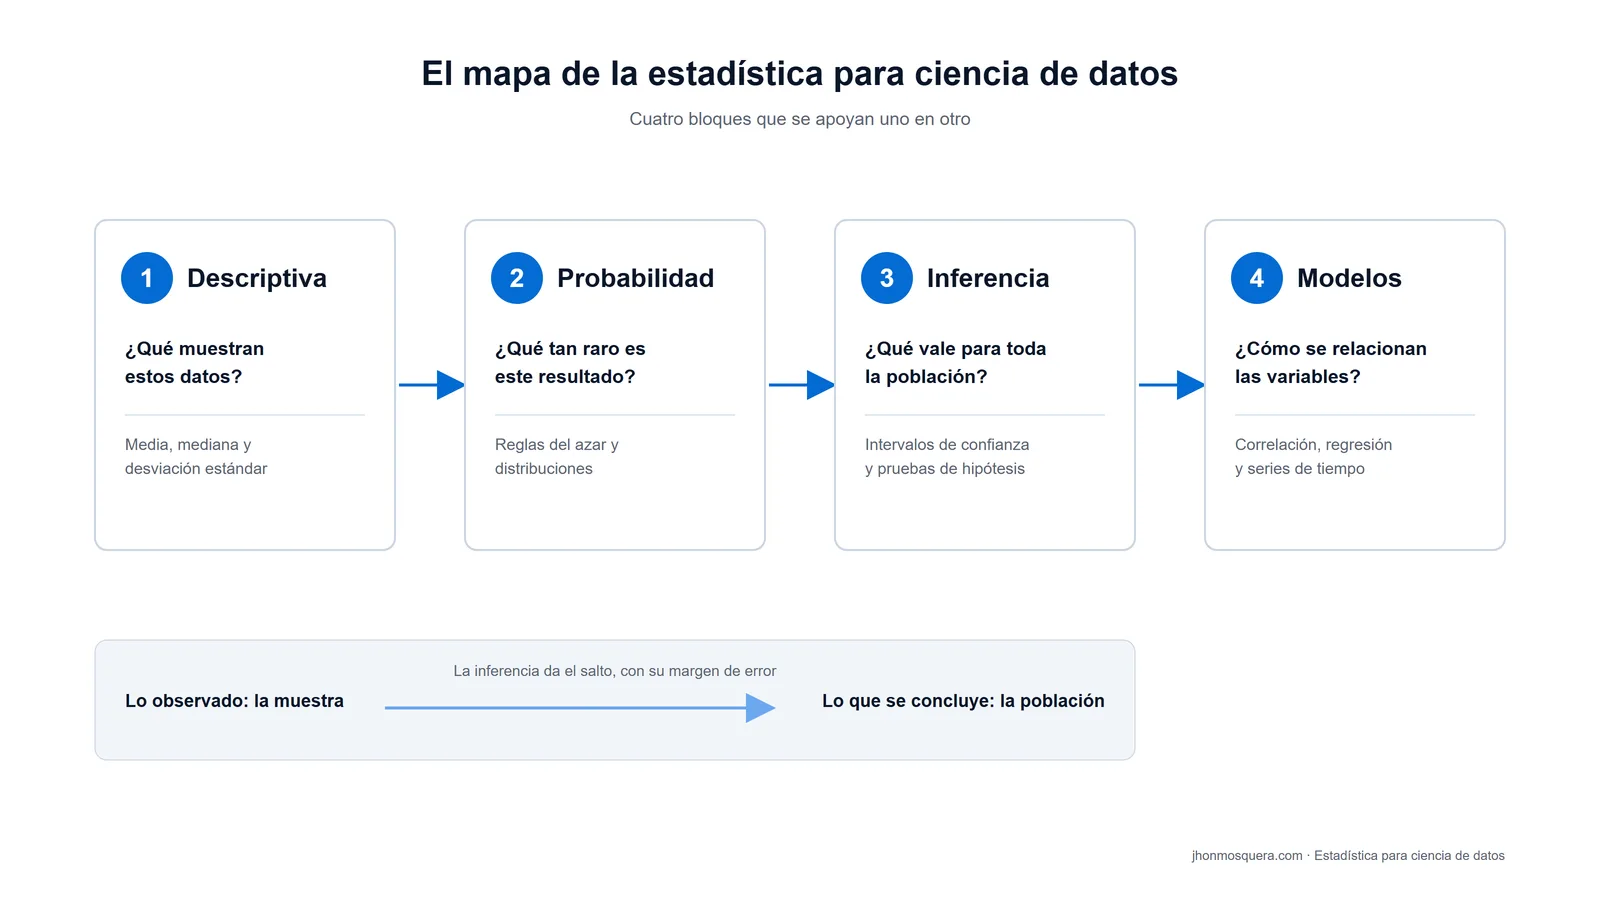
El mapa de la estadística para ciencia de datos tiene cuatro bloques que se apoyan uno en otro. La estadística descriptiva resume lo que hay. La probabilidad mide qué tan raro es un resultado. La inferencia extiende lo observado a una población, y los modelos explican o anticipan cómo se mueve una variable cuando cambia otra.
Estadística descriptiva: resumir lo que hay
La estadística descriptiva resume un conjunto de datos con pocas cifras y tablas. Responde qué valor es típico y cuánto se alejan los datos de ese valor. Sus herramientas básicas son tres. La media es el promedio. La mediana es el valor del centro cuando se ordenan los datos. La desviación estándar dice cuánto se separan los datos del promedio, en las mismas unidades.
No dice nada sobre los casos que no se observaron. Esa es su fuerza y su límite. Si una tienda de Bucaramanga resume las compras de sus 300 clientes del mes, la descripción vale para esos 300.
Probabilidad: el lenguaje del azar
La probabilidad mide qué tan posible es un resultado, en una escala de 0 a 1. En ciencia de datos sirve como lenguaje: permite decir qué tanto se esperaría un resultado si solo actuara el azar. Sin ese lenguaje, la inferencia no tiene cómo expresar su duda.
El curso del MIT lo plantea con una distinción útil. En la probabilidad, el mundo es incierto, pero esa incertidumbre se conoce a la perfección [5]. En la estadística aplicada hay datos de un mundo incierto y un conocimiento imperfecto de esa incertidumbre [5]. Ahí está el salto.
Inferencia: de la muestra a la población
La inferencia es el paso de lo que se midió en una muestra a lo que probablemente pasa en toda la población. Una muestra es el grupo de casos que sí se observaron; la población, el total al que se quiere aplicar la conclusión. Gosset lo escribió en 1908: «Una serie de experimentos es una muestra extraída de esta población» [1].
La inferencia siempre entrega dos cosas: una estimación y su margen de error. Un intervalo de confianza, por ejemplo, es un rango calculado con un método que acierta en una proporción fijada de antemano de las muestras posibles, casi siempre el 95 %. OpenIntro separa el error de una estimación en dos partes [3]. El error de muestreo cambia de una muestra a otra. El sesgo es una tendencia sistemática a pasarse o a quedarse corto [3].
Modelos: relaciones entre variables
Un modelo estadístico es una fórmula que describe cómo se relaciona una variable con otras, con un término que reconoce el azar. La regresión lineal estima cuánto cambia en promedio una variable cuando otra aumenta en una unidad. Las series de tiempo modelan datos ordenados por fecha, como las ventas de cada mes.
Aquí la estadística toca a su vecino más famoso. Cuando el objetivo deja de ser explicar y pasa a ser predecir o clasificar con muchas variables, el trabajo entra en el terreno del machine learning, o aprendizaje automático. Usa muchas de las mismas ideas, pero con otra pregunta en el centro.
¿Qué técnica estadística responde cada pregunta?
La técnica estadística correcta depende de la pregunta, no del programa que se tenga a mano. Esta tabla es una guía de entrada: va de la pregunta que trae el analista a la familia de técnicas que la responde. Cada familia tiene supuestos y variantes que se explican en su guía propia.
| Si su pregunta es… | Bloque | Familia de técnicas |
|---|---|---|
| ¿Cuál es el valor típico y cuánto varían los datos? | Descriptiva | Media, mediana, desviación estándar, cuartiles |
| ¿Cómo se reparten los datos entre categorías? | Descriptiva | Tablas de frecuencias y porcentajes |
| ¿Qué tan probable es que ocurra algo? | Probabilidad | Reglas de la probabilidad y distribuciones |
| ¿Qué tan probable es algo, sabiendo que ya pasó otra cosa? | Probabilidad | Probabilidad condicional y teorema de Bayes |
| ¿Cuánto vale en toda la población lo que medí en la muestra? | Inferencia | Estimación e intervalos de confianza |
| ¿La diferencia que veo es real o puede ser azar? | Inferencia | Prueba de hipótesis y valor p |
| ¿Cuál de dos versiones funciona mejor con clientes reales? | Inferencia en un experimento | Prueba A/B |
| ¿Dos variables se mueven juntas? | Modelos | Correlación |
| ¿Cuánto cambia una variable cuando cambia otra? | Modelos | Regresión lineal |
| ¿Qué pasará el próximo mes, según los meses anteriores? | Modelos | Series de tiempo |
Una lectura práctica de la tabla. Las dos primeras filas se pueden trabajar en una hoja de cálculo el primer día. Las de inferencia exigen entender antes la probabilidad, o los resultados se vuelven recetas que nadie sabe leer.
Hay una trampa común en la fila de la prueba de hipótesis. Su resultado más conocido, el valor p, indica qué tan incompatibles son los datos con un modelo estadístico dado. No mide la probabilidad de que una hipótesis sea cierta, según la Asociación Estadounidense de Estadística (ASA, por su sigla en inglés) [6].
Un ejemplo real: el desempleo del DANE también trae margen de error
El desempleo que publica el DANE cada mes es una estimación, no un conteo de todo el país. Sale de la GEIH, una encuesta por muestreo probabilístico: los hogares se escogen al azar con reglas conocidas [7]. Por eso cada cifra viene con su margen de error, y leerla bien es un ejercicio completo de estadística para ciencia de datos.
La muestra es grande, pero es muestra. En promedio, el DANE espera encuestar cada mes 25.470 hogares en todo el país [7]. Cada hogar encuestado representa a muchos otros que no lo fueron [4]. Ese peso se llama factor de expansión: el número que dice a cuántos hogares de la población representa cada hogar de la muestra.
El factor de expansión se ajusta cuando la realidad golpea la muestra. Para las cifras de agosto de 2026, el DANE lo recalculó por los segmentos de muestra perdidos tras el sismo del 10 de agosto, por viviendas destruidas o inhabitables [8].
Ahora el dato. La tasa de desocupación del total nacional fue 9,4 % en agosto de 2026, frente a 8,6 % en el mismo mes de 2025 [8]. Esa tasa es el porcentaje de la fuerza de trabajo, es decir, de quienes trabajan o buscan trabajo, que está sin empleo y buscándolo [9].
El anexo del boletín le pone a esa cifra su error relativo, también llamado coeficiente de variación: el tamaño del error estándar como porcentaje de la estimación [4][9]. Para la tasa nacional de agosto fue de 3,2 % [9]. Con ese dato se puede rehacer a mano el intervalo de confianza que publica el DANE:
- El error estándar, que mide cuánto variaría la cifra de una muestra a otra, es 9,36 × 0,032: unos 0,30 puntos.
- El margen de error al 95 % sale de multiplicar por 1,96: unos 0,59 puntos.
- El intervalo va de 8,78 % a 9,95 %, que son los mismos límites del anexo [9].
La misma hoja trae una columna que casi nadie mira: «Variación estadísticamente significativa». Para la tasa de desocupación, la respuesta es «no» [9]. Como el boletín compara agosto de 2026 con agosto de 2025, leo esa marca así. Con esta muestra, el salto de 8,6 % a 9,4 % no se distingue con seguridad del vaivén propio de encuestar unos hogares y no otros.
No significa que el desempleo no haya subido. Significa que la encuesta no alcanza a demostrarlo con el nivel de confianza fijado. En la misma hoja, la tasa de ocupación, la parte de la población en edad de trabajar que tiene empleo, sí aparece con una variación significativa [9]. Cada indicador tiene su propio error.
El DANE fija de antemano la precisión que busca. Su diseño apunta a un error relativo de 5,5 % para las ciudades, con un intervalo de confianza del 95 % [7]. Y advierte que las tasas menores al 10 % pueden presentar errores de muestreo superiores al 5 %: es una precaución, no una regla que se cumpla siempre [8].
¿Dónde termina la estadística y empieza la econometría?
La estadística termina donde la pregunta deja de ser «¿estas variables se mueven juntas?» y pasa a ser «¿esta política económica causó este resultado?». Para la segunda, la economía desarrolló una disciplina propia: la econometría, la rama que usa la estadística para medir relaciones económicas. Trabaja con datos que muchas veces no vienen de un experimento.
El límite tiene una base clara. OpenIntro advierte que, en general, la asociación no implica causalidad, y que la causalidad solo puede inferirse de un experimento aleatorizado [3]. Un experimento aleatorizado reparte los casos al azar entre grupos, como cuando se lanza una moneda para decidir quién recibe un tratamiento.
En economía pocas veces se puede lanzar esa moneda. Nadie sortea qué país sube su salario mínimo. Por eso la econometría construyó métodos propios, y el Nobel de Economía, el premio que instituyó el Banco de Suecia en memoria de Alfred Nobel, los ha reconocido. En 1989 premió a Trygve Haavelmo por aclarar los fundamentos de la econometría en la teoría de la probabilidad [10]. En 2021, la mitad del premio fue para Joshua Angrist y Guido Imbens por sus contribuciones metodológicas al análisis de relaciones causales [11].
Hasta aquí llega esta guía. La econometría como disciplina, con sus modelos económicos, tendrá su propia guía en la sección de economía del sitio.
Lo que tampoco está en esta guía
Esta guía explica qué hace cada bloque de la estadística, no cómo se calcula en un programa. Cómo sacar promedios, pruebas y regresiones con código está en Python para análisis de datos. Cómo hacerlo con fórmulas y tablas dinámicas está en Excel para análisis de datos. Y cómo diseñar el gráfico que muestra el resultado está en visualización de datos.
Ruta para aprender estadística para ciencia de datos
La ruta más corta para aprender estadística para ciencia de datos sigue el mismo orden del mapa. Primero se aprende a describir, luego a razonar con probabilidades, después a inferir y al final a modelar. Saltarse un bloque se paga en el siguiente: quien llega a la regresión sin entender la variabilidad no sabe leer lo que le devuelve el programa.
Mi propuesta tiene cinco pasos:
- Las matemáticas mínimas. Fracciones, porcentajes, potencias y la lectura de una fórmula. El álgebra lineal y el cálculo pueden esperar hasta los modelos. Tendrán su guía de matemáticas para ciencia de datos.
- Describir datos reales. Tome una tabla del DANE y calcule a mano la media, la mediana y la desviación estándar de una columna. Mire qué le pasa a la media cuando aparece un dato extremo.
- Probabilidad básica. Reglas de suma y producto, probabilidad condicional y la idea de distribución. Aquí conviene simular: lanzar monedas en el computador enseña más que tres teoremas.
- Inferencia. Muestra, población, error estándar, intervalos de confianza y pruebas de hipótesis. Es el bloque más difícil y el que más se malinterpreta.
- Modelos. Correlación, regresión lineal y series de tiempo. Con esto ya se puede leer con criterio el trabajo de machine learning.
Hay dos recursos gratuitos de calidad para recorrer esa ruta. OpenIntro Statistics, cuarta edición, se descarga libre en PDF, el formato de documento que se abre en cualquier computador o celular [3]. El libro también está disponible con licencia Creative Commons, una licencia abierta, y sus archivos fuente están publicados [3]. El curso 18.05 del MIT publica lecturas, ejercicios y exámenes, aunque pide como base cálculo de varias variables [5].
El precio cero tiene letra pequeña. Los dos recursos están en inglés, y eso en Colombia deja por fuera a mucha gente. El camino completo del oficio, con los seis roles y el orden de estudio, está en la guía cómo aprender ciencia de datos.
Mapa de las guías de estadística para ciencia de datos
Las guías de estadística para ciencia de datos siguen el orden de la ruta. Todas están en preparación; cuando se publiquen, cada una tendrá su enlace aquí.
| Guía | Qué responde | Estado |
|---|---|---|
| Matemáticas para ciencia de datos | Qué álgebra, cálculo y álgebra lineal hacen falta, y cuándo | Próximamente |
| Estadística descriptiva | Cómo resumir un conjunto de datos con medidas y tablas | Próximamente |
| Probabilidad | Cómo medir y combinar probabilidades | Próximamente |
| Estadística inferencial | Cómo pasar de una muestra a una población | Próximamente |
| Prueba de hipótesis | Cómo decidir si una diferencia es real o puede ser azar | Próximamente |
| Correlación | Cómo medir si dos variables se mueven juntas | Próximamente |
| Regresión lineal | Cómo estimar cuánto cambia una variable cuando cambia otra | Próximamente |
| Series de tiempo | Cómo analizar y proyectar datos ordenados por fecha | Próximamente |
| Pruebas A/B | Cómo comparar dos versiones con un experimento | Próximamente |
Lo que no le importaba al maestro cervecero
Vuelvo a Gosset. Su seudónimo quedó pegado a la t de Student, la tabla contra la que todavía se compara un resultado para declararlo «significativo» [2]. En 2008, Stephen Ziliak revisó su obra en el Journal of Economic Perspectives, una revista de la Asociación Económica Estadounidense, y encontró una ironía [2]. Desde 1904, Gosset abordó la lógica de la incertidumbre con un enfoque económico. Terminó por considerar la significancia estadística, por sí sola, «casi sin valor» [2].
Le preocupaba, a mi modo de ver, algo más terrenal: cuánto rendía la cebada y cuánto costaba equivocarse. Más de un siglo después, la ASA dijo algo muy cercano en una declaración de 2016. Su tercer principio dice: «Las conclusiones científicas y las decisiones empresariales o de política no deberían basarse solo en si un valor p supera un umbral específico» [6].
A mi juicio, ahí está la estadística que de verdad necesita la ciencia de datos. No es la que reparte asteriscos en una tabla. Es la que obliga a decir cuánto se sabe y cuánto no antes de decidir.
Esa honestidad va más allá del oficio. Cuando el DANE publica el margen de error junto al desempleo, le da a cualquier ciudadano la herramienta para no tragarse un titular. La pregunta para quien empieza es sencilla. ¿Qué cifra de su trabajo entrega hoy sin su margen de duda?
Preguntas frecuentes
¿Cuánta estadística necesita saber un científico de datos? La suficiente para elegir una técnica, revisar sus supuestos y explicar su resultado sin el programa delante. A mi juicio, eso equivale a un curso universitario de introducción bien hecho, de los que llegan hasta la regresión lineal [3][5]. Las demostraciones profundas sirven para inventar métodos nuevos. Para aplicar bien los existentes pesa más el criterio que la teoría avanzada.
¿Qué es más importante en ciencia de datos, la estadística o la programación? Se necesitan las dos, pero fallan de forma distinta. En mi experiencia, un error de programación suele romper el código y se nota. Un error de estadística produce un número limpio y equivocado que nadie cuestiona. Por eso recomiendo no dejar la estadística para después: es la parte del trabajo que no da mensajes de error.
¿Se puede aprender estadística para ciencia de datos gratis? Sí. El libro OpenIntro Statistics se descarga sin costo desde su sitio oficial [3]. El MIT ofrece su curso de introducción a la probabilidad y la estadística con materiales abiertos, también disponibles en su Open Learning Library [5]. El costo real está en las horas de estudio y en el inglés, porque ambos recursos están en ese idioma.
¿Qué diferencia hay entre estadística y machine learning? Comparten herramientas, pero no la pregunta principal. La estadística suele buscar explicar una relación y medir cuánta confianza merece. El machine learning suele buscar predecir o clasificar casos nuevos con el menor error posible. Una regresión lineal puede servir a los dos fines, y por eso esa frontera se cruza a diario.
¿Sirve la estadística cuando se tienen millones de datos? Sirve, y a veces más. Una muestra más grande reduce el error estándar, es decir, la variación de una muestra a otra [3]. Pero no corrige el sesgo: si los datos se recogieron de una forma que favorece a un grupo, millones de filas repiten el mismo error [3]. La ASA señala que la abundancia de conjuntos de datos grandes y complejos amplió el alcance de la estadística [6].
Referencias
Las citas en otro idioma son traducción propia.
- Student [William Sealy Gosset]. The Probable Error of a Mean, Biometrika, vol. 6, n.º 1, marzo de 1908, pp. 1-25 — «Any experiment may be regarded as forming an individual of a “population” of experiments which might be performed under the same conditions. A series of experiments is a sample drawn from this population»; «There are other experiments, however, which cannot easily be repeated very often; in such cases it is sometimes necessary to judge of the certainty of the results from a very small sample», y en esa clase entran «most agricultural and large-scale experiments»; ejemplo final con cebada secada al horno y sin secar (siete variedades en 1899 y cuatro en 1900: «there being eleven experiments»); la semilla secada dio en promedio la mayor producción de grano y paja, «but that the quality was almost always inferior»; «the odds are about 14 to 1 that kiln-dried corn gives the higher yield»; conclusión 4: las tablas permiten juzgar si una serie de experimentos, «however short», alcanza la precisión requerida «or whether it is necessary to continue the investigation». Texto leído en la transcripción del sitio de historia de la estadística de la Universidad de York. DOI 10.2307/2331554 · Universidad de York: transcripción de The Probable Error of a Mean — Consultada: 2026-10-16.
- Stephen T. Ziliak. Retrospectives: Guinnessometrics: The Economic Foundation of “Student’s” t, Journal of Economic Perspectives, vol. 22, n.º 4, 2008, pp. 199-216 — según el resumen publicado por la American Economic Association, la rutina canónica compara un estadístico t con el valor de la tabla t de «Student»; la primera presentación de la prueba llegó en 1908 en The Probable Error of a Mean, de un anónimo «Student»; «The author’s commercial employer required that his identity be shielded from competitors»; el autor fue William Sealy Gosset (1876-1937), «whose entire career was spent at Guinness’s brewery in Dublin, where Gosset was a master brewer and experimental scientist»; «Beginning in 1904, “Student,” who was a businessman besides a scientist, took an economic approach to the logic of uncertainty, arguing finally that statistical significance is “nearly valueless” in itself». AEA: Guinnessometrics, Journal of Economic Perspectives · DOI 10.1257/jep.22.4.199 — Consultada: 2026-10-16.
- David Diez, Mine Çetinkaya-Rundel y Christopher D. Barr. OpenIntro Statistics, cuarta edición (2019, actualizada el 21 de octubre de 2022), y página oficial del libro — «Statistics is the study of how best to collect, analyze, and draw conclusions from data»; capítulos: introducción a los datos, resumen de datos, probabilidad, distribuciones, fundamentos de la inferencia, inferencia para datos categóricos y numéricos, regresión lineal, y regresión múltiple y logística; §1.3.3: si solo responde el 30 % de las personas muestreadas al azar, no está claro que los resultados representen a la población (sesgo de no respuesta); §1.2.5: «In general, association does not imply causation, and causation can only be inferred from a randomized experiment»; §5.1.1: el error de una estimación tiene dos componentes, «sampling error and bias», y el sesgo es «a systematic tendency to over- or under-estimate the true population value»; §5.1.4: una muestra más grande corresponde a un error estándar más pequeño; «This book may be downloaded as a free PDF at openintro.org/os. This textbook is also available under a Creative Commons license, with the source files hosted on Github»; la página del libro lo presenta como usado «at Community Colleges to the Ivy League». OpenIntro: OpenIntro Statistics — Consultada: 2026-10-16.
- Departamento Administrativo Nacional de Estadística (DANE). Metodología general Gran Encuesta Integrada de Hogares (GEIH), DSO-GEIH-MET-001, versión 11, 16 de junio de 2023 — métodos de análisis: «Análisis descriptivo. Ayuda a observar el comportamiento de la muestra en estudio, por medio de tablas, gráficos, intervalos de confianza y estadísticas de tendencia y dispersión»; «Análisis inferencial. Tiene como objetivo realizar la estimación de la muestra a la población objetivo. En este proceso, se aplican los factores de expansión»; especificación técnica de los factores de expansión de la encuesta (factor básico y factor calibrado por vivienda); «En la investigación se presentan los coeficientes de variación estimados (errores relativos)»; «El coeficiente de variación se define como la relación porcentual del error estándar del estimador y el valor esperado del estimador». DANE: Metodología general GEIH, versión 11 — Consultada: 2026-10-16.
- MIT OpenCourseWare. 18.05 Introduction to Probability and Statistics, primavera de 2022, Jeremy Orloff y Jennifer French Kamrin: portada y programa — temas: combinatoria básica, variables aleatorias, distribuciones de probabilidad, inferencia bayesiana, pruebas de hipótesis, intervalos de confianza y regresión lineal; arco del curso: «Probability (uncertain world, perfect knowledge of the uncertainty)» y «Statistics II: applied probability (data in an uncertain world, imperfect knowledge of the uncertainty)», que incluye pruebas de significancia frecuentistas, intervalos de confianza y regresión lineal; prerrequisito: 18.02 Multivariable Calculus; materiales de lectura, ejercicios y exámenes; los mismos materiales están disponibles en la Open Learning Library del MIT, «which is free to use». MIT OpenCourseWare: 18.05 · MIT OpenCourseWare: 18.05, programa — Consultada: 2026-10-16.
- American Statistical Association (ASA). Ronald L. Wasserstein y Nicole A. Lazar, The ASA’s Statement on p-Values: Context, Process, and Purpose, The American Statistician, vol. 70, n.º 2, 2016, y comunicado de prensa de la ASA del 7 de marzo de 2016 — principio 1: «P-values can indicate how incompatible the data are with a specified statistical model»; principio 2: «P-values do not measure the probability that the studied hypothesis is true, or the probability that the data were produced by random chance alone»; principio 3: «Scientific conclusions and business or policy decisions should not be based only on whether a p-value passes a specific threshold»; el comunicado señala que «a proliferation of large, complex data sets has expanded the scope for statistics». DOI 10.1080/00031305.2016.1154108 · ASA: comunicado sobre la declaración de valores p — Consultada: 2026-10-16.
- Departamento Administrativo Nacional de Estadística (DANE). Ficha metodológica Gran Encuesta Integrada de Hogares, DSO-GEIH-FME-001, versión 11, 14 de junio de 2023 — tipo de operación: «Encuesta por muestreo probabilístico»; diseño muestral «probabilístico, multietápico, estratificado y de conglomerados»; tamaño de muestra: «En promedio se espera encuestar mensualmente 18.500 hogares en las 32 ciudades capitales de departamento y 6.970 en el resto de cabecera, centro poblado y rural disperso, para un total de 25.470 hogares»; precisión: «Se fija un error relativo (CV) de 5,5% y un intervalo de confianza de 95% para todas las ciudades». DANE: Ficha metodológica GEIH, versión 11 — Consultada: 2026-10-16.
- Departamento Administrativo Nacional de Estadística (DANE). Boletín técnico Gran Encuesta Integrada de Hogares (GEIH), agosto 2026, 30 de septiembre de 2026 — «Para el mes de agosto de 2026, la tasa de desocupación del total nacional fue 9,4%, mientras que en el mismo mes de 2025 fue 8,6%»; por las afectaciones del sismo del 10 de agosto de 2026 en municipios de la muestra, «se realizó un ajuste en los factores de expansión, teniendo en cuenta los segmentos de muestra perdidos debido a la destrucción o inhabitabilidad de las viviendas»; nota 2: «Las tasas menores al 10% pueden presentar errores de muestreo superiores al 5%». DANE: Boletín técnico GEIH, agosto 2026 — Consultada: 2026-10-16.
- Departamento Administrativo Nacional de Estadística (DANE). Anexo estadístico GEIH, agosto 2026 (actualizado el 30 de septiembre de 2026) — hoja «Errores relativos», total nacional, agosto 2026, tasa de desocupación: «Variación estadísticamente significativa» = «NO», límite inferior 8,7766, límite superior 9,9507, error relativo 0,031986; tasa de ocupación: «Variación estadísticamente significativa» = «SI»; hoja «Total nacional»: tasa de desocupación de agosto de 2026 = 9,3637; hoja «Ficha metodológica»: la tasa de desocupación es la «relación porcentual entre el número de personas desocupadas (DS) y el número de personas que integran la fuerza de trabajo (FT)», y la fuerza de trabajo «comprende a las personas en edad de trabajar que trabajan o están buscando trabajo y están disponibles». DANE: anexo estadístico GEIH, agosto 2026 — Consultada: 2026-10-16.
- Nobel Prize Outreach. The Sveriges Riksbank Prize in Economic Sciences in Memory of Alfred Nobel 1989 — otorgado a Trygve Haavelmo «for his clarification of the probability theory foundations of econometrics and his analyses of simultaneous economic structures». NobelPrize.org: premio de Economía 1989 — Consultada: 2026-10-16.
- Nobel Prize Outreach. The Sveriges Riksbank Prize in Economic Sciences in Memory of Alfred Nobel 2021 — una mitad para David Card «for his empirical contributions to labour economics» y la otra mitad, conjunta, para Joshua D. Angrist y Guido W. Imbens «for their methodological contributions to the analysis of causal relationships». NobelPrize.org: premio de Economía 2021 — Consultada: 2026-10-16.
Cómo investigamos esta página
- Pregunta que responde: Qué estadística usa de verdad la ciencia de datos, en qué orden se aprende y cómo se lee el margen de error de una cifra oficial.
- Fuentes: identificadas 26 → incluidas 15
- Criterios de inclusión: el artículo original de «Student» (1908), un libro de texto abierto, un curso abierto del MIT, la declaración de la ASA y documentos oficiales del DANE; nada de enciclopedias ni sitios de tutoriales.
- Fecha de corte de los datos: 2026-10-16