
Estadística descriptiva
La estadística descriptiva es la parte de la estadística que ordena, resume y muestra los datos que ya se tienen, con tablas de frecuencias, unas pocas medidas y gráficos. No saca conclusiones sobre quienes no se observaron: eso le toca a la inferencial. Aquí verá su flujo de cuatro pasos, la diferencia entre ambas y un ejemplo con datos reales.
Última actualización: 2026-11-07
Contenido de esta página
- ¿Qué es la estadística descriptiva?
- El flujo de la estadística descriptiva en cuatro pasos
- Ejemplo de estadística descriptiva con microdatos del DANE
- Diferencia entre estadística descriptiva e inferencial
- Errores típicos al resumir datos
- ¿Con qué herramienta se hace la estadística descriptiva?
- Lo que Galton pidió que guardaran
En una feria de ganado gordo y aves de corral celebrada en Plymouth, en Inglaterra, los organizadores escogieron un buey y abrieron un concurso [1]. Por seis peniques, cada concursante compraba una tarjeta numerada y escribía cuánto pesaría el animal ya sacrificado y limpio, en canal [1]. Concursaron carniceros y ganaderos, algunos muy expertos, pero también gente que, según Galton, probablemente se guiaba por la información que pudo recoger y por su propia intuición [1].
Cuando las tarjetas ya habían cumplido su propósito, se las prestaron a Francis Galton para examinarlas. Descartó trece defectuosas o ilegibles y le quedaron 787 [1]. Leídos uno por uno, 787 números no dicen nada. Así que hizo lo primero que hace cualquiera que describe datos: los ordenó de menor a mayor.
Luego buscó el del medio. La estimación central de la multitud fue 1.207 libras; el buey en canal pesó 1.198, unos 543 kilos [1].
La multitud se pasó por 9 libras: el 0,8 % del peso [1].
Galton no se quedó con ese único número. Publicó en la revista Nature, en marzo de 1907, la lista resumida en una tabla, los cuartos de la distribución y un diagrama [1]. Y anotó un detalle que el número del medio escondía: las estimaciones no se repartían de forma simétrica [1].
Ordenar, resumir con pocas cifras, mirar la forma y dibujar. Eso es la estadística descriptiva.
¿Qué es la estadística descriptiva?
La estadística descriptiva es el conjunto de métodos para ordenar, resumir y mostrar los datos que ya se recogieron. Usa tablas que cuentan cuántas veces aparece cada valor, unas pocas medidas, como el promedio, y gráficos. Su respuesta es siempre sobre esos datos: qué hay, cuánto se repite, dónde se concentra y qué tan disperso está.
El MIT (Instituto Tecnológico de Massachusetts) publica en su portal abierto, OpenCourseWare, un curso de introducción a la probabilidad y la estadística. Allí el punto de partida se describe sin adornos: «Los datos crudos suelen tomar la forma de una lista, una matriz o una base de datos masivas de etiquetas y números» [2]. Para darles sentido, sigue el curso, se calculan estadísticos de resumen como la media, la mediana y el rango intercuartílico (cuánto se extiende la mitad central de los datos), y se dibujan gráficos como histogramas [2].
El libro abierto OpenIntro Statistics precisa qué es uno de esos estadísticos de resumen: «un solo número que resume una gran cantidad de datos» [3]. La palabra que importa es resume. Un resumen siempre deja algo por fuera, y la mitad del oficio consiste en saber qué.
¿Para qué sirve la estadística descriptiva?
La estadística descriptiva sirve para entender un conjunto de datos antes de hacer cualquier otra cosa con él. Permite saber qué valor es típico, cuánto varían los datos, si hay valores raros y si la tabla trae errores de captura. En las notas del curso del MIT se le asignan dos funciones: comunicar los datos y explorarlos para ver su estructura [2].
En el trabajo diario eso se traduce en preguntas muy concretas. ¿Cuántos clientes compraron una sola vez? ¿El tiempo de espera típico es de cinco minutos o de veinte? ¿Hay registros con edades imposibles? Ninguna de esas preguntas necesita fórmulas avanzadas. Sí necesita método.
La estadística descriptiva es el primero de los cuatro bloques que recorre la estadística para ciencia de datos: después vienen la probabilidad, la inferencia y los modelos. Y dentro del proceso completo de revisar datos hasta una conclusión, que se explica en la guía de análisis de datos, ocupa la etapa de exploración.
El flujo de la estadística descriptiva en cuatro pasos
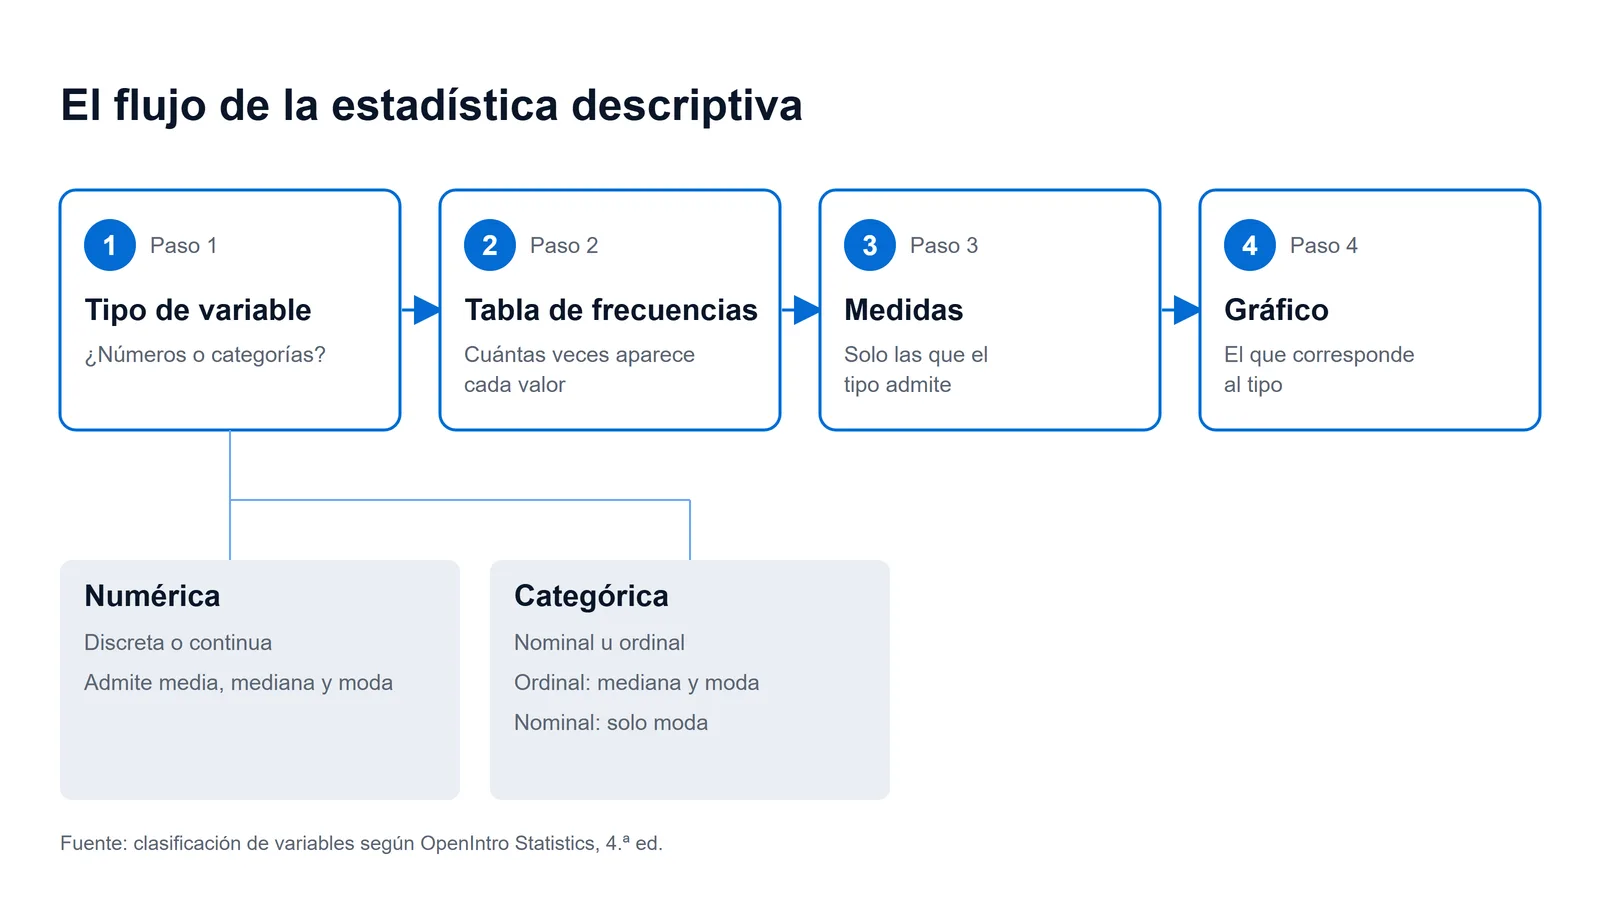
El flujo descriptivo tiene cuatro pasos y el orden no es negociable. Primero se identifica el tipo de variable y después se cuenta con una tabla de frecuencias. Luego se calculan las medidas que ese tipo admite y, al final, se dibuja el gráfico. Es una opinión mía: saltarse el primer paso suele ser una causa de resúmenes equivocados.
- Identificar el tipo de variable. ¿Los valores son números que se pueden sumar o son categorías?
- Contar con una tabla de frecuencias. Cuántas veces aparece cada valor y qué porcentaje del total representa.
- Calcular las medidas que el tipo admite. Centro, dispersión y forma, pero solo las que tienen sentido para esa variable.
- Dibujar el gráfico. El que corresponde al tipo de variable y a la pregunta.
Paso 1: ¿qué tipo de variable tengo?
Una variable es cada característica que se registra de cada caso: la edad de una persona, el municipio de una empresa, el estrato de una vivienda. OpenIntro las divide en dos familias [3]. Las numéricas toman valores con los que tiene sentido sumar, restar o promediar. Las categóricas toman valores que son categorías, llamadas niveles [3].
Cada familia se parte en dos. Una variable numérica es discreta si solo da saltos, como el número de personas de un hogar, y continua si no tiene esos saltos, como una tasa de desempleo [3]. Una categórica es ordinal si sus niveles tienen un orden natural y nominal si no lo tienen [3].
La trampa está en los números que no son números. OpenIntro pone el ejemplo de los indicativos telefónicos: no son una variable numérica, porque su promedio, su suma o su diferencia no tienen un significado claro [3]. Un código postal, un número de cédula o un código de respuesta de una encuesta están en la misma situación.
Paso 2: la tabla de frecuencias
La tabla de frecuencias cuenta cuántas veces aparece cada valor. Es la forma más honesta de resumir una variable categórica, porque no inventa nada: solo cuenta. Suele llevar dos columnas: la frecuencia absoluta, que es el conteo, y la frecuencia relativa, que es ese conteo como porcentaje del total.
Para una variable numérica con muchos valores distintos, la tabla agrupa los valores en intervalos. Esa tabla agrupada es la que después se dibuja como un histograma. Galton resumió sus 787 tarjetas de otra manera: anotó el valor que ocupaba cada posición de la lista ordenada, de cinco en cinco por ciento [1].
Contar parece trivial, y por eso se hace mal. Antes de calcular porcentajes hay que decidir el denominador: el total de casos o solo los que tienen dato. El ejemplo del DANE, más abajo, muestra cuánto cambia la cifra.
Paso 3: las medidas de centro, dispersión y forma
Las medidas resumen la distribución en pocas cifras. Las de centro dicen cuál es el valor típico. El manual de estadística del NIST (el Instituto Nacional de Estándares y Tecnología de Estados Unidos) define tres [4]. La media es la suma de los datos dividida por cuántos son. La mediana deja la mitad de los datos por debajo y la mitad por encima. La moda es el valor que más se repite [4].
Las de dispersión dicen cuánto se alejan los datos de ese centro, y las de forma dicen si la distribución es simétrica o se estira hacia un lado. Galton usó las tres ideas: un centro, los cuartos que encerraban la mitad central de las tarjetas y una advertencia sobre la asimetría [1].
No todas las medidas sirven para todas las variables. La moda funciona incluso con categorías sin orden; la mediana necesita que los valores se puedan ordenar; la media necesita números que se puedan sumar. Cada medida tiene su detalle, sus fórmulas y sus casos; esta página se queda con la regla de cuál corresponde a cada tipo de variable.
Paso 4: el gráfico
El gráfico es la prueba de que el resumen no está mintiendo. OpenIntro resume una variable categórica con tablas y gráficos de barras, y una numérica con histogramas y diagramas de caja [3]. Cómo escoger entre ellos según la pregunta se explica en la guía de tipos de gráficos. El diseño del gráfico como pieza de comunicación tiene su propia guía: visualización de datos.
Ejemplo de estadística descriptiva con microdatos del DANE
Los microdatos son las respuestas de una encuesta registro por registro, antes de que nadie las resuma. El DANE (Departamento Administrativo Nacional de Estadística, el productor de las estadísticas oficiales del país) publica gratis los de varias encuestas [5]. Una es la Encuesta Nacional de Calidad de Vida, la ECV, que mide las condiciones de vida de los hogares [5][6].
Descargué el módulo «Datos de la vivienda» de la ECV 2025: 86.848 viviendas encuestadas, una por fila [5]. Escogí una variable que casi todo colombiano conoce: el estrato que trae el recibo de la energía. Es la categoría de 1 a 6 con la que se cobran las tarifas, de bajo-bajo a alto, según las instrucciones de la propia encuesta [5].
Paso 1, el tipo de variable. El estrato es una variable categórica ordinal: sus niveles tienen orden, de bajo-bajo a alto, pero no son cantidades. El estrato 4 no es «el doble» del 2. Aun así, viene guardado como número. Y el diccionario de la encuesta trae tres códigos que no son estratos [5]:
- 0: el recibo no trae estrato o el servicio es «pirata», es decir, de conexión ilegal.
- 8: la vivienda tiene planta eléctrica propia.
- 9: la persona no conoce el estrato y no tiene un recibo a mano.
Paso 2, la tabla de frecuencias. De las 86.848 viviendas, 2.961 no tienen energía eléctrica y no responden la pregunta [5]. Quedan 83.887 con algún código. Este es el conteo, calculado con los microdatos:
| Código | Qué significa | Viviendas | % de las 83.887 |
|---|---|---|---|
| 0 | Sin estrato en el recibo o conexión ilegal | 2.961 | 3,5 % |
| 1 | Estrato 1 (bajo-bajo) | 41.507 | 49,5 % |
| 2 | Estrato 2 (bajo) | 24.153 | 28,8 % |
| 3 | Estrato 3 (medio-bajo) | 7.943 | 9,5 % |
| 4 | Estrato 4 (medio) | 2.053 | 2,4 % |
| 5 | Estrato 5 (medio-alto) | 715 | 0,9 % |
| 6 | Estrato 6 (alto) | 417 | 0,5 % |
| 8 | Planta eléctrica | 3.330 | 4,0 % |
| 9 | No sabe y no tiene recibo | 808 | 1,0 % |
Fuente: cálculo propio con los microdatos de la ECV 2025 del DANE [5]. Los conteos coinciden con las frecuencias que publica el diccionario de datos de la encuesta [5]. Son conteos de la muestra, sin ponderar.
Paso 3, las medidas. Aquí aparece el error. Este código, escrito con el módulo statistics que trae Python, calcula las medidas dos veces: primero con todos los códigos y después solo con los estratos de verdad [7].
import csv
import statistics
from collections import Counter

# Microdatos de la ECV 2025 (DANE), módulo «Datos de la vivienda»
with open("Datos de la vivienda.csv", encoding="utf-8", newline="") as f:
    filas = list(csv.DictReader(f, delimiter=";"))

# P8520S1A1 = estrato para tarifa de energía; vacío = vivienda sin energía
codigos = [int(r["P8520S1A1"]) for r in filas if r["P8520S1A1"] != ""]
print("Viviendas encuestadas:", len(filas), "| con dato de estrato:", len(codigos))

# Paso 2: tabla de frecuencias de los códigos tal como vienen
conteo = Counter(codigos)
for codigo in sorted(conteo):
    print(codigo, conteo[codigo], f"{conteo[codigo] / len(codigos):.1%}")

# El error: resumir todos los códigos (0, 8 y 9 no son estratos)
print("Promedio ingenuo:", round(statistics.mean(codigos), 2))
print("Mediana ingenua:", statistics.median_low(codigos))

# Lo correcto: quedarse solo con los estratos 1 a 6
estratos = [c for c in codigos if 1 <= c <= 6]
print("Viviendas con estrato 1 a 6:", len(estratos))
print("Moda:", statistics.mode(estratos))
print("Mediana:", statistics.median_low(estratos))
print("Promedio de los estratos 1 a 6:", round(statistics.mean(estratos), 2))
Las últimas líneas de la salida son estas:
Promedio ingenuo: 1.93
Mediana ingenua: 1
Viviendas con estrato 1 a 6: 76788
Moda: 1
Mediana: 1
Promedio de los estratos 1 a 6: 1.67
El promedio ingenuo sale casi tres décimas más alto. Trata la planta eléctrica como un estrato 8 y el «no sabe» como un estrato 9; el código 0 tira en sentido contrario, pero pesa menos. La mediana no se movió: es una medida robusta, que los valores extremos casi no afectan, como explica OpenIntro [3]. Para el estrato uso median_low, que según la documentación de Python devuelve siempre un valor que está en los datos, y la moda, que admite datos discretos o nominales [7].
Paso 4, el gráfico. Con la tabla ya limpia, lo que corresponde es un gráfico de barras con los seis estratos en orden. Mostraría lo que la tabla ya deja ver: más de la mitad de las viviendas encuestadas con estrato está en el 1.
Diferencia entre estadística descriptiva e inferencial
La estadística descriptiva habla de los datos que se tienen. La estadística inferencial usa esos datos para decir algo, con un margen de duda, sobre todos los casos que no se observaron. La primera resume lo observado. La segunda parte de una muestra para estimar cómo es la población, es decir, el total de casos que interesa. Esta tabla las compara criterio por criterio.
| Criterio | Estadística descriptiva | Estadística inferencial |
|---|---|---|
| Objetivo | Ordenar, resumir y mostrar los datos recogidos para entender su estructura [2] | Sacar conclusiones sobre el mundo, a menudo sobre los parámetros de un modelo [2] |
| Datos que usa | Los datos observados; un estadístico es cualquier cosa que se calcule con ellos [2] | La muestra más un modelo de cómo se generaron los datos [2] |
| Qué afirma | Lo que hay en la muestra: «más de la mitad de las viviendas encuestadas con estrato está en el 1» | Lo que probablemente hay en la población, siempre con afirmaciones de probabilidad [2] |
| Qué riesgo corre | Perder información al reducir los datos a pocas cifras [4] | Que otra muestra dé otro resultado, o escoger un modelo equivocado [3][4] |
| Ejemplo con la ECV 2025 | El 50,9 % de las viviendas encuestadas está en cabeceras municipales [5] | El DANE estima 14.695 miles de viviendas en cabeceras, de 18.894 miles en total [6] |
| Herramientas típicas | Tablas de frecuencias, media, mediana, rango intercuartílico, histogramas [2] | Estimaciones por intervalo y pruebas de hipótesis [4] |
La fila del ejemplo es la que más enseña. La muestra de la ECV está casi partida en mitades entre cabeceras y el resto (centros poblados y rural disperso): 44.189 viviendas frente a 42.659, según el diccionario de datos [5]. Pero según la tabla de su boletín, el DANE estima que en las cabeceras está cerca del 78 % de las viviendas del país [6]. Una cosa es cómo se compone la muestra; otra, cómo es Colombia.
Hice la prueba con los mismos microdatos. Al ponderar cada vivienda por su factor de expansión, el peso que dice a cuántas viviendas del país representa, la suma da los mismos 14.695 y 4.199 miles del boletín [5][6]. Ese paso ya es inferencia. Por eso ningún porcentaje de la tabla de estratos de arriba debe leerse como «el porcentaje de Colombia».
El NIST describe el salto con precisión. El valor calculado con todos los datos posibles, no solo con los de la muestra, es el parámetro de la población. El que se calcula con la muestra es una estimación puntual [4]. Y advierte que muestras distintas de la misma población generan medias distintas [4]. Medir esa variación ya no es tarea de la estadística descriptiva.
Errores típicos al resumir datos
Los errores típicos al resumir datos casi nunca son de cálculo: el programa suma bien. Son de criterio, y se cometen antes de pulsar la tecla. Estos seis aparecen una y otra vez, y cada uno tiene un remedio sencillo.
- Promediar códigos. Es el error del ejemplo: tratar como número lo que es una etiqueta. Antes de calcular una media, lea el diccionario de datos y pregúntese si sumar esos valores tiene sentido [3].
- Tratar una variable ordinal como si fuera numérica. El estrato tiene orden, pero un «estrato promedio de 1,67» es una cifra difícil de interpretar. Con variables ordinales, la mediana y la tabla de frecuencias se leen sin esa ambigüedad.
- Cambiar el denominador sin avisar. El estrato 1 pesa 49,5 % si se cuentan los códigos especiales y 54,1 % si solo se cuentan los estratos 1 a 6 [5]. Las dos cifras son correctas. Lo incorrecto es no decir cuál se usó.
- Reportar la media cuando hay valores extremos. La media y la desviación estándar se dejan arrastrar por las observaciones extremas; la mediana y el rango intercuartílico casi no [3]. En ingresos o precios, esa diferencia puede cambiar la conclusión.
- Quedarse con un solo número. El manual del NIST habla de las técnicas clásicas que convierten todos los datos en unas pocas cifras, y dice que eso es «a la vez una virtud y un vicio» [4]. La virtud es el foco; el vicio, que esas cifras pueden filtrar la asimetría o las colas largas [4]. Por eso Galton publicó también su tabla y su diagrama [1].
- Leer la muestra como si fuera la población. Es el error de la fila del ejemplo en la tabla anterior. La muestra de la ECV tiene proporciones muy distintas a las del país, y son los factores de expansión los que la devuelven a escala [5][6].
¿Con qué herramienta se hace la estadística descriptiva?
La estadística descriptiva se puede hacer con una hoja de cálculo, con un lenguaje de programación o a mano, si los datos son pocos. La herramienta importa menos que el flujo: ninguna corrige sola un código mal leído.
En una hoja de cálculo, las fórmulas y las tablas dinámicas cubren el conteo y las medidas básicas; la guía de Excel para análisis de datos muestra cómo encadenarlas. En Python, el módulo statistics viene incluido en el lenguaje desde la versión 3.4. Su documentación aclara que no compite con bibliotecas especializadas: apunta al nivel de una calculadora científica o graficadora [7].
Para tablas grandes, el método describe() de pandas resume cada columna numérica [8], y si el estrato viene guardado como número le calcula el promedio sin preguntar. Cómo usar pandas para estos resúmenes se explica en la guía de Python para análisis de datos.
Lo que Galton pidió que guardaran
Al final de su nota de 1907, Galton hizo una petición. Sugirió que las ferias de ganado más importantes prestarían un servicio a la estadística si se acostumbraran a guardar los juegos de tarjetas de esos concursos [1]. Y añadió que las tarjetas numeradas permitían comprobar si un juego estaba completo [1].
No pedía el resultado. Pedía los datos crudos, contados y con su número.
Es una opinión, pero la sostengo: en Colombia el problema ya no es el acceso a los datos, sino el paso 1. Los microdatos de la ECV están abiertos y gratis, con un diccionario que explica qué significa cada código [5]. Esa apertura vale poco si quien los descarga promedia el código de la planta eléctrica como si fuera un estrato. El método no cuesta nada. ¿Cuántos informes que circulan con un «estrato promedio» pasaron por el paso 1?
Preguntas frecuentes
¿Cuáles son las medidas de la estadística descriptiva? Se agrupan en tres familias. Las de tendencia central, como la media, la mediana y la moda, indican el valor típico [4]. Las de dispersión, como el rango intercuartílico o la desviación estándar, miden cuánto se separan los datos de ese valor [2][3]. Las de forma describen si la distribución es simétrica o tiene una cola más larga hacia un lado [3].
¿La estadística descriptiva sirve para hacer predicciones? No por sí sola. Describe lo que ya ocurrió en los datos que se tienen. Para pronosticar hace falta un modelo y una forma de medir su error, y eso pertenece a la inferencia y a los modelos estadísticos [2]. Una buena exploración, eso sí, ayuda a ver qué modelo tiene sentido probar: el manual del NIST dice que sus técnicas sugieren cuál debería ser el modelo apropiado [4].
¿Se puede usar estadística descriptiva con datos de una muestra? Sí, y es lo más común. La descripción vale para los casos de la muestra, como las 86.848 viviendas de la ECV 2025 [5]. Lo que no se puede es leer esos porcentajes como si fueran del país sin aplicar los métodos de la inferencia.
¿Qué es un análisis descriptivo de datos? Es el trabajo de aplicar la estadística descriptiva a un conjunto de datos concreto, de principio a fin. Se revisan los tipos de variable, se cuenta, se calculan las medidas que cada tipo admite y se grafica. El resultado es un retrato de esos datos, útil para comunicarlos y para explorar su estructura [2]. El análisis de datos como proceso completo, con sus etapas, es más amplio.
¿Qué diferencia hay entre una variable ordinal y una nominal? Las dos son categóricas, pero solo la ordinal tiene un orden natural entre sus niveles [3]. El estrato es ordinal: el 3 está entre el 2 y el 4. El departamento de residencia es nominal: ningún orden entre Santander y Nariño tiene sentido estadístico. Por eso a la ordinal se le puede sacar mediana y a la nominal solo moda.
Referencias
Las citas en otro idioma son traducción propia.
- Francis Galton. Vox Populi, Nature, vol. 75, n.º 1949, 7 de marzo de 1907, pp. 450-451 — concurso de estimación del peso de un buey gordo en la West of England Fat Stock and Poultry Exhibition, celebrada en Plymouth; tarjetas de seis peniques con la estimación del peso «after it had been slaughtered and “dressed”»; entre los competidores, carniceros y ganaderos, algunos «highly expert», y otros guiados «by their own fancies»; cerca de 800 tarjetas; descartadas 13 «defective or illegible», quedaron 787, ordenadas «in order of the magnitudes of the estimates»; estimación central («middlemost») de 1.207 libras frente a un peso en canal de 1.198 libras: «9 lb., or 0·8 per cent. of the whole weight too high»; tabla de la distribución con el valor de cada posición de la lista ordenada de 5° en 5° (de 5 a 95 sobre 100), con primer y tercer cuartil (1.162 y 1.236 libras) y diagrama; «they were not scattered symmetrically»; al cierre, la sugerencia de que las autoridades de las ferias preserven los juegos de tarjetas para análisis estadístico y la nota de que, por estar numeradas, se puede comprobar si un juego está completo. Leído en el facsímil del artículo (escaneo de las dos páginas); la conversión a kilos es cálculo propio (1.198 × 0,4536). Nature: Vox Populi, DOI 10.1038/075450a0 · galton.org: facsímil de Vox Populi — Consultada: 2026-11-07.
- Jeremy Orloff y Jonathan Bloom. Introduction to Statistics, Reading 10a, curso 18.05 Introduction to Probability and Statistics, MIT OpenCourseWare, primavera de 2022 — tres fases de la práctica estadística: recoger, describir y analizar datos; §2.2 Descriptive statistics: «Raw data often takes the form of a massive list, array, or database of labels and numbers»; estadísticos de resumen como la media, la mediana y el rango intercuartílico, y gráficos como histogramas, diagramas de dispersión y la función de distribución empírica, útiles «for both communicating and exploring the data»; §2.3 Inferential statistics: «Ultimately we want to draw inferences about the world», a menudo especificando un modelo estadístico; «our statistical evidence will always involve probability statements»; §2.4: «A statistic is anything that can be computed from the collected data». MIT OpenCourseWare: 18.05, Reading 10a — Consultada: 2026-11-07.
- David Diez, Mine Çetinkaya-Rundel y Christopher D. Barr. OpenIntro Statistics, cuarta edición (2019, actualizada el 21 de octubre de 2022) — §1.1: «A summary statistic is a single number summarizing a large amount of data»; §1.2: variables numéricas (discretas y continuas) y categóricas (nominales y ordinales), con niveles; los indicativos telefónicos no se clasifican como numéricos porque «the average, sum, and difference of area codes doesn’t have any clear meaning»; §2.1.6: «The median and IQR are called robust statistics because extreme observations have little effect on their values», mientras la media y la desviación estándar «are more heavily influenced»; asimetría y colas largas en §2.1; §2.2: tablas de contingencia y gráficos de barras para datos categóricos; §2.1: histogramas y diagramas de caja para datos numéricos; §2.3: en la inferencia estadística «we might choose the wrong model». OpenIntro: OpenIntro Statistics — Consultada: 2026-11-07.
- NIST/SEMATECH. e-Handbook of Statistical Methods, capítulo 1, Exploratory Data Analysis — §1.1.2.5 Data Treatment: las técnicas clásicas de estimación toman todos los datos y los convierten «into a few numbers (“estimates”). This is both a virtue and a vice»; la virtud es enfocarse en características importantes como la localización y la variación; el vicio, que pueden filtrar otras «(skewness, tail length, autocorrelation, etc.)»; §1.3.5.1 Measures of Location: definiciones de media, mediana y moda; §1.3.5 Quantitative Techniques: el valor del parámetro con todos los datos posibles es el parámetro de la población; el estimado con la muestra es una estimación puntual; «different samples from the same population will generate different values for the sample mean»; dos grandes categorías: estimación por intervalos y pruebas de hipótesis. §1.1.2.4 Rigor: las técnicas exploratorias son «very suggestive, indicative, and insightful about what the appropriate model should be». NIST: Data Treatment, §1.1.2.5 · NIST: Rigor, §1.1.2.4 · NIST: Measures of Location, §1.3.5.1 · NIST: Quantitative Techniques, §1.3.5 — Consultada: 2026-11-07.
- Departamento Administrativo Nacional de Estadística (DANE). Encuesta Nacional de Calidad de Vida – ECV – 2025, catálogo de microdatos (COL-DANE-ECV-2025), archivo «DBF-ECV-Datos_vivienda-2025» (fecha 21/04/2026) y diccionario de datos — 86.848 casos en el archivo «Datos de la vivienda»; variable P8520S1A1 «Estrato para tarifa», con frecuencias 0 = 2.961, 1 = 41.507, 2 = 24.153, 3 = 7.943, 4 = 2.053, 5 = 715, 6 = 417, 8 = 3.330 y 9 = 808, y 2.961 viviendas sin energía eléctrica; instrucciones al encuestador: «si los recibos vienen sin estrato o el servicio es pirata escriba 0; si la vivienda tiene planta eléctrica, escriba código 8 y si la persona no conoce el estrato del servicio y no cuenta con un recibo de pago escriba 9», y equivalencias de bajo-bajo = 1 a alto = 6; variable CLASE: cabecera = 44.189 y centros poblados y rural disperso = 42.659; FEX_C = factor de expansión; condición de acceso: «El acceso a los microdatos anonimizados de uso público es de carácter gratuito». Tablas de frecuencias, medias y sumas ponderadas: cálculo propio con Python. DANE: microdatos de la ECV 2025 · DANE: diccionario de datos de la ECV 2025 — Consultada: 2026-11-07.
- Departamento Administrativo Nacional de Estadística (DANE). Boletín técnico Encuesta Nacional de Calidad de Vida (ECV) 2025, 20 de abril de 2026 — objetivo de la encuesta: obtener información que permita analizar y comparar las condiciones socioeconómicas de los hogares; Tabla 1, viviendas en miles: total 18.894, cabecera 14.695, centros poblados y rural disperso 4.199. DANE: Boletín técnico ECV 2025 — Consultada: 2026-11-07.
- Python Software Foundation. statistics — Mathematical statistics functions, documentación de Python 3.11 — módulo nuevo en la versión 3.4; «It is aimed at the level of graphing and scientific calculators»;
mode: «Return the single most common data point from discrete or nominal data»;median_low: «The low median is always a member of the data set», y «Use the low median when your data are discrete». El código de esta página se ejecutó con Python 3.11.15. Python 3.11: módulo statistics — Consultada: 2026-11-07. - pandas development team. pandas.DataFrame.describe, documentación de pandas 3.1.1 — «Generate descriptive statistics»; resume la tendencia central, la dispersión y la forma de la distribución de cada columna; «By default only numeric columns are analyzed»; para columnas numéricas, el resultado incluye «count, mean, std, min, max» y los percentiles pedidos. pandas: DataFrame.describe — Consultada: 2026-11-07.
Cómo investigamos esta página
- Pregunta que responde: Qué es la estadística descriptiva, en qué orden se hace y en qué se diferencia de la inferencial.
- Fuentes: identificadas 22 → incluidas 8
- Criterios de inclusión: un artículo de 1907, un libro de texto abierto, un curso del MIT, el manual del NIST, microdatos y boletín del DANE y documentación oficial de Python y pandas.
- Fecha de corte de los datos: 2026-11-07